안녕하세요~ 오늘은 thread 묶음인 block 안에서 memory를 같이 쓰는 이야기를 해보려고 해요ㅎㅎ
먼저 자리를 좀 잡고 갈게요. GPU에서 실행되는 함수가 kernel이고, 그 kernel을 실행하는 작업 단위가 thread예요. 한 번에 실행하도록 요청한 block 전체는 grid라고 불러요. Thread들은 block으로 묶여서 배치되고, block 하나는 GPU의 실행 장치인 SM(Streaming Multiprocessor) 하나에서 끝까지 실행돼요.
이 thread들이 쓰는 memory를 보면, 모든 thread가 접근할 수 있는 큰 global memory가 있고 SM 안에서 같은 block끼리 함께 쓰는 작은 shared memory가 있어요. Shared memory 쪽이 훨씬 빠르긴 한데요. 어떤 데이터를 언제 올리고 비울지는 kernel 코드에서 직접 정해줘야 한답니다. Hardware가 알아서 채워주는 cache1처럼 두고 쓰면 되는 건 아니에요.
그 수고를 들이는 이유는 재사용이에요. Global memory에서 한 번 읽은 데이터를 block 안에서 여러 번 쓸 수 있거든요. 다만 같이 쓰기 시작하면 순서도 맞춰야겠죠? 쓰기와 읽기를 맞추는 barrier2, 같은 저장 장치에 접근이 몰릴 때의 bank conflict3, block이 커져 SM에 올릴 thread가 줄어드는 occupancy4 문제까지 따라와요.
빠른 memory 하나 썼을 뿐인데 챙길 일이 제법 생기네요..ㅎㅎ
두 행렬의 행과 열을 곱해 더하는 행렬곱, 행과 열을 뒤바꾸는 transpose, 여러 값을 하나로 합치는 reduction을 보면서 이 문제들이 코드 어디에서 나오는지 짚어볼게요. 우선 shared memory에 올릴 데이터도 global memory에서 잘 읽어와야 하니, 그쪽부터 시작해요.
Global Memory와 Coalescing
GPU는 thread를 32개씩 묶어서 같은 명령을 실행해요. 이 묶음이 warp이고, 그 안의 thread 자리가 lane이랍니다. Warp가 global memory를 읽을 때면 32개 lane이 저마다 읽을 주소를 내놓는데요.
Memory 쪽에서는 필요한 byte5만 낱개로 보내주지 않아요. Sector라는 32바이트 덩어리로 보내요. 경계도 주소 0부터 32바이트 간격으로 정해져 있어서, 그중 1바이트만 필요해도 sector 하나를 통째로 받아야 해요. 조금만 쓰고 나머지는 남기면 아깝겠죠ㅎㅎ
여러 lane의 접근을 가능한 적은 sector 전송으로 모으는 걸 coalescing이라고 해요. 그래서 global memory 접근 비용을 볼 때는 lane이 몇 개인지보다 서로 다른 sector를 몇 개 건드렸는지 보셔야 해요.
float6 하나는 4바이트예요. 32개 lane이 연속된 float 32개를 읽으면 필요한 범위가 128바이트이고, 시작 주소가 sector 경계인 32의 배수에 맞으면 sector 4개로 끝나요.
그런데 시작점을 float 하나만큼만 옮겨볼까요? 같은 128바이트가 경계 하나를 더 걸쳐서 sector가 5개 필요해져요. Lane 사이 간격을 32바이트 이상 벌리면 각자 다른 sector를 건드리니 32개까지 늘어나고요. 쓸 데이터는 세 경우 모두 128바이트인데, 실제 전송량은 128, 160, 1024바이트로 달라진답니다.

cudaMalloc7이 돌려주는 pointer, 즉 메모리 주소는 충분히 정렬돼 있어요. 여기서 정렬은 시작 주소가 일정 크기의 배수에 맞는다는 뜻이에요. 다만 그 pointer에 시작점에서 떨어진 거리인 offset을 더해서 부분 영역을 만들면 시작 주소가 어긋날 수 있으니 그때는 다시 봐주셔야 해요.
참, sector 4개라는 숫자에도 조건이 붙어요. Lane 32개가 float를 하나씩 읽는 경우예요. Lane 수나 데이터 폭이 달라지면 최소 sector 수도 함께 달라진답니다.
Shared Memory와 Tiling
이제 행렬곱 $C = A \times B$로 넘어가볼게요. $C$의 원소 하나를 계산하려면 $A$의 한 행과 $B$의 한 열을 읽어야 하죠. 가장 단순하게는 thread 하나에 $C$ 원소 하나를 맡기고, 필요한 값을 그때그때 global memory에서 가져오면 돼요. 아래 코드의 함수 표시와 자료형8, 행렬을 일렬로 저장한 주소 계산9도 함께 봐주세요.
__global__ void matmul_naive(const float* A, const float* B, float* C, int N) {
    int row = blockIdx.y * blockDim.y + threadIdx.y;
    int col = blockIdx.x * blockDim.x + threadIdx.x;
    float acc = 0.0f;
    for (int k = 0; k < N; k++)
        acc += A[row * N + k] * B[k * N + col];
    C[row * N + col] = acc;
}
코드의 threadIdx는 block 안에서의 thread 번호, blockIdx는 grid 안에서의 block 번호예요. blockDim은 block 한 변의 thread 수고요. 안쪽 반복문이 한 바퀴 돌 때마다 thread는 8바이트를 읽어서 곱셈과 덧셈, 두 번의 연산을 해요.
그런데 $A$의 같은 행은 $C$의 같은 행에 있는 $N$개 원소를 계산할 때 계속 필요해요. 이대로면 이미 읽었던 값을 global memory에서 또 가져오게 되는 거예요. 자주 쓸 걸 알면서 매번 가지러 가네요..ㅎㅎ
이 재사용을 shared memory에서 직접 관리하는 방법이 tiling이에요. 행렬을 $T \times T$ 크기로 나눈 정사각 조각을 tile이라고 부르는데요. Block의 thread들이 힘을 나눠서 $A$와 $B$의 tile 하나씩을 shared memory에 복사해둬요.
그 tile로 만들 수 있는 부분곱을 모두 누적한 다음에 다음 tile을 가져오는 식이에요. 덕분에 tile 원소 하나를 global memory에서 한 번 읽고, shared memory에서는 $T$번 재사용할 수 있답니다.

코드에서는 tile 크기를 T로 정하고 2차원 shared memory 배열을 선언해요.10
#define T 32

__global__ void matmul_tiled(const float* A, const float* B, float* C, int N) {
    __shared__ float As[T][T];
    __shared__ float Bs[T][T];

    int row = blockIdx.y * T + threadIdx.y;
    int col = blockIdx.x * T + threadIdx.x;
    float acc = 0.0f;

    for (int t = 0; t < N / T; t++) {
        As[threadIdx.y][threadIdx.x] = A[row * N + (t * T + threadIdx.x)];
        Bs[threadIdx.y][threadIdx.x] = B[(t * T + threadIdx.y) * N + col];
        __syncthreads();

        for (int k = 0; k < T; k++)
            acc += As[threadIdx.y][k] * Bs[k][threadIdx.x];
        __syncthreads();
    }
    C[row * N + col] = acc;
}
__shared__는 이 변수를 shared memory에 두겠다는 선언이에요. 중간에 두 번 나오는 __syncthreads()도 봐주세요. Block의 모든 thread가 이 줄에 도착할 때까지 먼저 온 thread를 기다리게 하는 barrier예요.
첫 번째는 아직 다른 thread가 채우지도 않은 tile을 읽지 않도록, 두 번째는 다른 thread가 읽는 중인 tile에 다음 데이터를 덮어쓰지 않도록 기다려요. 먼저 끝났다고 혼자 다음 일을 시작하면 곤란하겠죠? ^^;;
Barrier에 참여하는 조건도 맞춰야 해요. Block의 일부 thread가 먼저 return하고 나머지만 __syncthreads()에 도착하면 실행이 정의되지 않아요. 여기서는 $N$이 $T$의 배수라 모두 같은 흐름을 지나는데요. 임의 크기를 받으려면 경계 밖 thread도 return시키지 말고 반복문과 barrier에 참여시켜주세요. 읽는 값은 0으로 채우고, 마지막 C 저장에만 범위 검사를 걸면 돼요.
얼마나 재사용하는지는 arithmetic intensity로 계산해볼 수 있어요. Global memory에서 읽은 바이트당 연산을 몇 번 했는지 나타내는 값이에요. 연산 한 번의 단위는 FLOP(Floating-Point Operation), 바이트당 연산 횟수는 FLOP/B라고 적어요. Block 하나가 tile 쌍을 $N/T$번 가져오면 읽는 양은 $8NT$바이트예요. $T^2$개 thread가 각각 $2N$번 연산하니, 둘을 나눠볼게요.
$$ I_{\text{tiled}} = \frac{2NT^2}{8NT} = \frac{T}{4}\ \text{FLOP/B} $$$T = 32$를 넣으면 8 FLOP/B가 나와요. Tile 없이 매번 읽던 0.25 FLOP/B와 비교하면 32배예요. 가져온 값 하나를 여러 번 쓰는 효과가 숫자로도 보이네요ㅎㅎ Tile을 복사할 때는 행 방향의 연속된 주소를 읽으니, 앞에서 본 coalescing 조건도 만족해요.
Bank Conflict
Shared memory에 가져왔으니 이제 편하게 읽으면 될까요~ 그런데 여기에도 접근이 몰리는 자리가 있어요.
Shared memory는 bank라는 독립된 저장 장치 32개로 나뉘어요. 연속된 4바이트 word11를 bank 0, 1, …, 31, 0, 1, … 순서로 배정하는 구조예요. Warp의 32개 lane이 서로 다른 bank에 접근하면 한 번에 처리할 수 있지만, 같은 bank의 서로 다른 주소에 몰리면 차례로 처리해야 해요. 이렇게 $n$개 접근이 겹쳐 직렬화되는 게 $n$-way bank conflict랍니다.
여러 lane이 아예 같은 주소를 읽는 경우는 따로 봐야 해요. 그때는 값 하나를 모두에게 나눠주는 broadcast라서 conflict가 아니에요.
2차원 tile을 열 방향으로 읽을 때 이 conflict가 잘 드러나요. 행과 열을 뒤바꾸는 transpose를 보시면 되는데요. Global memory에서 행 방향으로 읽은 tile을 shared memory에 놓고, 열 방향으로 꺼내 쓰면 global memory의 읽기와 쓰기를 모두 coalescing할 수 있어요.
__shared__ float tile[32][32];

tile[threadIdx.y][threadIdx.x] = in[...];   // 행 방향 쓰기: bank 분산
__syncthreads();
out[...] = tile[threadIdx.x][threadIdx.y];  // 열 방향 읽기: 32-way conflict
문제는 그 열 방향 읽기예요. Lane들이 가져갈 tile[0][c], tile[1][c], ...는 32 word씩 떨어져 있어서 전부 bank c로 모여요. Bank는 32개나 있는데 한 군데에서 기다리게 생겼네요ㅠㅠ
주소 배치를 조금 바꿔서 이 겹침을 풀어볼게요. Padding과 swizzle, 두 방법이 있어요.
먼저 padding이에요. 행 길이를 32에서 33으로 늘려줘요. 그러면 열 방향으로 내려갈 때 bank 번호가 행마다 하나씩 어긋나서 같은 bank에 몰리지 않아요.
__shared__ float tile[32][33];
Lane마다 읽는 위치가 일정한 word 수만큼 떨어진 그 간격을 stride $S$라고 할게요. 이 경우를 식으로 적으면 conflict 차수는 $\gcd(S, 32)$예요. gcd는 두 정수를 모두 나누는 가장 큰 정수, 최대공약수라는 뜻이에요. Stride 32에서는 32-way, 33에서는 conflict가 없고, 2와 4에서는 각각 2-way와 4-way가 돼요.
Padding은 이렇게 stride와 bank 수의 공약수를 1로 만들어주는 방법이에요. 대신 행마다 4바이트씩 더 써야 한답니다. 한 칸 비워두는 데도 이유가 있었네요ㅎㅎ
두 번째는 swizzle이에요. 이번에는 저장할 열 번호에 행 번호를 XOR12해줄 거예요. Memory를 더 쓰지 않고도 bank 접근을 분산할 수 있어요.
__shared__ float tile[32][32];

tile[threadIdx.y][threadIdx.x ^ threadIdx.y] = in[...];   // 쓰기: bank 분산
__syncthreads();
out[...] = tile[threadIdx.x][threadIdx.y ^ threadIdx.x];  // 읽기도 분산
행 안의 열 위치를 XOR로 재배열하면 행 방향으로 접근할 때도, 열 방향으로 접근할 때도 32개 bank에 정확히 한 번씩 들어가요. 대신 index 계산이 한 번 들어가고, tile 폭은 2의 거듭제곱이어야 해요. 공간을 아낀 만큼 주소 계산 쪽에서 챙길 게 생기는 셈이에요.

Lane과 행·열의 대응 자체를 뒤집어서 shared memory 접근을 연속으로 만드는 방법도 떠올릴 수 있어요. 다만 그렇게 하면 global memory 접근이 다시 strided, 즉 연속 주소 사이를 일정 간격으로 건너뛰는 형태가 돼요. 여기서 기다리는 걸 해결해놓고 저쪽에서 더 읽게 되면.. 참 난감하죠. 두 memory의 접근을 같이 봐야 해요.
앞의 tiled 행렬곱은 이 문제가 없어요. Bs[k][threadIdx.x]는 행 방향으로 읽어서 bank가 분산되고, As[threadIdx.y][k]는 warp 안의 lane들이 같은 주소를 읽는 broadcast이기 때문이에요.
Occupancy와 Block 크기
Occupancy는 SM에 실제로 올라간 warp 수를, 그 SM이 동시에 올릴 수 있는 최대 warp 수로 나눈 값이에요. 한 warp가 global memory를 기다릴 때 같은 SM에 있는 다른 warp를 실행할 수 있어서, 올라온 warp가 많으면 그 기다림을 다른 작업으로 채울 여지가 생기죠.
얼마나 올릴 수 있는지는 thread 수, block 슬롯13, register, shared memory 가운데 먼저 부족해지는 자원이 정해요. 여기서 register는 thread가 계산 중인 값을 두는 SM 안의 가장 빠른 저장소랍니다.
Tiled 행렬곱에 $T = 32$를 넣으면 block 하나가 1024 thread예요. GPU의 CUDA hardware 기능 세대를 나타내는 번호를 compute capability라고 하는데요. Compute capability 8.9에서는 SM에 상주할 수 있는 thread가 최대 1536개라, 이 block을 하나 올리고 나면 두 번째는 들어갈 수 없어요.
결국 1536개 자리 중 1024개만 써서 occupancy가 66.7%가 돼요. $T = 16$이면 block당 256 thread라 여섯 block으로 1536개를 채울 수 있고요. 자리는 남았는데 block째로는 안 들어가네요..^^;;
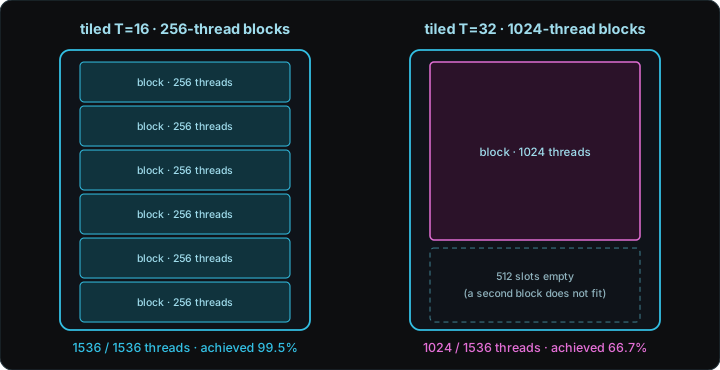
Tile을 키우면 재사용은 늘지만, block까지 커져 SM에 올릴 수 있는 병렬성이 줄어들어요. 그래서 재사용을 더 늘리고 싶을 때는 thread 하나가 $C$의 원소 여러 개를 register에 두고 누적하는 register tiling으로 이어져요. Block 크기만 계속 늘리는 데에는 한계가 있는 거죠.
참, occupancy를 실행 시간의 비율로 읽지는 말아주세요. SM이 고를 수 있는 warp 수의 상한을 보는 값이에요. Occupancy가 낮아도 warp마다 하는 일이 많으면 빠를 수 있답니다.
Warp Divergence
이번에는 같은 warp 안에서 갈 길이 달라지는 경우예요. Warp는 32개 lane에 같은 명령을 한 번에 발행, 즉 연산 장치에 실행하도록 보내는데, if 조건이 lane마다 다르면 일부는 참 경로로, 나머지는 거짓 경로로 가야 하죠. 이때 생기는 게 warp divergence예요.
Lane 번호를 $\ell \in \{0,\ldots,31\}$, 분기(branch), 즉 다음에 어느 코드 경로를 실행할지 정하는 조건을 $p_\ell$로 놓고, 참인 lane의 집합을 $A$, 거짓인 lane의 집합을 $B$로 적어볼게요.
$$ A = \{\ell \mid p_\ell = 1\}, \qquad B = \{\ell \mid p_\ell = 0\} $$두 집합이 모두 비어 있지 않으면 한 warp 안에서 갈 길이 나뉜 거예요. 아래 코드는 lane 번호로 딱 절반을 나눠요. 번호를 구하는 데 쓰는 &와 뒤에 나올 >>는 숫자의 bit를 다루는 연산이에요.14
int lane = threadIdx.x & 31;

if (lane < 16)
    A();
else
    B();
모든 warp에서 lane 015는 31은 A, lane 16B를 골라요. 두 경로를 동시에 실행할 수는 없으니, 먼저 lane 015만 켜고 31만 켜고 A를 실행한 뒤 lane 16B를 실행해요. 현재 명령의 결과를 쓸 lane을 표시하는 32비트 값이 active mask예요.
다 같이 들어왔는데 절반씩 차례를 기다리네요.
A와 B가 각각 $n_A$, $n_B$개의 warp 명령으로 컴파일, 즉 GPU가 실행할 명령으로 번역됐다고 해볼게요. 한 경로만 선택하면 그 구간에 $n_A$번 발행하면 되지만, 두 경로가 모두 선택되면 $n_A + n_B$번이 필요해요.
이 발행 횟수에 lane 수를 또 곱하지는 않아요. 16:16으로 갈리든 31:1로 갈리든, 두 경로의 길이가 같으면 발행되는 명령 수도 같답니다. 발행된 lane 자리 중 실제로 켜진 비율을 $\eta$로 두고 계산하면 이렇게 돼요.
$$ \eta = \frac{|A|n_A + |B|n_B} {32(n_A+n_B)} $$두 경로의 길이가 같아서 $n_A = n_B$이면 $\eta = 1/2$예요. 한쪽에 한 명만 남았다고 그 경로를 생략해줄 수는 없으니까요..ㅎㅎ
이 예제에서 divergence를 피하려면 warp 경계에 맞춰 조건을 나누면 돼요. 이번에는 lane이 아닌 warp 번호를 볼게요.
int warp = threadIdx.x >> 5;

if ((warp & 1) == 0)
    A();
else
    B();
짝수 warp는 32개 lane이 모두 A를, 홀수 warp는 모두 B를 선택해요. 각 warp 안에서는 조건이 같아졌죠? 서로 다른 warp끼리 다른 코드를 실행하는 건 divergence가 아니에요.
그런데 소스에 if가 있다고 실제 branch까지 꼭 생기는 건 아니에요. 본문이 짧으면 코드를 기계 명령으로 번역하는 compiler가 branch를 없애고 predicated instruction으로 바꾸기도 하거든요. Predication은 모든 lane에 명령을 한 번 발행하되, 조건이 참인 lane만 결과를 쓰게 하는 방식이에요.
float y = x;
if (lane < 16)
    y = 2.0f * x;
GPU 기계어인 SASS15로 보면 개념적으로는 아래와 같아요. 정확한 명령 이름이나 register는 연산 장치와 명령어 구성을 뜻하는 architecture와 compiler 버전에 따라 달라지니, 여기서는 조건을 만든 뒤 어떻게 쓰는지 봐주세요.
ISETP.LT ... P0, lane, 16
@P0 FMUL  y, x, 2.0
여기서는 warp가 두 경로로 갈라지지 않아요. FMUL을 한 번 발행하고, 조건의 참·거짓을 담는 predicate P0가 참인 lane만 결과를 써요. Branch divergence는 없지만 꺼진 lane이 그 명령에서 유효한 일을 하는 것도 아니고요.
Divergent branch와 predication 모두 켜진 lane의 비율을 낮출 수 있어요. 다만 실제로 경로를 나눠 실행했는지는 구분해야 한답니다. if만 보고 결론을 내리기에는 compiler도 하는 일이 있네요ㅎㅎ
Reduction
마지막으로 reduction을 볼게요. 배열 $N$개를 값 하나로 줄이는 연산이에요. 합, 최댓값, 평균이 여기 들어가고, ML(Machine Learning), 즉 데이터에서 규칙을 학습하는 계산의 kernel에서도 softmax16의 최댓값과 분모 합, layernorm17의 평균과 분산을 구할 때 계속 만나게 돼요.
트리처럼 접어가면 단계마다 절반의 thread가 두 값을 합쳐요. 단계 수는 $\log_2 N$이지만 총 덧셈은 여전히 $N - 1$개예요. 덧셈할 양은 그대로 두고 병렬로 처리해서 깊이를 줄이는 거죠.
다만 다음 단계로 갈 때는 앞 단계의 쓰기가 끝났어야 해요. 아래 네 버전은 이 동기화 비용을 어디까지 줄일 수 있는지 따라가보는 과정이랍니다.

기본 구조는 multi-pass예요. Block마다 shared memory에서 자기 몫의 부분합을 만든 뒤, 그 부분합 배열에 같은 kernel을 다시 실행해요. 값 하나가 남을 때까지 반복하는 거죠. 예를 들어 $2^{24}$개 입력을 block 256으로 처리하면 65,536개 → 256개 → 1개로, 세 번 실행하게 돼요.
버전 0은 트리 모양을 그대로 코드로 옮긴 형태예요. tid는 block 안의 thread 번호이고, buf는 shared memory에 올려둔 입력이에요.
for (int s = 1; s < blockDim.x; s *= 2) {
    if (tid % (2 * s) == 0)
        buf[tid] += buf[tid + s];
    __syncthreads();
}
이 코드는 두 군데에서 비용을 써요. 먼저 active lane이 흩어져 있어요. s = 1일 때는 짝수 번호, s = 2일 때는 4의 배수만 조건을 만족하죠. 일하는 lane이 16, 8, 4, …개로 줄어도 그 warp의 명령은 계속 발행해야 해요.
정수 나눗셈의 나머지를 구하는 % 연산도 남아 있어요. 제수인 2 * s가 반복마다 바뀌어서 compiler가 비트 연산으로 바꾸지 못하고, 나눗셈 명령 묶음이 남는 거예요. 더하는 코드는 짧은데 그 앞뒤로 일이 붙네요ㅠㅠ
버전 1에서는 일할 thread를 block 앞쪽에 연속으로 모아줄게요. Sequential addressing이라고 하는 방식이에요.
for (int s = blockDim.x / 2; s > 0; s >>= 1) {
    if (tid < s)
        buf[tid] += buf[tid + s];
    __syncthreads();
}
두 버전 모두 256개 원소를 여덟 단계로 줄여요. 단계 $j \in \{0,\ldots,7\}$에서 덧셈하는 thread 수도 $a_j = 256 / 2^{j+1}$로 같고요. 달라지는 건 그 $a_j$개 thread가 몇 개 warp에 걸쳐 있느냐예요.
버전 0은 active thread가 block 전체에 흩어져 있어요. 조건이 참인 thread를 하나라도 가진 warp가 $\min(8, a_j)$개이고, 여덟 단계를 합하면 47이에요. 버전 1은 앞에서부터 모으니 $\lceil a_j / 32 \rceil$개면 되고, 합하면 12로 줄어요.
s = 128에서는 앞 warp 4개가 통째로 일하고, s = 64에서는 2개, s = 32에서는 1개가 일해요. 이 세 단계는 warp 안의 조건이 모두 같아요. s = 16부터는 첫 warp 안에서 조건이 나뉘지만, active lane은 여전히 앞에서부터 연속이고요.
buf[tid]와 buf[tid + s]도 연속 주소라 bank conflict가 없어요. %까지 사라졌네요. 일할 사람들 자리만 모았는데 정리가 꽤 됐죠ㅎㅎ
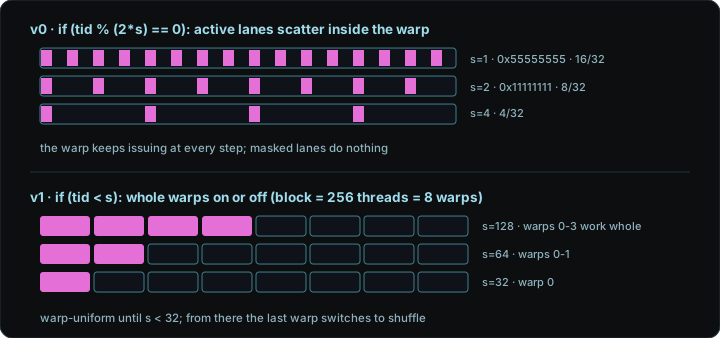
버전 2는 warp 안의 lane끼리 register 값을 직접 전달하는 warp shuffle을 써요. s = 16부터는 첫 warp 하나만 일하니, 그 경계에서는 shared memory를 오가며 __syncthreads()로 기다릴 필요 없이 register에서 접어갈 수 있어요.
if (tid < 32) {
    float x = buf[tid] + buf[tid + 32];
    for (int off = 16; off > 0; off >>= 1)
        x += __shfl_down_sync(0xffffffffu, x, off);
    if (tid == 0) out[blockIdx.x] = x;
}
__shfl_down_sync는 warp 안에서 register 값을 lane끼리 직접 전달하는 함수예요. 첫 인자는 참여 lane을 표시하는 mask이고, 세 번째 인자는 몇 lane 뒤의 값을 가져올지 정해요. 이렇게 하면 마지막 여섯 단계의 shared memory 왕복과 block barrier가 빠진답니다.
여기서 mask 0xffffffffu18를 쓸 수 있는 건 첫 warp 전체가 tid < 32를 만족하기 때문이에요. 일부 lane만 참여하는 코드라면 참여 lane 전원이 같은 mask로 같은 함수를 실행해야 해요. Mask 숫자만 그대로 가져다 쓰면 되는 건 아니니 이 부분은 꼭 같이 봐주세요.
버전 3에서는 block마다 atomic을 한 번만 할 거예요. Atomic은 여러 thread가 같은 주소를 동시에 고쳐도 한 번에 하나씩 적용되도록 보장하는 연산이에요.
Multi-pass 대신 각 block의 lane 0이 atomicAdd(out, x)를 한 번 실행해서, 구해둔 부분합을 결과에 바로 더해요. 원소마다 atomic을 쓰면 같은 주소에 $N$번 접근하지만, block reduction을 먼저 하면 block 수만큼만 접근하면 되죠.
실행 전에는 cudaMemset19으로 결과 변수를 0으로 만들어주세요. 그리고 float atomic은 실행마다 덧셈 순서가 달라질 수 있어요. 마지막 비트까지 똑같은 결과가 나온다고 보장하지는 않는답니다.
원소당 연산이 한 번뿐인 reduction은 memory 대역폭, 즉 1초에 옮길 수 있는 데이터 양에 묶여요. 그래서 잘 구현한 reduction이 어디까지 빨라질 수 있는지 볼 때는 같은 크기의 데이터 복사인 memcpy 속도를 상한으로 삼아요.
CUDA에 포함된 CUB의 DeviceReduce::Sum20은 임의 타입과 크기를 처리하면서 이 구간에 도달하는 구현이에요. 위 버전 3은 float 배열 하나로 범위를 정해서 그 구조를 보여준 것이고요.
다 더해서 값 하나 만드는 동안에도 memory를 읽고, 기다리고, 값을 전달하는 비용을 꽤 챙겨야 하네요. 아래 전체 소스에서는 각 단계가 어떻게 이어지는지 보실 수 있어요~
소스 코드
세 kernel의 전체 소스는 gemm_bench.cu, transpose_bench.cu, reduce_bench.cu에 있어요. 컴파일 명령도 함께 적어둘게요. nvcc는 CPU와 GPU 코드를 나눠 번역하는 CUDA compiler driver이고, 아래 option으로 최적화 수준과 대상 GPU, 출력 이름을 정해요.21
nvcc -O3 -arch=sm_89 -o gemm_bench gemm_bench.cu
nvcc -O3 -arch=sm_89 -o transpose_bench transpose_bench.cu
nvcc -O3 -arch=sm_89 -std=c++17 -o reduce_bench reduce_bench.cu
참고
- CUDA C++ Best Practices Guide: coalescing, shared memory, bank conflict, occupancy, branch predication의 기준 문서
- CUDA C++ Programming Guide: SIMT(Single Instruction, Multiple Threads: 같은 명령을 여러 thread가 각자의 데이터에 적용하는 실행 방식)의 divergence, 동기화, atomics, warp intrinsic22의 정확한 의미
- Mark Harris, An Efficient Matrix Transpose in CUDA C/C++: coalescing, shared tile, padding을 한 예제로 보여주는 표준 사례
- Andreas Holt, Shared-Memory Tiled Matrix Multiplication: tiled GEMM23의 그림과 경계 처리까지 붙인 설명
- Lei Mao, CUDA Shared Memory Bank: bank 주소 매핑의 상세
- Lei Mao, CUDA Shared Memory Swizzling: swizzle 주소 매핑의 상세
- Fabian Schütze, Visualizing Bank Conflicts: 현대 아키텍처의 bank 동작 보충
- Mark Harris, Optimizing Parallel Reduction in CUDA: reduction을 일곱 단계로 개선하는 고전이에요. 오래된 자료라 warp-synchronous24 코드를 그대로 복사해서 쓰시면 안 돼요.
- Faster Parallel Reductions on Kepler: shuffle과 계층적 atomic을 설명해요. 코드는 현대식
__shfl_down_sync()로 바꿔 읽어주세요. - Lei Mao, CUDA Reduction: batched reduction25 구현 중심의 정리
- CUTLASS: Efficient GEMM in CUDA26: threadblock/warp/thread tiling과 register 재사용, double buffering27으로 이어지는 상위 레퍼런스
- Simon Boehm, How to Optimize a CUDA Matmul Kernel: register tiling부터 warptiling28까지 가는 워크로그
- CUB:
WarpReduce → BlockReduce → DeviceReduce계층의 production 구현
스티커: LINE Moon · Moon & James · LINE Characters in Love!
큰 메모리에서 읽은 데이터를 가까운 작은 저장소에 보관했다가 재사용하는 장치예요. Shared memory는 어떤 값을 둘지 코드가 직접 정하지만, cache는 hardware가 접근 기록 등을 보고 보관할 값을 관리해요. ↩︎
함께 작업하는 thread들이 정해진 위치에 모두 도착할 때까지 기다리게 하는 동기화 지점이에요. 이 글에서는 같은 block의 thread들이 shared memory 쓰기를 마친 뒤 읽기를 시작하도록 맞추는 데 써요. ↩︎
Shared memory는 동시에 접근할 수 있도록 bank라는 여러 저장 구역으로 나뉘어요. 한 warp의 서로 다른 주소 요청이 같은 bank에 몰려서 나눠 처리해야 하는 현상이 bank conflict예요. Warp는 바로 아래에서 볼 thread 32개 묶음이에요. ↩︎
SM에 배치되어 아직 실행을 마치지 않은 warp 수가 그 SM의 최대 수용 warp 수에서 차지하는 비율이에요. 다른 warp가 메모리를 기다리는 동안 대신 실행할 후보를 얼마나 확보했는지 보는 값이며, 실행 시간 중 GPU가 바빴던 비율은 아니에요. ↩︎
Byte는 데이터 크기의 단위예요. 1 byte는 0 또는 1을 담는 bit 8개이고, 32-bit 값 하나는 4 bytes를 차지해요. ↩︎
C/C++에서 32-bit 부동소수점 값을 담는 자료형이에요. 부동소수점은 유효 숫자와 크기를 나타내는 지수로 수를 표현해서 소수도 저장하며, 정밀도가 유한하므로 계산 결과에 반올림이 생길 수 있어요. ↩︎
NVIDIA GPU용 프로그램을 작성하는 CUDA에서 GPU 메모리를 확보하는 함수예요. 요청한 byte 수만큼 영역을 잡고, 그 시작 주소를 pointer 변수에 써줘요. ↩︎
__global__은 GPU에서 실행할 kernel이라는 표시이고,void는 함수 호출로 직접 돌려줄 값이 없다는 뜻이에요.float*는 실수 배열을 가리키는 pointer이며const float*는 이 pointer를 통해 입력을 바꾸지 않겠다는 표시,int는 정수 자료형이에요.for는 조건을 만족하는 동안 반복하고,acc += ...는 계산한 값을 기존acc에 더하며,0.0f의f는 float 상수라는 표시예요. ↩︎이 예제는 행렬을 한 행씩 이어 붙이는 row-major(행 우선) 순서로 저장해요. 한 행에 N개가 있으므로
A[row * N + k]는 row번째 행의 k번째 원소이고, C/C++ 배열 번호는 0부터 시작해요. ↩︎#define T 32는 뒤에 나오는 이름 T를 32로 바꾸도록 정하는 C/C++ 전처리 지시문이에요.As[T][T]는 T행 T열 배열이고,As[y][x]처럼 행 번호와 열 번호로 원소를 골라요. ↩︎이 설명에서 word는 주소 배치를 세는 4바이트 단위예요. 연속된 word마다 다음 bank 번호를 주고, 32개를 지나면 bank 0으로 돌아간다고 생각하시면 돼요. ↩︎
XOR(배타적 논리합)는 두 숫자의 같은 자리 bit를 비교해 서로 다르면 1, 같으면 0을 만드는 연산이에요. C/C++에서는
^로 적으며, 여기서는 행 번호에 따라 열 번호의 bit를 바꿔 bank를 분산해요. ↩︎SM이 동시에 받아들일 수 있는 block 개수에도 별도 한도가 있어요. Thread 자리나 메모리가 남아 있어도 이 개수 한도를 다 채우면 새 block을 올릴 수 없다는 뜻이에요. ↩︎
&는 두 숫자에서 같은 자리 bit가 모두 1일 때만 1을 남기는 AND 연산이에요. 1차원 thread 번호에& 31을 하면 아래 5개 bit만 남아 lane 번호 0~31을 얻고, 음수가 아닌 번호를>> 5로 오른쪽 5 bit 옮기면 정수로 32로 나눈 warp 번호를 얻어요.warp & 1은 마지막 bit로 짝수와 홀수를 구분하고,s >>= 1은 s를 오른쪽 1 bit 옮겨 절반으로 줄여요. ↩︎특정 NVIDIA GPU가 실제로 실행하는 명령을 사람이 읽을 수 있는 이름으로 나타낸 표기예요. 아래
ISETP.LT는 작다는 비교 결과를 만들고,FMUL은 부동소수점 곱셈을 수행하는 명령이에요. ↩︎입력값마다 지수함수를 적용한 뒤 전체 합으로 나눠, 각 값이 0~1 사이이고 합은 1인 값들로 바꾸는 연산이에요. 보통 큰 수 때문에 표현 범위를 넘지 않도록 입력의 최댓값을 먼저 빼므로, 최댓값 reduction과 합 reduction이 필요해요. ↩︎
Layer normalization의 줄임말이에요. 입력 하나의 정해진 원소 묶음에서 평균과 분산을 구한 뒤, 평균을 빼고 표준편차에 맞춰 값의 크기를 조정해요. 분산은 값들이 평균에서 얼마나 퍼졌는지 나타내는 수치이고, 표준편차는 그 제곱근이에요. ↩︎
0x로 시작하면 16진수 표기이며 f 하나는 bit 4개가 모두 1인 값이에요. f 8개는 32개 lane을 모두 포함하는 mask이고, 끝의u는 음수 없이 저장하는 unsigned 정수 상수라는 표시예요. ↩︎GPU 메모리의 지정한 byte 범위를 같은 byte 값으로 채우는 CUDA 함수예요. 여기서는 결과가 저장될 float의 모든 byte를 0으로 채워 덧셈을 시작할 0.0을 만들어요. 임의 실수를 대입하는 함수는 아니에요. ↩︎
CUB는 NVIDIA가 제공하는 CUDA C++ 병렬 연산 library, 즉 재사용할 수 있는 구현 모음이에요.
DeviceReduce::Sum은 GPU 메모리의 배열 전체를 합하는 기능이고, 이름의 Device는 한 warp나 block을 넘어 GPU 전체의 작업을 조율한다는 뜻이에요. ↩︎-O3는 host 코드의 최적화 수준을 높이는 option이고,-arch=sm_89는 compute capability 8.9 GPU를 대상으로 GPU 코드를 만들겠다는 뜻이에요.-o다음은 실행 파일 이름이며-std=c++17은 사용할 C++ 언어 규격을 정해요..cu는 CUDA C++ 소스 파일의 확장자예요. ↩︎Compiler가 특별히 알고 GPU 명령에 연결해주는 함수를 intrinsic이라고 해요. Warp intrinsic은
__shfl_down_sync처럼 warp 안에서 값을 전달하거나 실행을 맞추는 데 쓰는 함수예요. ↩︎GEMM은 General Matrix Multiplication, 일반 행렬곱이에요. 보통 두 행렬의 곱과 기존 결과에 계수를 곱해 더하는 형태를 다루며, 여기서는 tile로 나누는 행렬곱 구현을 뜻해요. ↩︎
Warp의 thread들이 별도 동기화 없이도 같은 보조를 맞춰 실행한다고 가정하는 방식이에요. 서로의 메모리 쓰기를 읽는 코드는 그 가정에 기대지 말고 필요한 warp 또는 block 동기화를 명시해야 해요. ↩︎
여러 독립된 입력 묶음에 reduction을 각각 적용하는 방식이에요. 행렬의 행마다 합을 따로 구하는 경우가 한 예예요. ↩︎
CUTLASS는 CUDA Templates for Linear Algebra Subroutines의 약자로, 행렬곱 등을 GPU에 맞춰 구성하는 C++ 구현 모음이에요. 여기서 template은 자료형이나 tile 크기 같은 선택을 바꿔 코드를 만들 수 있는 C++ 기능이에요. ↩︎
데이터 보관 공간을 두 벌 두고, 현재 데이터를 계산하는 동안 다음 데이터를 다른 공간에 준비하는 방식이에요. 두 공간의 역할을 번갈아 바꾸면서 복사와 계산의 기다림을 줄여요. ↩︎
Block이 맡은 tile을 다시 warp별 작은 tile로 나누는 배치예요. 각 warp와 thread가 어떤 결과 원소를 계산하고 register에 보관할지 정해서 재사용을 늘려요. ↩︎