안녕하세요~ㅎㅎ
앞에서는 CPU와 GPU1 사이에 데이터를 직접 복사해줬는데요. 이번에는 둘이 메모리 하나를 함께 쓰는 이야기를 해보려고 해요.
CUDA2 프로그램에서 CPU는 Host, GPU는 Device라고 부르죠. 둘 다 명령을 처리하는 장치인 processor지만 명령을 실행하는 방식도, memory에 접근하는 방식도 달라요. 이렇게 성격이 다른 처리 장치를 함께 사용하는 구조가 heterogeneous system이랍니다.
Host-Device 데이터 흐름에서는 CPU용 h_data와 GPU용 d_data를 따로 만들었어요. 두 memory 사이에는 cudaMemcpy로 데이터를 옮겨줬고요. 어디에 두고 언제 옮길지가 코드에 드러나는 explicit memory management예요.
자료구조가 복잡해지면 챙길 것도 늘어나요. 두 memory 영역을 할당해서 해제할 때까지의 수명에, copy 방향에, 이동 시점까지.. 계산하기 전에 준비할 일이 제법 있네요.
Unified Memory에서는 cudaMallocManaged로 CPU와 GPU가 함께 사용할 메모리 영역을 만들어요. 이렇게 CUDA가 관리해주는 영역을 managed allocation이라고 한답니다.
메모리 주소를 담는 포인터 하나로 쓸 수 있다니 반갑죠?ㅎㅎ 다만 실제 데이터가 어디에 있고 언제 읽어도 되는지는 조금 더 봐야 해요. 가상 주소3부터 배치와 이동, 동기화4와 캐시 일관성5을 살펴보고 Jetson AGX Orin6의 실제 장치 출력까지 이어서 볼게요.
CPU Memory와 GPU Memory
메모리를 함께 쓰기 전에, 할당부터 잠깐 짚고 갈게요. Allocation은 프로그램이 쓸 memory 영역을 확보하는 일이에요. Allocation API7에 크기를 요청하면 그만큼의 영역을 마련하고, 시작 address를 pointer로 돌려줘요.
malloc으로 만들면 CPU code가 쓸 allocation이고, cudaMalloc으로 만들면 GPU가 접근하도록 CUDA가 관리하는 device allocation이에요. 둘 다 pointer를 돌려주지만 그 pointer들이 가리키는 memory 영역은 서로 다를 수 있답니다.
CPU와 별도 칩으로 붙는 discrete GPU가 달린 일반적인 PC를 생각해볼까요? CPU의 주 memory인 system DRAM8과 GPU 전용 memory인 VRAM이 물리적으로 떨어져 있어요. 둘 사이에서 데이터를 주고받는 연결 통로가 PCIe(PCI Express)고요.
그러니 앞 글처럼 CPU에는 malloc, GPU에는 cudaMalloc으로 각각 할당했다면, 계산 전에 H2D(Host to Device) copy가 필요해요. GPU가 만든 결과를 CPU에서 읽을 때는 D2H(Device to Host) copy로 가져와야 하고요. 왔다가 갔다가.. 이 복사가 코드에 들어가 있었던 거예요.
CPU 쪽 시스템에 통합된 integrated GPU에서는 CPU와 GPU가 같은 system DRAM을 사용해요. 이쪽은 물리 메모리를 함께 쓰네요.
그런데 각 처리 장치에는 주소 변환 장치와 cache가 따로 있어요. Cache는 자주 쓰는 data를 잠깐 보관하는 곳이고요. DRAM을 공유해도 각 장치에 맞는 주소 연결은 필요하고, CPU와 GPU가 어떤 순서로 접근할지도 정해줘야 한답니다.
예를 들어 GPU 작업이 끝난 뒤 CPU가 읽게끔 프로그램에서 순서를 정할 수 있어요. 프로그램이 호출할 기능을 모아둔 library가 CUDA Runtime이고, GPU 실행과 주소 연결을 제어하는 system software가 CUDA driver예요. 이 Runtime과 driver, hardware가 주소 연결과 데이터 배치, cache 상태를 나눠서 관리해줘요.
Virtual Address와 Physical Memory
주소 변환
여기서 process와 processor가 나란히 나오는데요. 이름이 비슷해서 잠깐 멈칫하죠ㅎㅎ Process는 실행 중인 프로그램 하나를 가리키는 운영체제(OS)의 관리 단위예요. CPU·GPU 같은 processor와 구분해서 읽어주세요.
CUDA process의 pointer에는 virtual address가 들어 있어요. 이걸 DRAM이나 VRAM에서 데이터가 놓인 실제 위치, physical address로 바꿔주는 장치가 MMU(Memory Management Unit)랍니다.
한 process가 사용할 수 있는 virtual address 전체 범위를 virtual address space라고 해요. 보통 이 범위를 일정 크기의 page로 나누고, physical memory는 같은 크기의 frame(page frame)으로 나눠요.
어느 virtual page가 어느 physical frame에 연결됐는지, 어떤 접근을 허용하는지는 page table에 적혀 있어요. 이 연결이 mapping, 앞에서 말한 주소 연결이에요. 모든 virtual page에 physical frame이 붙어 있는 건 아니라서, 아직 연결되지 않은 page도 있어요.
CPU나 GPU가 pointer를 통해 값을 읽고 쓸 때는 각 장치의 MMU가 주소를 변환해요. Virtual address를 virtual page number와 page 안의 위치인 offset으로 나눠서 보면 편한데요. Page number를 physical frame number로 바꾸고, 그 안에서 몇 번째 위치인지를 나타내는 offset은 그대로 써요.
이 변환을 할 때 MMU는 우선 TLB(Translation Lookaside Buffer)부터 찾아봐요. 최근에 사용한 가상 페이지→물리 프레임 변환 결과가 들어 있거든요.
자주 쓰는 것을 가까운 곳에 작게 복사해두고 먼저 찾아보는 저장소를 캐시라고 하는데, TLB는 그중 주소 변환 결과를 보관하는 캐시예요. 아까 찾았던 주소를 또 처음부터 찾아야 하면 조금 아깝겠죠ㅎㅎ
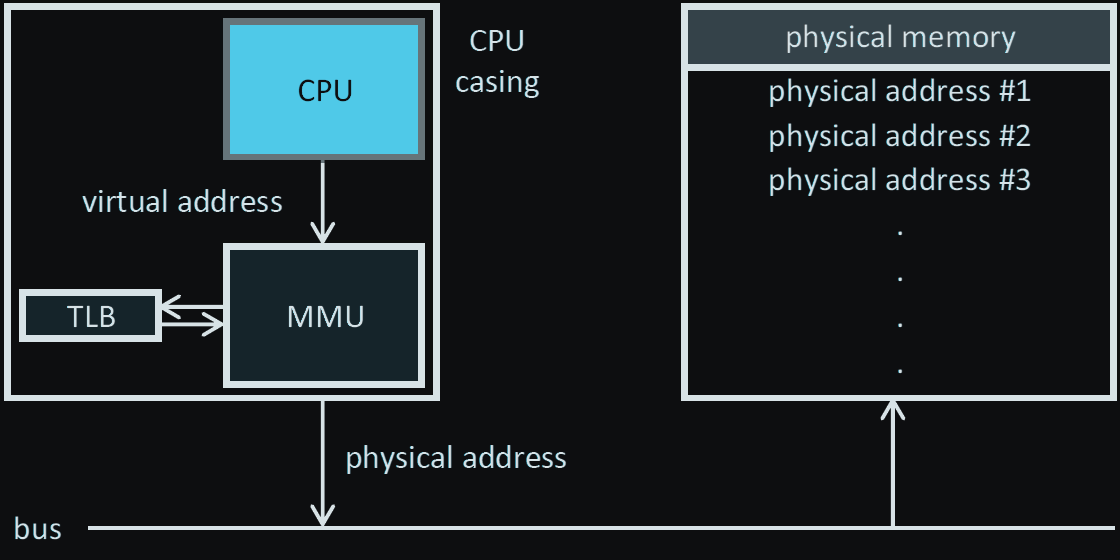
변환을 마친 physical address는 실제 데이터가 놓인 system DRAM이나 VRAM의 위치를 가리켜요. NVIDIA CUDA Programming Guide에서는 CUDA가 이런 여러 physical memory 사이에서 데이터의 배치와 이동을 관리한다고 설명해요. 이제 주소를 따라 실제 데이터 쪽으로 가볼게요.
배치와 이동
cudaMallocManaged로 만든 managed allocation은 CUDA Runtime과 driver가 저장 위치, 이동 시점, 처리 장치별 mapping을 관리해요. cudaMalloc으로 device allocation을 만들었을 때는 host와 데이터를 주고받으려면 프로그램에서 cudaMemcpy를 요청했죠. Managed allocation에서는 그 관리를 CUDA에 맡기는 거예요.
여기서 mapping, placement, migration이 한꺼번에 나와요. 전부 메모리 이야기라 비슷해 보이지만, CUDA 문서에서는 가리키는 게 각각 다르답니다.
discrete GPU에서 x가 가리키는 데이터가 시스템 DRAM에서 VRAM으로 이동한다고 해볼게요. 포인터 x에 들어 있는 가상 주소는 V, *x의 값은 41이에요. 주소와 값을 따로 따라가보면 차이가 보여요.
| 용어 | 무엇을 가리키나 | x를 따라간 예시 |
|---|---|---|
| mapping (매핑) | 가상 페이지를 물리 프레임에 연결하는 주소 관계 | 이동 전에는 V가 시스템 DRAM의 프레임 A에 연결된다. 이동 후 GPU에서는 같은 V가 VRAM의 프레임 B에 연결된다. 이동 전후의 포인터에는 같은 V가 들어 있다. |
| placement (배치) | 데이터가 현재 어느 물리 메모리에 저장돼 있는가 | 41이 시스템 DRAM의 프레임 A에 있으면 배치는 시스템 DRAM이다. 이동 후 프레임 B에 있으면 배치는 VRAM이다. |
| migration (이동) | 데이터를 다른 물리 메모리로 옮겨 배치를 바꾸는 일 | 41이 든 페이지를 시스템 DRAM의 프레임 A에서 VRAM의 프레임 B로 복사하고, GPU의 주소 연결을 프레임 B로 바꾼다. |
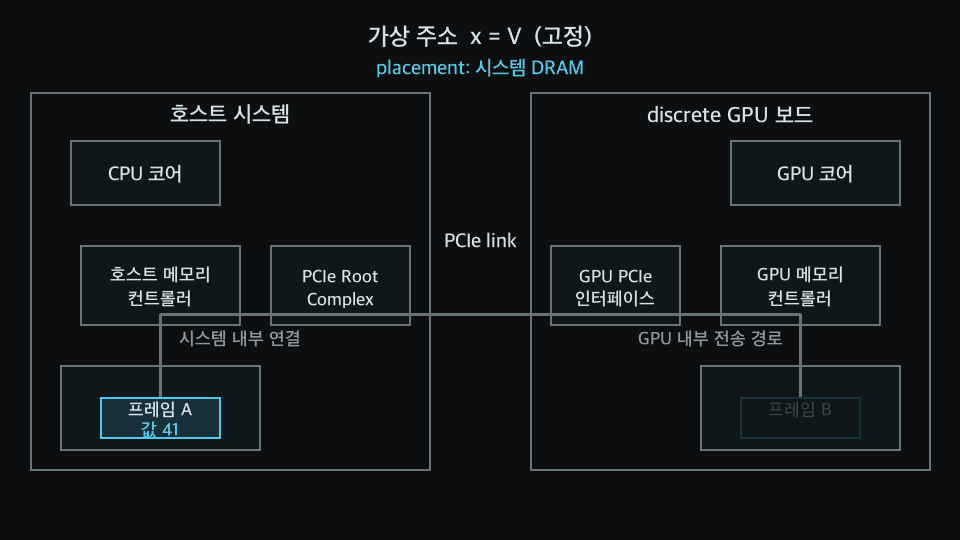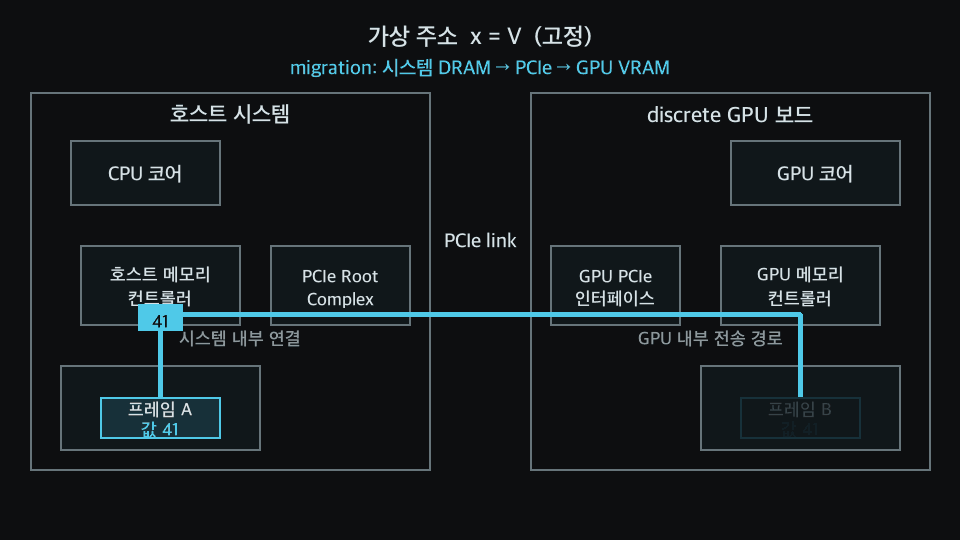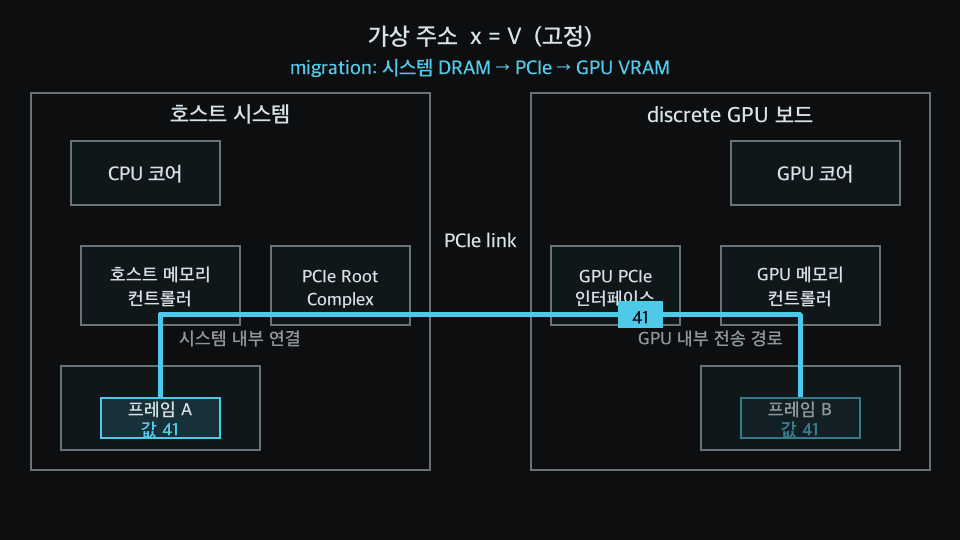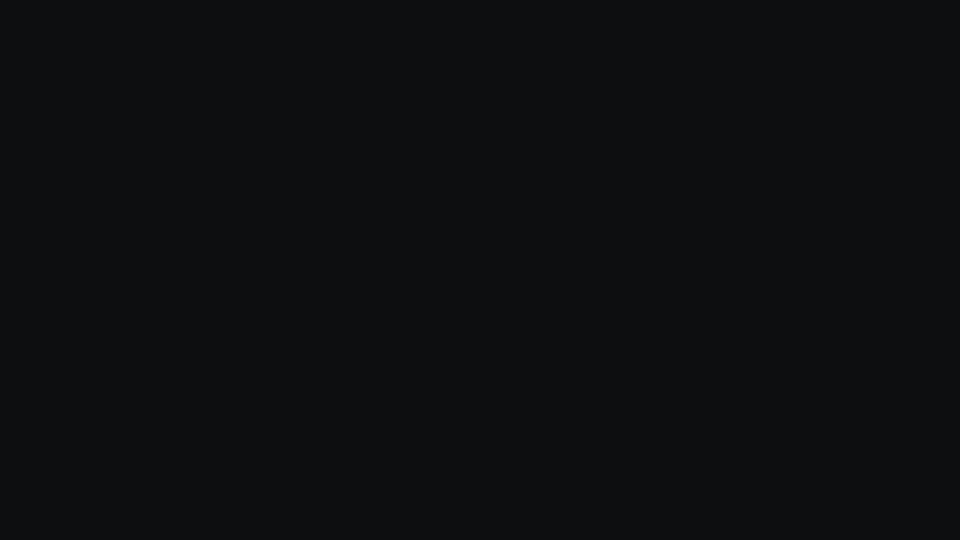
그림은 CPU DRAM과 VRAM이 PCIe로 떨어져 있는 discrete GPU의 이동 경로예요. 배치는 managed allocation 전체에 한 번 정해지는 게 아니라 각 페이지마다 정해져요. 데이터를 놓을 수 있는 위치도 하드웨어 구조에 따라 달라지고요. 같은 Unified Memory라도 아래처럼 실제 메모리 구성은 다르답니다.
| 관리형 데이터가 놓이는 곳 | 별도 VRAM으로 옮기는 과정 | |
|---|---|---|
| discrete GPU | 시스템 DRAM 또는 VRAM | 있음 |
| integrated GPU | 공유 system DRAM | 공유 DRAM 안에서 접근 |
그 주소에서 다음에 읽어야 할 값도 맞아야겠죠. Synchronization으로 정해진 순서에서 마지막으로 완료된 write의 결과를 읽어야 해요. 그런데 그 결과가 CPU나 GPU의 cache에 남아 있을 수 있거든요. 다음 처리 장치가 같은 주소를 읽기 전에 접근 순서와 cache 상태를 함께 맞춰줘야 해요.
UVA와 Unified Memory
UVA(Unified Virtual Addressing)도 이름에 Unified가 붙어서 같이 등장해요. 이름만 보고 넘어가면 은근히 헷갈리는 부분이에요..ㅎㅎ
UVA는 한 프로세스 안의 CPU 메모리와 각 GPU 메모리를 하나의 가상 주소 공간에 배치해요. CPU와 GPU는 각자 유효한 mapping을 쓰고요. 이렇게 메모리를 구분하는 주소 체계를 제공하는 게 UVA예요. UVA를 쓴다고 cudaMalloc allocation을 CPU에서 바로 읽는 건 아니고, 그 allocation의 접근 주체는 GPU예요.
Unified Memory는 managed allocation의 접근과 배치를 관리해요. CUDA synchronization으로 write 순서가 정해지면, 다음 처리 장치가 그 write의 결과를 읽을 수 있게 해준답니다. 주소 체계 이야기와 실제 접근·배치 이야기를 여기서 나눠두면 뒤가 편해요.
Unified Memory와 Managed Allocation
그럼 managed allocation 하나를 만들어볼게요. Unified Memory는 CPU와 GPU 양쪽 코드가 사용할 수 있는 이 영역을 제공하고, 기본 Runtime API가 cudaMallocManaged예요. 호출은 이렇게 생겼어요.
int *x = nullptr;
cudaMallocManaged(&x, sizeof(*x));
sizeof(*x)만큼 공간을 잡고 그 시작 주소를 pointer 변수 x에 기록해요. 여기서 &x는 pointer 변수 자체의 주소예요. 그 주소를 함수에 넘겨야 함수가 x에 allocation의 시작 주소를 써줄 수 있거든요. 다 쓴 allocation은 cudaFree(x)로 해제하면 돼요.
Explicit-copy 방식에서는 CPU용 h_data, GPU용 d_data와 H2D, D2H를 코드에 따로 적었어요. Managed 방식에서는 CPU와 GPU가 x 하나를 사용해요. 데이터 이동은 Runtime과 driver, hardware가 현재 system의 지원 수준에 맞춰 처리하고요.
코드에서 챙길 포인터는 하나로 줄었네요~^^ 그럼 이걸 양쪽에서 차례로 써볼까요?
CPU가 쓴 값을 GPU가 수정하기
아래 예제에서는 CPU가 같은 managed allocation에 값을 쓰고, 그다음 GPU가 수정해요. GPU에서 실행되는 함수가 kernel이고, 그 함수를 실행하는 작업 단위가 thread예요.
이번에는 GPU thread 하나만 써요. CPU가 적어둔 41에 딱 한 번 1을 더해서 42를 만드는 코드랍니다.
#include <cstdio>
#include <cuda_runtime.h>

__global__ void add_one(int *x) {
    *x += 1;
}

int main() {
    int *x = nullptr;
    cudaMallocManaged(&x, sizeof(*x));

    *x = 41;
    std::printf("before kernel: %d\n", *x);

    add_one<<<1, 1>>>(x);
    cudaDeviceSynchronize();

    std::printf("after kernel:  %d\n", *x);
    cudaFree(x);
}
__global__은 kernel 선언에 붙는 표시예요. 함께 배치되는 GPU thread 묶음을 block이라고 하는데, <<<1, 1>>>은 block 하나에 thread 하나를 넣겠다는 뜻이에요.
참, kernel을 launch했다고 CPU가 그 자리에서 기다려주지는 않아요. 바로 다음 코드를 실행하거든요. GPU가 쓰는 도중에 CPU가 읽지 않도록 GPU write와 CPU read 사이에 cudaDeviceSynchronize()를 뒀어요. 여기서 GPU 작업이 끝날 때까지 기다린답니다.
Synchronization과 Cache Coherence
앞의 코드는 CPU가 41을 쓰고, GPU가 42로 바꾼 뒤, CPU가 다시 읽는 순서예요. 결과는 한 줄이지만 안에서는 두 가지가 맞아야 해요.
CPU가 GPU 작업이 끝난 뒤에 읽어야 하고, 그때 읽은 값도 GPU가 써둔 42여야 하죠. 기다리기는 기다렸는데 예전 값이 보이면.. 그것도 난감하네요 ^^;;
읽는 시점을 맞추는 게 synchronization이에요. cudaDeviceSynchronize()는 앞서 제출한 GPU 작업이 끝날 때까지 CPU thread9를 기다리게 해요. 덕분에 GPU write가 끝난 다음 CPU read를 시작할 수 있어요.
그다음 볼 게 cache coherence예요. CPU와 GPU는 DRAM에 자주 다녀오지 않으려고 최근 데이터를 각자의 cache에 보관해요. 가져올 때는 연속된 byte 묶음인 cache line 단위로 가져오고요.
GPU가 42를 cache에 썼다면 CPU의 다음 read에서도 42가 보여야 해요. 그러려면 각자의 cache 상태를 맞춰줘야 한답니다.
Cache coherence를 맞추는 방식은 두 가지예요. Processor 사이의 cache 상태를 hardware가 직접 맞춰주면 hardware coherence라고 해요.
Software coherence에서는 driver가 access와 synchronization 경계에서 주소 연결, 데이터 이동, cache 상태를 조정해요. 앞선 처리 장치가 쓴 결과를 다음 처리 장치에서 읽을 수 있게 하는 거죠. 그 과정에서 cache의 변경값을 다른 장치에 보이게 하거나, 이전 cache 사본을 폐기하는 작업을 cache maintenance라고 불러요.
Synchronization은 CPU가 언제 읽는지, cache coherence는 그때 어떤 값이 보이는지에 관한 이야기예요. Placement는 data가 놓인 physical memory를 가리키고요. 같은 위치를 여러 처리 장치가 수정한다면 synchronization으로 접근 순서를 정해야 해요.
메모리 하나를 같이 쓴다고 신경 쓸 일이 전부 없어지는 건 아니었네요ㅎㅎ
Unified Memory 지원 모델
CUDA는 managed allocation에 접근하는 방식을 Full model과 Limited model로 나눠요. GPU가 그 allocation을 언제 사용할 수 있게 준비하는지, 또 GPU가 실행 중일 때 CPU도 접근해도 되는지를 보고 구분한답니다.
Full model
장치가 지원하는 기능을 조회하는 값, device attribute인 concurrentManagedAccess부터 보면 돼요. CPU와 GPU가 managed allocation을 동시에 사용할 수 있는지를 나타내는데, 값이 1이면 Full model이에요.
GPU가 virtual page에 접근할 때 CUDA가 GPU mapping을 설정해요. 필요하다면 data를 GPU memory의 physical frame으로 옮기고요. 이 모델에서는 CPU와 GPU가 같은 managed allocation의 서로 다른 주소를 동시에 사용할 수 있어요. 여기서 서로 다른 주소라는 부분도 같이 봐주세요~
Limited model
concurrentManagedAccess=0이면 Limited model이에요. 이쪽은 CUDA가 kernel launch 경계에서 managed memory를 GPU가 사용할 수 있게 준비해요. CPU 접근은 synchronization 뒤에 다시 열리고요. GPU 작업이 끝나기를 기다렸다가 CPU에서 사용하는 순서랍니다.
| 비교 항목 | Full model | Limited model |
|---|---|---|
cudaMallocManaged | 사용할 수 있음 | 사용할 수 있음 |
| GPU가 data에 접근할 수 있게 되는 시점 | GPU가 virtual page에 접근하면 CUDA가 mapping 또는 migration을 처리함 | Kernel launch 경계에서 CUDA가 managed allocation을 GPU가 접근 가능한 상태로 만듦 |
| GPU 실행 중 CPU의 managed-memory 접근 | 서로 다른 주소에 접근할 수 있음 | GPU 작업을 synchronization한 뒤 CPU가 접근함 |
| GPU가 사용할 수 있는 physical memory보다 큰 managed allocation | GPU memory보다 큰 allocation도 사용함 | GPU가 사용할 수 있는 physical memory 용량 안에서 사용함 |
뒤에서 볼 Jetson AGX Orin은 shared DRAM을 쓰면서 Limited model로 동작해요. 반대로 CPU DRAM과 GPU VRAM이 떨어진 discrete GPU에서도 Full model인 시스템이 있어요.
물리 메모리를 공유하느냐만 보고 지원 모델까지 정하면 안 되겠죠? 이건 장치 속성도 봐야 해요.
Full model에서는 managed allocation의 각 virtual page에 속한 data를 보통 그 page를 처음 읽거나 쓴 처리 장치 쪽 memory에 배치해요. CUDA 문서의 First touch가 이 뜻이에요.
프로그램에서 선호하는 위치가 있다면 cudaMemAdvise로 driver에 알려줄 수 있어요. 이런 정보를 hint라고 하고, driver는 이후 배치를 결정할 때 참고한답니다.
실제 지원 모델은 operating system과 OS kernel, CUDA driver, GPU, CPU–GPU 연결 구조의 조합에 따라 정해져요. 여기서 OS kernel은 운영체제의 핵심부를 말해요. 앞에서 실행했던 GPU kernel과 또 이름이 같네요..ㅎㅎ
그래서 현재 환경에서 어떤 모델을 쓸 수 있는지는 cudaDeviceGetAttribute로 확인해요.
우선 managedMemory는 cudaMallocManaged처럼 명시적으로 요청하는 managed allocation을 지원하는지 알려줘요. 지원 여부를 봤다면, 그다음 세 attribute는 아래 순서로 읽어보시면 돼요.
concurrentManagedAccess가0이면Limited model이에요.- 그 값이
1이면Full model이에요. 이때pageableMemoryAccess10가0이라면 CUDA API로 명시적으로 만든 managed allocation만 이 모델을 사용해요. - 두 값이 모두
1이면malloc,new,mmap같은 system allocation11까지 Unified Memory 범위에 들어와요. 이때만pageableMemoryAccessUsesHostPageTables를 읽어요.0이면 driver가 mapping과 migration을 관리하며 앞서 본 cache coherence를 달성하는 software coherence예요.1이면 CPU와 GPU가 같은 host page table을 쓰고 hardware가 cache 상태를 직접 맞추는 hardware coherence랍니다.
Discrete GPU의 Page Fault와 Migration
이제 discrete GPU에서 실제로 페이지를 옮기는 경로를 볼게요. CPU DRAM과 GPU memory가 분리된 software-coherent Full model에서 GPU page fault를 migration으로 처리하는 경우예요. 앞서 본 software coherence처럼 driver가 CPU와 GPU의 주소 연결과 데이터 이동을 관리해요.
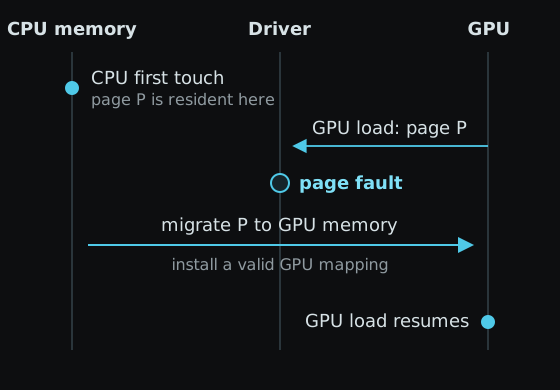
처음에는 managed data가 CPU memory의 physical frame에 있고, CPU mapping도 그 frame을 가리켜요. GPU가 같은 virtual address를 처음 읽으려고 하면 page fault가 나면서 memory access가 멈춰요.
이때 page fault는 해당 virtual page를 읽을 GPU mapping을 준비하라는 신호예요. 이름에 fault가 붙었다고 여기서 프로그램이 끝나는 건 아니랍니다.
Fault는 migration이나 remote mapping, 즉 데이터를 옮기지 않고 다른 처리 장치 쪽 memory에 접근할 주소를 연결하는 방식으로 처리할 수 있어요. 아래 그림은 migration을 택한 경우예요. Page table과 physical frame을 관리하는 operating-system memory manager가 CUDA driver와 함께 GPU memory에 physical frame을 준비하고, data를 옮긴 뒤 GPU mapping을 설치해요. Mapping 준비가 끝나면 기다리던 GPU instruction도 다시 실행돼요.
Remote mapping을 택하면 data는 CPU memory의 physical frame에 그대로 두고, GPU mapping을 그 frame에 연결해요. Migration에서는 data placement가 달라지고, remote mapping에서는 placement가 유지되는 거죠. Fault가 났다는 이유만으로 매번 데이터를 옮겼다고 보면 안 되겠네요.
CPU와 GPU가 같은 pages를 번갈아 수정하면 양쪽으로 migration이 반복될 수 있어요. 이게 page ping-pong이에요. 옮겨왔더니 다시 저쪽에서 쓰고.. 페이지도 바쁘겠어요ㅠㅠ
cudaMemPrefetchAsync12로 지정한 범위의 데이터를 미리 옮기면 placement 시점을 앞당길 수 있어요. CPU와 GPU가 실행되는 순서는 CUDA synchronization으로 정해주고요.
HMM
HMM(Heterogeneous Memory Management)도 여기서 같이 볼게요. Linux kernel 안에서 메모리 관리의 일부를 맡는 subsystem이에요. CPU page table의 변경과 GPU fault, page migration을 연결해줘요.
HMM을 사용하는 Full model에서는 malloc, new, mmap으로 만든 system allocation도 GPU가 사용할 수 있어요. Device attributes로 지원 범위를 분류할 수 있고, 현재 HMM 사용 여부는 NVIDIA driver에 딸린 명령줄 도구 nvidia-smi를 -q로 실행해서 Addressing Mode 항목을 보면 된답니다.
Jetson AGX Orin: Shared DRAM과 Limited model
그럼 앞의 내용을 실제 장치 출력에 대입해볼게요. 확인한 환경은 Jetson AGX Orin Developer Kit예요. Jetson Linux 배포판인 L4T(Linux for Tegra)는 R36.5.0, CUDA 개발 도구를 묶은 JetPack은 6.2.2, CUDA는 12.6이었어요.
Tegra는 Orin이 속한 NVIDIA SoC 제품군의 이름이에요. Orin은 CPU와 GPU가 한 chip에 들어 있는 SoC(System on Chip)고요. 첫 번째 GPU를 뜻하는 Device 0으로 잡힌 건 compute capability 8.7인 integrated GPU였어요. Compute capability는 GPU가 지원하는 CUDA hardware 기능 세대를 나타낸답니다.
device=0 name=Orin cc=8.7 integrated=1
managedMemory=1
concurrentManagedAccess=0
pageableMemoryAccess=0
판정
출력에서 managedMemory=1이니 explicit managed allocation은 지원해요. 그런데 concurrentManagedAccess=0이네요. 이 장치는 Limited model로 읽으면 돼요. pageableMemoryAccess=0이므로 Unified Memory의 범위도 cudaMallocManaged 같은 explicit managed allocation으로 제한돼요.
이 출력으로 지원 모델을 확인했으니, 실제 DRAM과 cache가 어떻게 동작하는지도 이어서 볼게요. Shared SoC DRAM과 cache 동작은 NVIDIA Tegra memory model 문서에서 설명하고 있어요.
공유 DRAM과 캐시
Tegra 문서에 따르면 CPU와 integrated GPU가 SoC DRAM을 공유해요. Device memory, host memory, unified memory가 모두 같은 physical SoC DRAM에 할당된답니다. 위 출력의 integrated=1에서도 Orin GPU의 integrated 구조를 확인할 수 있어요.
Orin의 managed allocation도 이 shared SoC DRAM에 놓여요. 그리고 CPU와 GPU는 managed data를 각자의 cache에 저장할 수 있어요. 그래서 앞선 처리 장치가 쓴 결과를 다음 처리 장치가 읽도록 cache 상태를 맞춰야 하죠. 여기에서도 cache coherence가 필요한 거예요.
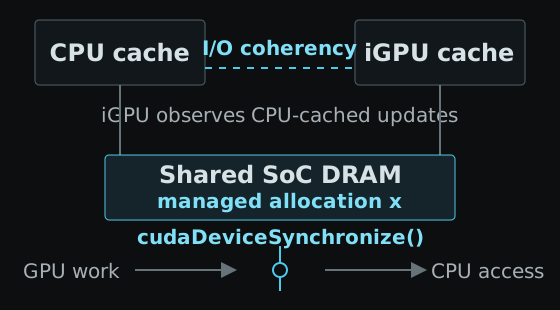
Orin의 one-way I/O coherency13는 CPU가 cache에 기록한 값을 GPU에서 읽을 수 있게 해줘요. 반대 방향, 즉 GPU가 쓴 값을 CPU가 읽을 때는 CUDA driver가 synchronization 경계에서 GPU cache 상태를 관리해요.
One-way라는 말이 괜히 붙은 건 아니네요. 두 방향을 따로 따라가야 해요ㅎㅎ
Tegra 문서에서는 concurrentManagedAccess=0인 환경의 kernel launch와 synchronization에 cache maintenance 작업이 추가된다고 설명해요. 이 작업 때문에 실행 지연 시간이 늘어날 수도 있어요. DRAM을 공유해도 이런 관리 비용은 남아 있답니다.
앞의 예제 코드인 managed_add.cu를 실제로 실행한 출력도 볼게요. Compute capability 8.7의 compile target인 sm_8714로 빌드한 결과예요.
before kernel: 41
after kernel:  42
41 → 42, GPU가 더한 값이 CPU에서도 보이네요~^^ GPU 작업이 끝난 뒤 CPU가 GPU write의 결과인 42를 읽은 거예요. 함께 기록한 device attributes에서는 이 Orin이 어디까지 Unified Memory를 지원하는지도 확인할 수 있고요.
직접 보실 수 있게 managed_add.cu에 실행 가능한 전체 코드를, orin_um_probe.cu에 attribute 조회 코드를 남겨뒀어요. 실제 출력은 Orin observation에 있어요.
포인터 하나를 같이 쓰는 이야기로 시작했는데 주소도 따라가고 cache도 들여다봤네요ㅎㅎ 다음에는 데이터 복사와 계산을 어떻게 겹쳐 실행하는지 살펴볼게요~
참고
- CUDA Programming Guide: Unified and System Memory: UVA, Unified Memory 지원 모델, device attributes, prefetch, HMM.
- CUDA Programming Guide: Unified Memory: page fault, migration, coherence, performance behavior의 상세 설명.
- CUDA for Tegra: Memory Management: Tegra의 shared SoC DRAM, cache coherence,
Limited model지침. - 스티커: LINE의 Moon 캐릭터. Moon & James, LINE Characters in Love!.
CPU(Central Processing Unit)는 프로그램의 흐름과 여러 범용 작업을 처리하는 중앙처리장치예요. GPU(Graphics Processing Unit)는 많은 데이터에 비슷한 계산을 병렬로 수행하도록 구성된 처리 장치고요. 원래 그래픽 처리에서 출발했지만 여기서는 일반 계산을 맡겨요. ↩︎
CUDA는 NVIDIA GPU에서 일반 계산 코드를 실행하도록 제공하는 프로그래밍 플랫폼이에요. GPU용 코드를 작성하는 방법과 컴파일 도구, 메모리·실행을 관리하는 기능을 함께 제공해요. ↩︎
가상 주소는 프로그램이 데이터를 가리킬 때 쓰는 주소예요. RAM의 실제 위치와 바로 같다고 보면 안 되고, 주소 변환을 거쳐 실제 저장 위치에 연결돼요. 포인터에 적힌 주소와 데이터가 놓인 자리를 따로 보는 이유랍니다. ↩︎
동기화(synchronization)는 여러 작업 사이에 먼저 끝나야 할 일과 그 뒤에 할 일의 순서를 정하는 거예요. 이 글에서는 GPU가 값을 다 쓴 다음 CPU가 읽도록 기다리는 경우가 대표적이에요. ↩︎
캐시는 처리 장치 가까이에 데이터 사본을 잠시 보관해 메모리에 다시 다녀오는 횟수를 줄이는 저장소예요. 캐시 일관성(cache coherence)은 같은 데이터의 사본들이 서로 어긋난 값을 계속 보여주지 않도록 맞추는 성질이에요. CPU와 GPU가 동시에 같은 값을 수정해도 된다는 뜻은 아니라서, 접근 순서를 정하는 동기화도 필요해요. ↩︎
Jetson AGX Orin은 CPU와 NVIDIA GPU를 한 칩에 통합한 시스템을 사용하는 개발 플랫폼이에요. 일반적인 외장 GPU PC와 달리 CPU와 GPU가 같은 물리 메모리를 사용해요. 본문의 장치 출력은 그중 Developer Kit에서 확인한 것이에요. ↩︎
API(Application Programming Interface)는 프로그램이 다른 소프트웨어의 기능을 요청할 때 사용하는 호출 방법이에요. 여기서는
cudaMallocManaged처럼 함수에 인자를 넘겨 메모리를 확보하는 호출이 해당돼요. ↩︎DRAM(Dynamic Random Access Memory)은 실행 중인 코드와 데이터를 담는 주 메모리에 널리 쓰이는 저장 장치예요. 전원을 끄면 내용이 사라지므로 파일을 오래 보관하는 SSD와는 역할이 달라요. 여기서 system DRAM은 CPU 쪽 주 메모리, VRAM은 GPU 전용 메모리를 가리켜요. ↩︎
CPU thread는 CPU 쪽 프로그램에서 코드를 차례대로 실행하는 흐름 하나예요. 앞에서 더하기를 맡았던 GPU thread와는 별개예요. 이 예제에서는 CPU의 그 흐름이 GPU 작업 완료를 기다렸다가 결과를 읽어요. ↩︎
Pageable memory는 운영체제가 물리 메모리의 연결이나 배치를 바꿀 수 있는 일반적인 host memory예요. RAM에 계속 고정해두는 pinned memory와 구분해요.
pageableMemoryAccess는 이런 system allocation까지 GPU의 Unified Memory 접근 범위에 들어가는지 확인하는 속성이에요. ↩︎System allocation은
cudaMallocManaged같은 CUDA 전용 함수 대신 일반적인 시스템·언어 기능으로 마련한 메모리예요.malloc은 C의 동적 메모리 할당 함수,new는 C++에서 객체를 만들고 저장 공간을 확보하는 연산자,mmap은 파일 또는 파일과 연결하지 않은 익명 메모리 영역을 프로세스 주소 공간에 연결하는 시스템 호출이에요. ↩︎Prefetch는 곧 쓸 데이터를 실제 접근보다 먼저 준비하는 일이에요. 여기서는 지원하는 시스템에서 지정한 CPU·GPU 쪽으로 데이터를 미리 옮기도록 요청하고,
Async는 CPU가 이동 완료까지 기다리는 호출이 아니라는 뜻이에요. 이 함수가 쓰는 작업 순서 단위가 stream이며, 실제 사용 전에는 같은 stream의 순서나 명시적인 동기화로 완료를 확인해줘야 해요. (CUDA 메모리 안내) ↩︎I/O(Input/Output)는 처리 장치가 외부 장치와 데이터를 주고받는 입출력을 뜻해요. 여기서는 GPU 같은 장치가 CPU 쪽 메모리에 접근하는 경로를 말하며, one-way는 CPU 캐시의 변경을 GPU가 볼 수 있는 방향의 지원이라는 뜻이에요. 반대 방향의 GPU 캐시 관리까지 없애주는 기능은 아니랍니다. (Tegra I/O coherency) ↩︎
Compile target은 소스 코드를 실행 코드로 바꿀 때 어느 하드웨어용으로 만들지 지정하는 대상이에요.
sm_87은 compute capability 8.7 GPU용 기계어를 생성하라는 표기예요. ↩︎