Source: 07 Concurrency
안녕하세요~ 오늘은 복사하고, 계산하고, 다시 복사하는 동안 생기는 대기 시간을 좀 줄여보려고 해요ㅎㅎ
CUDA1에서는 CPU 쪽을 host, GPU 쪽을 device라고 부르죠. Host memory는 CPU가 사용하는 system RAM이고, 여기서 다룰 device memory는 GPU에 달린 memory예요. 입력이 처음에 host memory에 있으니 GPU에서 계산하려면 device memory로 옮겨줘야 해요.
그래서 기본 흐름은 host memory의 입력을 device memory로 복사하고, GPU에서 계산한 뒤, 결과를 host memory로 가져오는 순서예요. 하나씩 전부 끝내고 다음 일을 시작하면 그만큼 기다리게 되겠죠.
그런데 서로 다른 데이터라면 한쪽을 계산하는 동안 다른 쪽을 복사할 수도 있어요. 오늘 볼 stream은 GPU에 보낼 작업의 순서를 묶어두는 단위예요. 이 순서에 맞춰 복사와 계산을 배치해볼 거랍니다.
Host Memory와 Device Memory
먼저 데이터를 둘 자리를 준비해볼게요. 할당(allocation)은 프로그램에서 쓸 memory 영역을 확보하고 시작 주소를 pointer로 돌려받는 일이에요. Pointer는 그 memory 주소를 담는 변수고요.
Host memory는 malloc으로 할당해서 free로 해제해요. Device memory는 cudaMalloc으로 할당하고 cudaFree로 해제하는데, 여기서 받은 pointer는 GPU가 접근하는 영역을 가리켜요. 두 pointer가 서로 다른 memory를 가리키니 CPU가 malloc 영역에 쓴 값을 GPU에서 읽으려면 복사가 필요하답니다.
아래에서 N은 float2 원소의 개수, bytes는 그 원소들의 전체 byte 수예요. Memory 크기를 담는 정수 타입으로 size_t를 쓰고요.
CPU가 입력을 채울 곳은 h_x, 결과를 받을 host memory는 h_y예요. 같은 크기의 device memory가 d_x, d_y고요. 이름이 네 개나 나왔지만 이 글에서는 끝까지 같은 뜻으로 쓸게요. 입력 한 쌍, 출력 한 쌍이라고 보시면 돼요~
const size_t N = 1000;
const size_t bytes = N * sizeof(float);

float *h_x = (float *)malloc(bytes);   // host memory 입력
float *h_y = (float *)malloc(bytes);   // host memory 출력
float *d_x = nullptr;
float *d_y = nullptr;
cudaMalloc(&d_x, bytes);               // device memory 입력
cudaMalloc(&d_y, bytes);               // device memory 출력
H2D Copy, Kernel Launch, D2H Copy
Host memory에서 device memory로 복사하는 걸 H2D(Host to Device) copy, 돌아오는 방향을 D2H(Device to Host) copy라고 해요. cudaMemcpy의 마지막 인자에 어느 방향으로 복사할지 적어주면 돼요.
그다음에는 GPU에서 실행할 함수, kernel을 <<<grid, block>>>으로 호출해요. 이 호출이 kernel launch예요. Kernel을 실행하는 GPU의 작업 단위가 thread, 함께 배치되는 thread 묶음이 block이고, 여기서 grid는 block의 개수를 나타내요.
계산 자체는 간단하게 둘게요. 아래 transform 하나를 끝까지 사용할 건데, 입력 x의 각 원소에 2를 곱해서 출력 y의 같은 번호 자리에 써요. 원소마다 두 배씩 해주는 kernel이에요.
__global__ void transform(const float *x, float *y, size_t count) {
    const size_t i = blockIdx.x * blockDim.x + threadIdx.x;
    if (i < count) {
        y[i] = x[i] * 2.0f;
    }
}
__global__은 GPU에서 실행할 kernel이라는 표시예요. blockIdx.x는 grid 안에서 이 block이 몇 번째인지, blockDim.x는 block 하나의 thread 수, threadIdx.x는 block 안에서 이 thread가 몇 번째인지 알려줘요.
세 값을 조합한 i가 이번 thread가 맡을 원소 번호예요. count보다 크거나 같은 번호는 처리하지 않도록 조건을 붙였어요. 배열 끝을 넘어가서 쓰면 곤란하겠죠ㅎㅎ
Launch에 넣을 block은 block 하나의 thread 수, grid는 필요한 block 개수예요. GPU가 thread를 32개 단위로 실행하니까 block당 thread 수는 32의 배수로 잡고, 여기서는 256을 쓸게요.
Thread 하나가 원소 하나씩 맡으니 N / 256개의 block이 필요해요. 나누어떨어지지 않으면 마지막 원소들도 맡아줄 block이 있어야 하니 올림하고요. Kernel이 device memory에 결과를 쓰면 D2H copy로 host memory에 가져와요.
const int block = 256;
const int grid = (N + block - 1) / block;

cudaMemcpy(d_x, h_x, bytes, cudaMemcpyHostToDevice);   // H2D copy
transform<<<grid, block>>>(d_x, d_y, N);                // kernel launch
cudaMemcpy(h_y, d_y, bytes, cudaMemcpyDeviceToHost);   // D2H copy
이 세 줄은 순서를 바꿀 수 없어요. 입력이 device memory에 도착해야 kernel이 읽을 수 있고, kernel이 결과를 다 써야 D2H copy로 가져올 수 있거든요.
데이터 하나를 통째로 처리하면 H2D copy, kernel, D2H copy가 차례로 이어져요. H2D copy 시간 $T_H$, kernel 시간 $T_K$, D2H copy 시간 $T_D$를 전부 더한 게 전체 시간이에요. 기다리는 시간도 그대로 더해지네요..
$$ T_{\text{serial}} = T_H + T_K + T_D $$그럼 다른 데이터는 어떨까요? 첫 번째 입력을 kernel이 계산하는 동안 복사 전용 장치인 copy engine이 두 번째 입력을 H2D copy하면, 계산 장치와 복사 장치가 같은 시간에 일할 수 있어요.
다만 이때 copy engine은 CPU가 다음 코드로 넘어간 뒤에도 host memory를 계속 읽어야 해요. 그래서 stream 코드로 바로 가기 전에, 운영체제가 그 memory를 어떻게 관리하는지 잠깐 보고 갈게요.
Page와 Pageable Memory
운영체제는 host memory를 page라는 일정한 크기로 나눠 관리해요. 흔한 page 크기는 4KB예요. 프로그램은 실제 RAM 위치와 구분되는 가상 주소를 사용해요. 그 주소 범위를 나눈 조각이 virtual page이고, 실제 RAM을 같은 크기로 나눈 자리가 page frame이에요. 어느 virtual page가 어느 page frame에 놓였는지는 page table에 적혀 있고요.
malloc으로 할당하면 우선 프로그램 주소 공간의 page를 잡아요. 실제 RAM은 그 주소를 처음 읽거나 쓸 때 붙는답니다. 이렇게 필요할 때 RAM과 연결하고, 나중에는 그 연결이 바뀔 수도 있는 host memory를 pageable memory라고 해요.
Page Fault
프로그램이 아직 RAM에 없는 page를 읽거나 쓰려고 하면 page fault가 발생해요. 운영체제가 개입해서 그 page에 RAM을 붙여달라는 신호예요.
그런데 RAM도 부족하면요? 운영체제는 한동안 쓰지 않은 page 내용을 disk로 내보내고 자리를 비워요. 그 내용을 보관하는 disk 영역이 swap 또는 page file이에요. 나중에 그 page를 다시 읽으면 page fault가 또 나고, 이번에는 disk에서 RAM으로 되가져온답니다.
덕분에 pageable memory로는 RAM보다 큰 데이터도 다룰 수 있어요. 대신 어떤 page가 RAM에 남아 있는지는 계속 달라질 수 있고, 필요한 page가 없을 때마다 운영체제가 개입해야 해요. 주소가 있다고 늘 RAM에 대기 중인 건 아니네요.
Pinned Memory
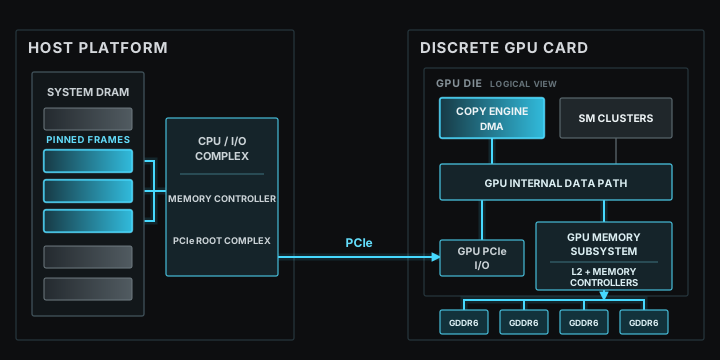
GPU에는 host memory와 device memory 사이의 복사를 전담하는 hardware, copy engine이 있어요. 여기서는 RAM에 고정한 host memory를 읽는 pinned H2D 경로를 따라가볼게요.
Copy engine이 실행하는 DMA(Direct Memory Access)는 CPU에서 명령을 실행하는 계산 단위인 core가 byte를 하나하나 옮기는 대신 전용 hardware로 memory 사이의 데이터를 옮기는 방식이에요. CPU가 비동기 복사 함수인 cudaMemcpyAsync3를 호출하면 CUDA runtime4이 요청을 CUDA driver에 넘겨요. GPU에 작업을 제출하는 software인 driver는 원본 주소, 목적지 주소, 크기를 담은 복사 명령을 GPU에 보내고요. Copy engine이 그 명령을 처리하는 동안 CPU는 다음 코드를 실행할 수 있어요.
CPU와 별도 card에 달린 discrete GPU는 host system과 PCIe(PCI Express)라는 데이터 연결 통로로 이어져요. CPU의 주 memory인 system DRAM에서 읽은 데이터는 CPU의 입출력(I/O) 경로와 PCIe root complex를 거쳐 PCIe로 나가요. Root complex는 CPU 쪽에서 PCIe 장치를 연결하는 hardware예요.
GPU에 도착하면 GPU의 PCIe I/O와 내부 데이터 경로를 지나 메모리에 데이터를 전달하는 장치들의 묶음인 GPU memory subsystem으로 들어가요. 이 subsystem에는 최근 데이터를 잠시 보관하는 L2 cache5와 GPU memory의 읽기·쓰기를 맡는 memory controller가 있어요. GPU 안의 copy engine이 이 H2D 전송을 실행하는 거예요.
정확한 내부 배치는 GPU architecture마다 달라요. 아래 그림에는 공개된 연결 관계까지만 담아뒀으니, 데이터를 따라가는 경로로 봐주세요.
그런데 copy engine이 복사하는 동안에는 같은 RAM page를 계속 읽을 수 있어야 해요. 아직 읽는 중인데 운영체제가 다른 frame으로 옮기거나 disk로 내보내면 안 되겠죠.
Pageable memory로는 이 조건을 보장할 수 없어요. 그래서 CUDA가 운영체제에 해당 page frame을 RAM에 그대로 두라고 요청해요. 이렇게 RAM에 고정한 host memory가 pinned memory예요. Page가 disk로 나가지 않으니 non-pageable memory라고도 부른답니다.
Pinned memory는 cudaHostAlloc으로 만들고 cudaFreeHost로 해제해요. malloc처럼 host memory를 돌려주되, 받은 pointer가 pinned memory를 가리킨다는 점이 달라요.
참, 이름에 CUDA가 붙어 있어도 cudaHostAlloc이 만드는 건 host memory예요. 데이터를 복사해주는 함수도 아니고, device memory를 만드는 cudaMalloc을 대신하는 것도 아니에요. Host 쪽을 pinned memory로 바꿔도 device memory는 cudaMalloc으로 따로 준비해야 한답니다.
| 함수 | 만드는 영역 |
|---|---|
malloc / free | pageable host memory |
cudaHostAlloc / cudaFreeHost | pinned host memory |
cudaMalloc / cudaFree | device memory |
아래 cudaHostAllocDefault는 추가 옵션 없이 기본 pinned allocation을 만들겠다는 값이에요.
const int N = 1000;
const size_t bytes = N * sizeof(float);

float *h_x = nullptr;
float *h_y = nullptr;
// 앞 절의 pageable 버전
// float *h_x = (float *)malloc(bytes);
// float *h_y = (float *)malloc(bytes);
cudaHostAlloc(&h_x, bytes, cudaHostAllocDefault);   // pinned input
cudaHostAlloc(&h_y, bytes, cudaHostAllocDefault);   // pinned output

float *d_x = nullptr;
float *d_y = nullptr;
cudaMalloc(&d_x, bytes);                            // device input
cudaMalloc(&d_y, bytes);                            // device output

// ... H2D copy, kernel, D2H copy ...

// 앞 절의 pageable 버전
// free(h_x);
// free(h_y);
cudaFreeHost(h_x);
cudaFreeHost(h_y);
cudaFree(d_x);
cudaFree(d_y);
이미 malloc으로 만들어둔 영역을 고정하고 싶으면 cudaHostRegister를 쓰면 돼요. 나중에 영역은 남겨두고 고정만 풀 때는 cudaHostUnregister를 쓰고요. 새로 할당하는 경우와 나눠서 보시면 돼요.
편하다고 host memory를 전부 고정하고 싶어질 수도 있는데요.. RAM은 한정돼 있어요. Pinned memory는 실제 RAM을 그만큼 차지하므로 RAM 크기보다 많이 만들 수 없고, 한도를 넘으면 cudaHostAlloc이 memory 부족 오류를 돌려줘요.
큰 영역을 계속 붙잡아두면 운영체제가 쓸 RAM이 줄어 host 실행까지 느려져요. 그래서 GPU와 데이터를 주고받는 영역만 pinned memory로 만들어요. 복사 좀 편하게 하려다가 CPU 쪽까지 답답해지면 안 되겠죠 ^^;;
비동기 호출과 cudaMemcpyAsync
비동기 호출에서는 CPU가 GPU 작업이 끝나기를 기다리지 않고 다음 줄로 넘어가요. Kernel launch는 원래 비동기라서 kernel이 아직 실행 중이어도 CPU는 다음 코드를 실행한답니다.
Copy도 이런 방식으로 요청할 때 cudaMemcpyAsync를 써요. 인자는 cudaMemcpy와 같고, 마지막에 stream 하나가 더 붙어요. 이 글처럼 CPU 실행과 H2D 또는 D2H copy를 겹치려면 host 쪽 pointer가 pinned memory를 가리켜야 해요. 이 조건을 갖추면 copy가 끝나기 전에 CPU가 호출에서 돌아오고, copy engine은 계속 복사해요.
예를 들어 d_y에서 h_y로 결과를 가져오는 D2H copy를 비동기로 요청하면, CPU는 복사가 끝나기 전에 다른 코드를 실행할 수 있어요.
그런데 여기서 바로 h_y를 읽으면 안 돼요. 호출이 돌아왔을 뿐 결과는 아직 오는 중일 수 있거든요. 성급하게 열어보지 말고 조금 기다려주세요ㅎㅎ
CPU: D2H copy 요청 → 복사와 무관한 CPU 코드 → stream 대기 → h_y 사용
GPU:                 D2H copy 진행
cudaStreamSynchronize(stream)을 호출하면 그 stream의 작업이 모두 끝날 때까지 CPU가 기다려요. 이 대기가 끝난 다음에 h_y를 읽으면 된답니다.
그리고 비동기 호출이라고 해서 두 GPU 작업이 반드시 같은 시간에 실행되는 건 아니에요. CPU는 호출에서 일찍 돌아왔어도, GPU 안에서는 두 작업이 차례로 실행될 수 있어요.
CPU가 기다리는지와 GPU에서 실제로 겹치는지는 따로 봐야겠죠. 어떤 작업을 어떤 순서로 실행할지는 이제 stream으로 정해볼게요.
Stream
Stream은 GPU에 보낸 작업의 순서를 묶어두는 단위예요. 두 가지 규칙을 알고 보면 뒤의 코드도 따라가기 편해요.
규칙 1) 같은 stream에서는 제출한 순서를 지켜요. H2D copy, kernel, D2H copy를 한 stream에 넣었다면 H2D copy가 끝나야 kernel이 실행되고, kernel이 끝나야 D2H copy가 시작돼요. 입력이 도착하고 계산하고 결과를 가져오는 순서가 그대로 유지되는 거예요.
규칙 2) 서로 다른 stream 사이에는 정해진 순서가 없어요. CUDA가 어느 작업부터 시작할지 보장하지 않아서, 한쪽이 먼저 실행될 수도 있고 동시에 실행되거나 나중에 실행될 수도 있어요.
동시에 실행하려는 작업은 서로 다른 stream에 넣어야 해요. 그래도 GPU에 copy와 계산을 함께 실행할 여유가 없다면 결국 차례로 실행돼요. Stream을 나눠줬다고 자리까지 생기지는 않는답니다.
Stream은 cudaStream_t 타입으로 선언하고 cudaStreamCreate로 만들어요. 이렇게 만든 stream을 cudaMemcpyAsync의 마지막 인자와 kernel launch의 <<<>>> 네 번째 인자에 넣으면 돼요.
중간에 있는 <<<grid, block, 0, stream>>>의 0도 잠깐 볼게요. 세 번째 인자는 block 안의 thread들이 함께 쓰는 GPU의 작은 memory, shared memory를 실행 중에 추가로 확보할 byte 수예요. 이번에는 추가 공간이 필요 없어서 0을 넣었어요.
cudaStream_t stream;
cudaStreamCreate(&stream);

cudaMemcpyAsync(d_x, h_x, bytes, cudaMemcpyHostToDevice, stream);
transform<<<grid, block, 0, stream>>>(d_x, d_y, N);
cudaMemcpyAsync(h_y, d_y, bytes, cudaMemcpyDeviceToHost, stream);

cudaStreamSynchronize(stream);
cudaStreamDestroy(stream);
세 호출 모두 CPU는 먼저 다음 줄로 넘어갈 수 있어요. GPU 쪽에서는 같은 stream의 순서를 따라 H2D copy가 끝난 뒤 kernel, kernel이 끝난 뒤 D2H copy를 실행하고요. 같은 데이터의 H2D copy → kernel → D2H copy 순서를 stream이 지켜주는 거예요.
그 stream의 작업이 전부 끝날 때까지 CPU를 기다리게 하려면 cudaStreamSynchronize를 써요. 기다리지 않고 stream이 비었는지만 확인할 때는 cudaStreamQuery를 쓰고, 다 쓴 stream은 cudaStreamDestroy로 없애면 돼요.
Chunk
큰 배열을 통째로 처리하면 입력 전체를 H2D copy할 때까지 kernel이 기다려요. D2H copy도 kernel 전체가 끝나야 시작하고요.
이 대기를 줄이려고 배열을 여러 구간으로 나눠볼 거예요. 이렇게 나눈 데이터 조각 하나가 chunk예요. 도착한 조각부터 계산할 수 있다면 뒤쪽 입력을 복사하는 동안에도 할 일이 생기겠죠~
원소 8개짜리 배열에서 y[i] = x[i] * 2를 계산한다고 해볼게요. i는 0부터 7까지예요. 원소 4개씩 자르면 x[0]x[3]이 chunk 0, x[4]x[7]이 chunk 1이 돼요.
y[0]~y[3]을 계산할 때는 각각 같은 번호의 x 값만 있으면 돼요. Chunk 1의 값을 기다릴 이유가 없으니 두 chunk를 독립적으로 처리할 수 있답니다.
Chunk 0의 H2D copy, kernel, D2H copy를 H0, K0, D0이라고 부르고 stream 0에 넣을게요. Chunk 1의 H1, K1, D1은 stream 1에 넣고요. 각 stream 안에서는 H0 → K0 → D0, H1 → K1 → D1 순서를 지켜요.
두 stream 사이에는 정해진 순서가 없죠. GPU가 copy와 kernel을 동시에 실행할 수 있다면 K0을 계산하는 동안 H1을 복사할 수 있어요. K1을 계산하면서 D0을 복사할 수도 있고요. 이제 기다리던 자리에 다른 chunk의 일이 들어가네요ㅎㅎ
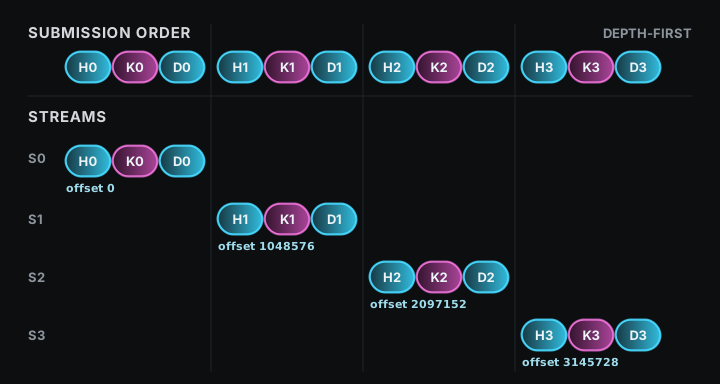
반복문에서는 chunk 하나의 세 작업을 전부 제출하고 다음 chunk로 넘어가요. chunk % streamCount에 따라 chunk 0은 stream 0, chunk 1은 stream 1, chunk 2는 stream 2, chunk 3은 stream 3에 들어가요.
아래 그림의 맨 위는 CPU가 제출하는 순서예요. 그 아래 네 줄에는 각 작업을 어느 stream에 넣었는지 표시했어요.
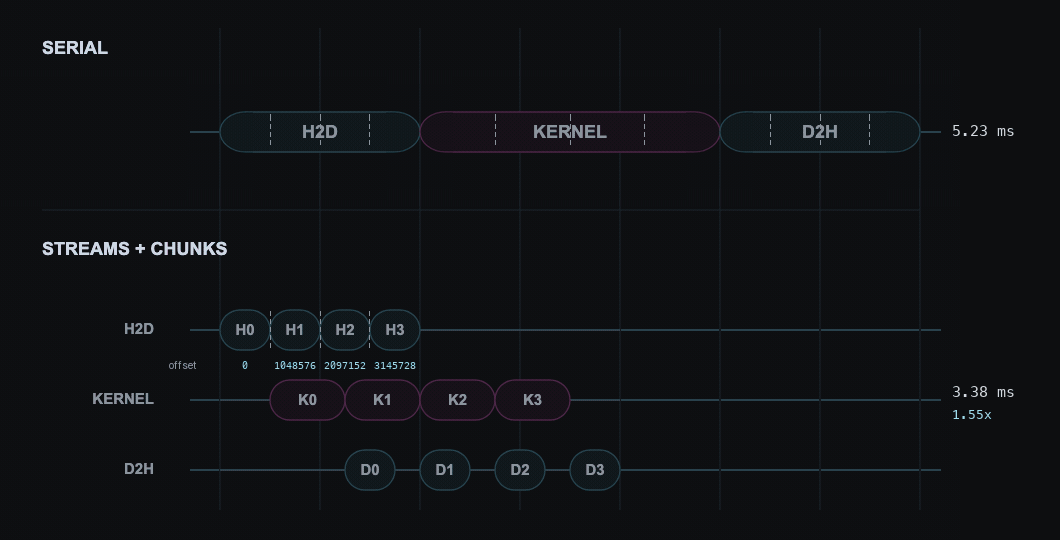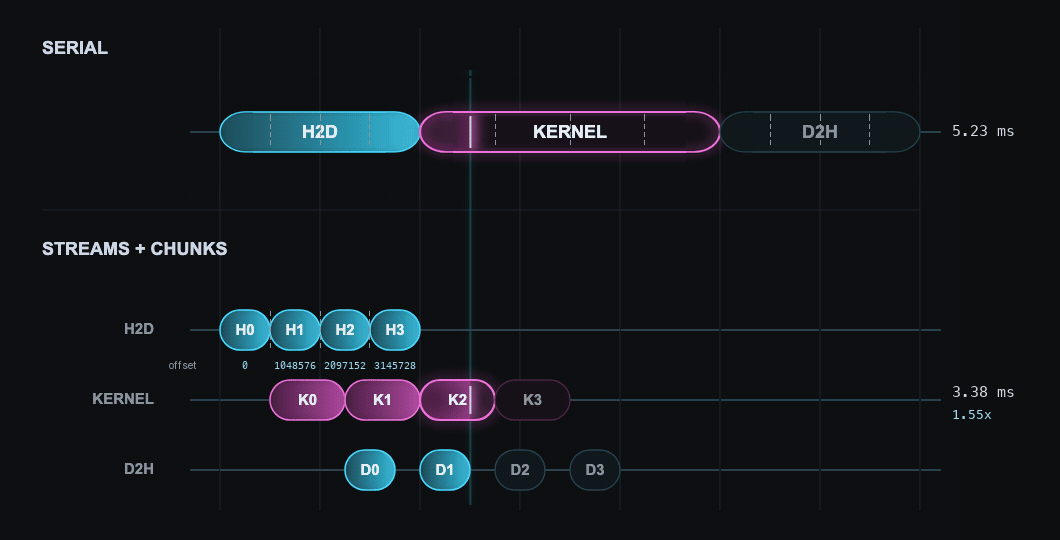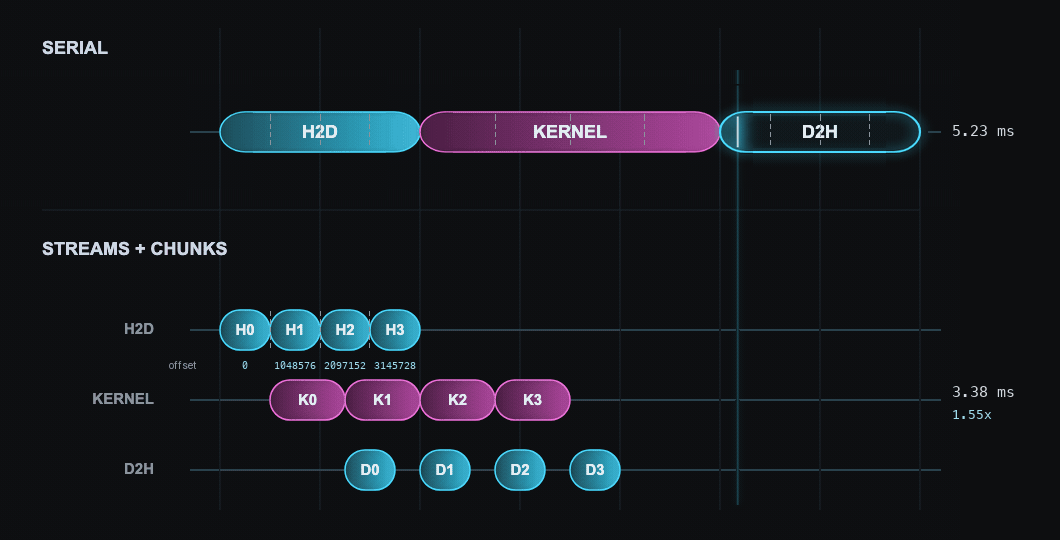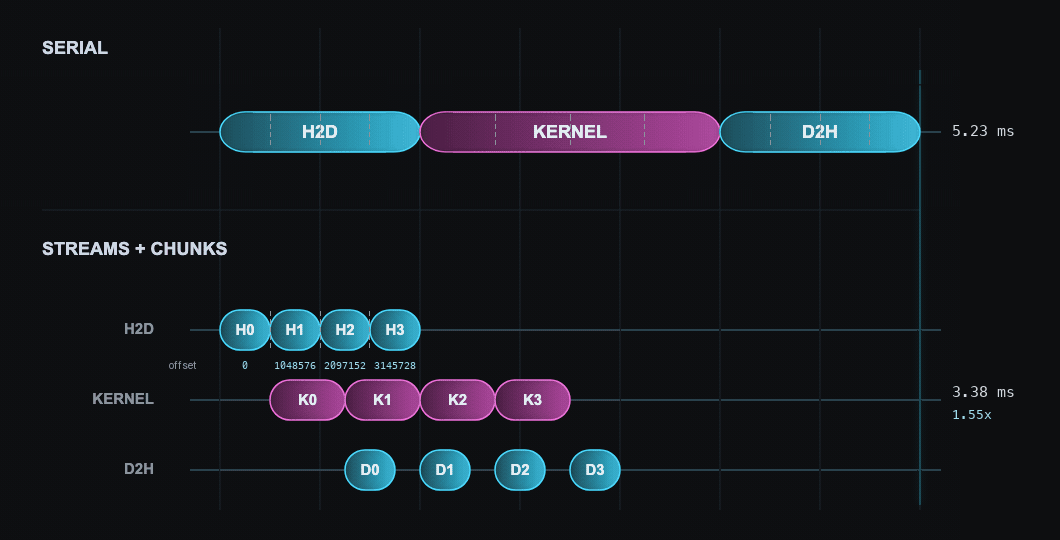
위 그림의 두 행은 가로 축척을 같게 맞췄어요. 직렬 막대 안의 점선은 그 막대를 chunk 4개 몫으로 나눈 자리예요. 점선 한 칸의 가로 길이와 아래 chunk 하나의 가로 길이가 같으니, 처리하는 작업량도 같아요.
일을 덜 한 건 아니고 같은 일을 시간축의 다른 자리에 놓은 거예요. 그림 오른쪽의 시간은 NVIDIA A100에서 측정한 값이랍니다.6 측정 환경의 표기7와 반복 측정 통계8도 각주에 풀어뒀어요.
코드에서는 stream을 여러 개 만들어놓고 chunk마다 돌려 쓰면 돼요. Device memory도 배열 전체 크기로 한 번만 할당해요. 각 chunk가 시작하는 위치를 offset으로 옮겨가며 쓸 거예요.
offset은 배열 시작에서 몇 번째 원소부터가 이번 chunk인지를 나타내요. d_x + offset은 d_x 위치에서 원소 offset개만큼 뒤로 간 주소고요. 반복문이 offset을 chunkElements9씩 늘리므로 chunk마다 같은 배열의 다른 구간을 가리키게 돼요.
constexpr int streamCount = 4;
constexpr size_t N = 1ULL << 24;          // 16,777,216개
constexpr size_t chunkElements = 1 << 20; // 1,048,576개
constexpr size_t bytes = N * sizeof(float);

float *h_x = nullptr;
float *h_y = nullptr;
float *d_x = nullptr;
float *d_y = nullptr;

// pinned memory를 쓰기 전의 pageable 버전
// float *h_x = (float *)malloc(bytes);
// float *h_y = (float *)malloc(bytes);
cudaHostAlloc(&h_x, bytes, cudaHostAllocDefault);
cudaHostAlloc(&h_y, bytes, cudaHostAllocDefault);
cudaMalloc(&d_x, bytes);   // device memory는 두 버전이 같다
cudaMalloc(&d_y, bytes);

for (size_t i = 0; i < N; ++i) {   // host가 입력 값을 채운다
    h_x[i] = static_cast<float>(i);
}

cudaStream_t streams[streamCount];
for (int i = 0; i < streamCount; ++i) {
    cudaStreamCreate(&streams[i]);
}

constexpr size_t chunkBytes = chunkElements * sizeof(float);
constexpr int block = 256;
constexpr int grid = chunkElements / block;   // 4096

for (size_t chunk = 0, offset = 0; offset < N;
     ++chunk, offset += chunkElements) {
    cudaStream_t stream = streams[chunk % streamCount];

    // 동기 버전에는 stream 인자가 없다
    // cudaMemcpy(d_x + offset, h_x + offset, chunkBytes,
    //            cudaMemcpyHostToDevice);
    cudaMemcpyAsync(d_x + offset, h_x + offset, chunkBytes,
                    cudaMemcpyHostToDevice, stream);

    transform<<<grid, block, 0, stream>>>(
        d_x + offset, d_y + offset, chunkElements);

    cudaMemcpyAsync(h_y + offset, d_y + offset, chunkBytes,
                    cudaMemcpyDeviceToHost, stream);
}

cudaDeviceSynchronize();

for (int i = 0; i < streamCount; ++i) {
    cudaStreamDestroy(streams[i]);
}

// pinned memory를 쓰기 전의 pageable 버전
// free(h_x);
// free(h_y);
cudaFreeHost(h_x);
cudaFreeHost(h_y);
cudaFree(d_x);
cudaFree(d_y);
여기서는 N이 16,777,216개이고 chunkElements가 1,048,576개니까 chunk가 16개 나와요. Stream은 4개예요. chunk % streamCount로 돌려 쓰니 chunk 0, 4, 8, 12가 stream 0에, chunk 1, 5, 9, 13이 stream 1에 들어가요.
h_x와 h_y는 비동기 H2D와 D2H copy에 쓰니까 둘 다 pinned memory로 만들었어요. d_x, d_y는 device memory고요. 반복문 한 바퀴에서 chunk 하나의 세 작업을 같은 stream에 제출해요.
마지막 chunk까지 제출했으면 cudaDeviceSynchronize10로 device의 전체 작업을 기다려요. GPU가 다 쓴 다음에 stream과 memory를 해제하는 순서예요. 제출이 끝났다고 바로 치우면 안 되겠죠ㅎㅎ
이렇게 한 chunk의 세 작업을 먼저 제출하고 다음 chunk로 넘어가는 걸 depth-first11 제출 순서라고 해요. 이름은 뒤의 각주에 반대 순서와 나란히 적어뒀어요.
Stream이 4개라서 chunk 4는 chunk 0이 사용한 stream 0에 다시 들어가요. 같은 stream의 순서를 지키니까 chunk 0의 D2H copy가 끝난 다음 chunk 4의 H2D copy가 시작돼요.
Memory 할당과 stream 생성은 반복문 전에 한 번만 해둬요. Chunk마다 새로 준비할 필요는 없거든요. 반복문 안에서는 H2D copy, kernel launch, D2H copy를 제출하면서 미리 만든 memory와 stream을 계속 쓰면 된답니다.
실제로 얼마나 겹치는지는 chunk의 복사량과 kernel 실행 시간에 따라 달라져요. Kernel이 아주 짧으면 copy와 겹쳐도 줄어드는 시간은 작아요.
GPU에 H2D와 D2H를 동시에 처리할 수 있는 copy engine 구성이 있다면, 다음 chunk의 H2D와 이전 chunk의 D2H가 겹치는 쪽에서 더 큰 이득이 날 수 있어요. Kernel만 쳐다보고 있으면 이 부분을 놓치겠네요.
Default Stream
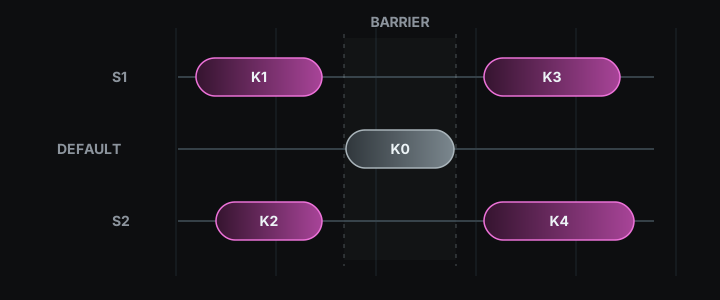
Stream을 따로 적지 않은 kernel launch와 cudaMemcpy는 default stream에 들어가요. 기본 설정은 legacy default stream12이에요.
이걸 앞에서 cudaStreamCreate로 만든 stream과 함께 쓰면 기다리는 관계가 생겨요. 다른 stream에 먼저 제출된 작업이 전부 끝나야 default stream 작업이 시작돼요. 또 default stream 작업이 끝나야 다른 stream에 그 뒤로 제출한 작업이 시작되고요. 중간에 하나 끼었는데 앞뒤로 기다리게 되는 거예요.
아래에서는 앞 절의 chunk 세 개를 제출하면서 가운데 한 줄에만 stream 인자를 빠뜨렸어요. c는 chunk 하나의 원소 수고, 세 launch가 각각 chunk 0, 1, 2를 처리해요. B 줄을 봐주세요.
const size_t c = chunkElements;

transform<<<grid, block, 0, streams[0]>>>(d_x,         d_y,         c);  // A: chunk 0
transform<<<grid, block>>>               (d_x + c,     d_y + c,     c);  // B: stream 인자 누락
transform<<<grid, block, 0, streams[1]>>>(d_x + 2 * c, d_y + 2 * c, c);  // C: chunk 2
B에는 stream 인자가 없으니 legacy default stream으로 들어가요. 그래서 A가 끝나야 B가 시작하고, B가 끝나야 C가 시작돼요. 원래 서로 다른 stream에서 겹칠 수 있었던 A와 C까지 차례로 기다리게 됐네요.
인자 하나 빠졌을 뿐인데.. 줄줄이 기다리고 있어요ㅠㅠ 겹쳐 실행할 구간에서는 모든 copy와 kernel launch에 직접 만든 stream을 적어줘야 해요.
CUDA C++ 코드를 실행 코드로 바꾸는 컴파일러에 nvcc --default-stream per-thread 옵션을 주면 CPU thread13마다 default stream이 따로 생겨요. 그러면 위의 B가 A와 C 사이를 자동으로 막지 않아요. 이미 default stream을 쓰도록 작성된 코드를 직접 만든 stream과 함께 사용할 때 쓸 수 있는 옵션이에요.
Host 함수를 Stream에 넣기
Stream에는 CPU에서 실행할 함수도 넣을 수 있어요. cudaLaunchHostFunc가 그 함수를 stream 작업 하나로 넣어줘요.
아래 stream은 cudaStreamCreate로 만든 거예요. transform의 결과를 CPU 함수 process에서 읽으려면 같은 stream에 kernel, D2H copy, host 함수 순서로 넣으면 돼요. CUDART_CB는 CUDA가 이 CPU 함수를 호출할 때 필요한 함수 형태를 표시해요.
void CUDART_CB process(void *data) {
    float *result = static_cast<float *>(data);
    // result를 CPU에서 처리한다. CUDA API는 호출하지 않는다.
}

transform<<<grid, block, 0, stream>>>(d_x, d_y, N);
cudaMemcpyAsync(h_y, d_y, bytes, cudaMemcpyDeviceToHost, stream);
cudaLaunchHostFunc(stream, process, h_y);
이렇게 넣은 process는 D2H copy까지 끝난 다음 호출돼요. 그래서 완성된 h_y를 읽을 수 있답니다. Stream은 process가 반환될 때까지 다음 작업으로 넘어가지 않고요.
다만 process 안에서는 kernel launch나 cudaMalloc 같은 CUDA API를 호출하면 안 돼요. 이 함수에서는 CPU가 할 결과 처리만 해주세요.
CUDA Event
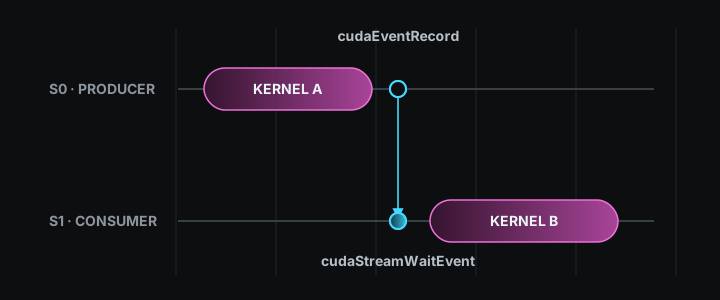
이번에는 stream 안에 표시를 하나 남겨볼게요. CUDA event는 stream의 한 위치를 표시해요. cudaEventRecord로 event를 넣으면 앞선 작업이 모두 끝나 그 위치에 도달했을 때 event가 완료돼요.
Kernel 시간을 잴 때는 같은 stream에 시작 event, kernel, 종료 event를 차례로 넣어요. 어디부터 어디까지 잴지 앞뒤에 표시해두는 거예요.
cudaEvent_t start;
cudaEvent_t stop;
cudaEventCreate(&start);
cudaEventCreate(&stop);

cudaEventRecord(start, stream);
transform<<<grid, block, 0, stream>>>(d_x, d_y, N);
cudaEventRecord(stop, stream);
cudaEventSynchronize(stop);

float milliseconds = 0.0f;
cudaEventElapsedTime(&milliseconds, start, stop);

cudaEventDestroy(start);
cudaEventDestroy(stop);
cudaEventSynchronize(stop)에서 stop event가 완료될 때까지 CPU를 기다리게 해요. 그다음 cudaEventElapsedTime이 start와 stop 사이의 GPU 시간을 milliseconds에 기록해줘요.
Event는 서로 다른 stream 사이에 순서를 만들 때도 써요. 아래 d_z는 d_x, d_y와 같은 크기로 cudaMalloc한 device memory예요. stream0, stream1은 각각 cudaStreamCreate로 만들었고요.
Stream 0의 transform이 d_y에 결과를 쓰면, stream 1의 transform은 그 값을 입력으로 읽어서 d_z에 써요. 그런데 다른 stream끼리는 규칙 2에 따라 순서가 정해지지 않죠. Stream 1의 kernel이 먼저 시작할 수도 있어요.
아직 만들어지지도 않은 결과를 읽으면 곤란하니 순서를 연결해줄게요. Stream 0의 kernel 뒤에 ready event를 기록하고, stream 1의 kernel 앞에서는 그 event를 기다리게 해요.
cudaEvent_t ready;
cudaEventCreate(&ready);

transform<<<grid, block, 0, stream0>>>(d_x, d_y, N);
cudaEventRecord(ready, stream0);

cudaStreamWaitEvent(stream1, ready, 0);
transform<<<grid, block, 0, stream1>>>(d_y, d_z, N);

cudaStreamSynchronize(stream1);
cudaEventDestroy(ready);
여기서 cudaStreamWaitEvent가 기다리게 하는 건 stream 1의 이후 작업이에요. CPU는 이 호출에서 기다리지 않아요. 마지막 인자 0은 별도 동작을 지정하지 않겠다는 뜻이고요.
Device 전체를 세워두지 않고도 stream 0과 stream 1의 kernel 사이에 필요한 순서를 만들었네요~^^
여러 Kernel의 동시 실행
서로 다른 배열을 처리한다면 두 kernel이 서로의 결과를 기다릴 필요가 없어요. 아래 네 pointer는 모두 cudaMalloc으로 bytes 크기씩 할당한 device memory예요. 첫 번째 계산의 입력·출력이 d_x0, d_y0이고, 두 번째가 d_x1, d_y1이에요.
두 kernel을 서로 다른 stream에 넣으면 같은 GPU에서 동시에 실행될 가능성이 생겨요. 여기서 가능성이라고 한 이유가 있답니다.
transform<<<grid, block, 0, stream0>>>(d_x0, d_y0, N);
transform<<<grid, block, 0, stream1>>>(d_x1, d_y1, N);
Kernel의 block이 실제로 배치되는 계산 장치가 SM(Streaming Multiprocessor)이에요. 첫 kernel의 block들이 모든 SM의 실행 자리를 차지했다면 두 번째 kernel은 자리가 날 때까지 기다려야 해요. 다른 stream에 넣었어도 이미 자리가 꽉 찼으니까요.
첫 kernel이 일부 자리만 사용한다면 두 번째 kernel의 block이 남은 자리에 들어가서 같은 시간대에 실행될 수 있어요. Stream을 두 개 만들었다고 늘 두 배로 바빠지는 건 아니네요ㅎㅎ
하나의 kernel로 GPU를 충분히 채울 수 있다면 그 kernel 하나로 처리하는 게 가장 빨라요. 여러 kernel의 동시 실행은 작업이 작은 단위로 들어오고, 그걸 하나의 kernel로 합치기 어려울 때 의미가 있어요.
Stream priority14는 다음 block을 어느 stream의 kernel에서 가져올지 GPU가 결정할 때 참고하는 우선순위예요. 오래 걸리는 background kernel은 낮은 priority에, 빨리 시작해야 하는 짧은 kernel은 높은 priority stream에 넣을 수 있어요.
높은 priority라도 이미 실행 중인 block을 중단시키지는 않아요. SM에 자리가 생겼을 때 높은 priority stream의 다음 block을 먼저 고르는 거예요. Stream은 cudaStreamCreateWithPriority로 만들고, 사용할 수 있는 priority 범위는 cudaDeviceGetStreamPriorityRange로 확인해요.
여러 GPU의 Stream
GPU가 여러 개여도 같은 stream 규칙을 사용해요. 먼저 cudaGetDeviceCount로 GPU 개수를 확인하고, cudaSetDevice로 이후 CUDA 호출을 보낼 GPU를 골라요. 이렇게 선택한 GPU가 current device예요.
Device memory와 stream은 만들 당시의 current device에 묶여요. 아래에서는 d0_x, d0_y, stream0이 GPU 0의 것이고, d1_x, d1_y, stream1이 GPU 1의 것이에요. 각 GPU가 자기 배열에 앞에서 정의한 transform을 실행해요. 어느 GPU를 선택한 상태인지 보면서 따라가주세요~
float *d0_x = nullptr, *d0_y = nullptr;
float *d1_x = nullptr, *d1_y = nullptr;
cudaStream_t stream0;
cudaStream_t stream1;

cudaSetDevice(0);
cudaMalloc(&d0_x, bytes);
cudaMalloc(&d0_y, bytes);
cudaStreamCreate(&stream0);   // GPU 0에 묶인 stream
transform<<<grid, block, 0, stream0>>>(d0_x, d0_y, N);

cudaSetDevice(1);
cudaMalloc(&d1_x, bytes);
cudaMalloc(&d1_y, bytes);
cudaStreamCreate(&stream1);   // GPU 1에 묶인 stream
transform<<<grid, block, 0, stream1>>>(d1_x, d1_y, N);

cudaSetDevice(0);
cudaStreamSynchronize(stream0);
cudaStreamDestroy(stream0);
cudaFree(d0_x);
cudaFree(d0_y);

cudaSetDevice(1);
cudaStreamSynchronize(stream1);
cudaStreamDestroy(stream1);
cudaFree(d1_x);
cudaFree(d1_y);
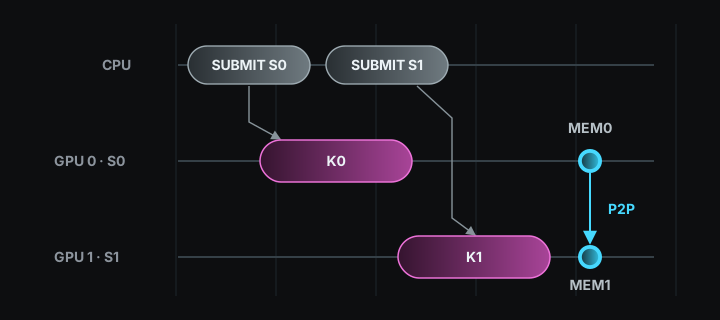
Kernel launch에서 CPU가 기다리지 않으니 GPU 0에 transform을 제출한 뒤 GPU 1에도 바로 제출할 수 있어요. 마지막에는 GPU를 다시 선택해서 각 stream이 끝날 때까지 기다리고요.
GPU끼리 데이터를 옮길 때는 peer access를 쓸 수도 있어요. 한 GPU가 다른 GPU의 memory를 직접 읽고 쓰는 기능인데, 두 GPU가 PCIe나 NVLink15 같은 연결 통로로 이어져 있어야 해요. cudaDeviceCanAccessPeer로 지원 여부를 먼저 확인해요.
두 방향 모두 복사할 거라면 cudaDeviceEnablePeerAccess를 양쪽에서 호출한 뒤 cudaMemcpyPeerAsync로 복사해요. 그러면 host memory를 거치지 않고 한 GPU의 memory에서 다른 GPU의 memory로 바로 이동해요. CPU 쪽으로 한 번 돌아오던 길을 줄일 수 있네요.
Unified Memory와 Prefetch
CPU와 GPU가 같은 포인터로 접근하고 CUDA가 데이터 배치를 관리하는 Unified Memory를 사용할 때도 stream의 순서 규칙은 같아요. Prefetch는 필요한 데이터를 사용하기 전에 미리 준비하는 일이고, cudaMemPrefetchAsync16는 Unified Memory로 만든 영역을 CPU나 GPU 쪽으로 미리 옮겨주는 함수예요.
아래 x, y는 cudaMallocManaged로 할당한 Unified Memory pointer예요. CPU와 GPU에서 같은 pointer로 접근하고요. device는 kernel을 실행할 GPU 번호, cudaCpuDeviceId는 목적지가 CPU 쪽이라는 뜻의 CUDA 상수예요.
const int device = 0;
cudaSetDevice(device);

float *x = nullptr;
float *y = nullptr;
cudaMallocManaged(&x, bytes);
cudaMallocManaged(&y, bytes);

cudaStream_t stream;
cudaStreamCreate(&stream);

cudaMemPrefetchAsync(x, bytes, device, stream);          // 입력을 GPU로 이동
transform<<<grid, block, 0, stream>>>(x, y, N);
cudaMemPrefetchAsync(y, bytes, cudaCpuDeviceId, stream); // 결과를 CPU로 이동
cudaStreamSynchronize(stream);

cudaStreamDestroy(stream);
cudaFree(x);
cudaFree(y);
세 작업을 같은 stream에 넣었으니 GPU 방향 prefetch가 끝나야 kernel이 시작하고, kernel이 끝나야 CPU 방향 prefetch가 시작돼요. 마지막 대기가 끝난 뒤에는 CPU에서 y를 읽을 수 있고요.
이 이동은 page 단위로 일어나요. 어느 page가 어느 물리 메모리를 가리키는지 CPU와 GPU 양쪽의 주소 연결 기록도 고쳐야 해서 실행 시간축에 빈 구간이 생길 수 있어요. 미리 옮기는 경우에도 그 관리 작업은 따라온답니다.
Nsight Systems에서 확인하기
이제 정말 겹쳤는지 봐야겠죠? Stream을 여러 개 만들었다는 것만으로는 확인이 끝나지 않아요ㅎㅎ
Nsight Systems는 프로그램 실행 중 CPU의 CUDA 호출과 GPU의 copy, kernel 실행을 같은 시간축에 기록해서 보여주는 도구예요. GPU에서 두 작업이 같은 시간대에 놓였는지 여기서 확인할 수 있어요.
앞의 chunk 코드를 nvcc로 컴파일한 실행 파일 이름을 overlap이라고 하면, 이렇게 실행해요.
nsys profile --stats=true ./overlap
이 명령은 실행 결과를 report 파일로 저장하고, CUDA 호출과 kernel, 복사의 요약도 출력해줘요. Report를 Nsight Systems 화면에서 열면 위쪽에는 CPU 관점의 호출이, 아래쪽에는 GPU 관점의 복사와 kernel이 나와요.17
직렬 코드의 H2D copy, kernel, D2H copy는 한 줄로 이어져 보여요. 여러 stream을 썼다면 stream별 행에서 한 chunk의 kernel과 다른 chunk의 copy가 같은 시간 구간에 있는지 살펴보세요. 실제로 겹쳐 실행된 부분을 그렇게 확인하는 거예요.
같은 데이터는 H2D copy → kernel → D2H copy 순서를 지켜야 했죠. 이 순서는 같은 stream에 맡기고, 독립적인 chunk를 다른 stream에 나눠 넣었어요. 데이터의 의존 관계는 유지하면서 다른 chunk의 일을 끼워 넣을 수 있게 한 거예요.
실제로 얼마나 겹칠지는 copy engine의 지원 방식과 SM의 빈 실행 자리에 달려 있어요. 시간축까지 확인하고 나면 어디에서 기다리는지도 보이겠죠.
Async라고 적는 건 금방인데 같이 일하게 하려니 챙길 게 많았네요ㅎㅎ 필요한 코드와 참고 자료는 아래에 남겨둘게요~
참고
- OLCF CUDA Training Series: CUDA Concurrency
- CUDA Concurrency slides
- OLCF CUDA Training Series: HW7
- CUDA Programming Guide: Asynchronous Execution
- CUDA C++ Best Practices Guide: Asynchronous and Overlapping Transfers with Computation
- CUDA Runtime API: API Synchronization Behavior
- Nsight Systems User Guide
스티커: LINE의 Moon 캐릭터. Moon & James, LINE Characters in Love!.
CUDA는 NVIDIA GPU에서 일반 계산을 실행하도록 제공하는 프로그래밍 플랫폼이에요. CPU(Central Processing Unit)는 프로그램의 흐름과 범용 작업을 처리하고, GPU(Graphics Processing Unit)는 많은 데이터에 비슷한 계산을 병렬로 수행하도록 구성된 장치예요. 이 글은 CPU와 GPU의 물리 메모리가 분리된 시스템에서 시작해요. ↩︎
float는 소수 부분이 있는 수를 표현하는 부동소수점 타입이고, 이 CUDA C++ 예제에서는 원소 하나가 4 byte를 차지해요. Byte는 8개의 이진 숫자(bit)를 묶은 메모리 크기 단위예요.sizeof(float)는 타입이 차지하는 byte 수를 구하니, 원소 개수와 곱하면 복사할 전체 크기가 나와요. ↩︎비동기(asynchronous)는 CPU가 요청한 복사의 완료를 기다리지 않고 다른 일을 진행할 수 있다는 뜻이에요.
Async라는 이름만으로 항상 즉시 돌아오는 것은 아니며, 일반 pageable memory를 넘기면 임시로 RAM에 고정된 복사 공간을 준비하면서 CPU가 기다릴 수 있어요. 뒤에서는 pinned memory를 사용해 CPU 실행과 복사를 겹칠 조건을 갖출 거예요. (CUDA API 동기화 동작) ↩︎CUDA runtime은 프로그램에서 메모리를 할당하거나 GPU 실행을 요청하도록 도와주는 실행 지원 라이브러리예요. 라이브러리는 미리 구현한 기능의 묶음이고, 프로그램이 그 기능을 호출하는 방법이 API(Application Programming Interface)예요. Runtime은 이런 요청을 driver에 연결해주며, driver가 장치와 운영체제 쪽 제어를 맡아요. ↩︎
L2는 Level 2, 즉 두 번째 단계 캐시라는 이름이에요. 이 글의 GPU에서는 여러 계산 장치가 함께 사용하는 데이터 캐시이며, 가까운 곳에 최근 데이터 사본을 두어 매번 GPU 전용 메모리까지 가지 않게 해줘요. GPU memory 자체를 새로 할당한 영역과는 구분해요. ↩︎
측정 장비는 NVIDIA A100-SXM4-80GB예요. 환경은 RunPod 컨테이너, CUDA 12.4, driver 580.159.04였고
nvcc -O3 -arch=sm_80으로 빌드했어요.N은 16,777,216개(64MB), chunk는 16개, stream은 4개이고 이 GPU의asyncEngineCount는 3이에요.cudaEvent로 warm-up 5회 뒤 30회를 측정해서 median을 썼어요. 직렬은 5.230 ms(min 5.204, max 7.976), stream은 3.384 ms(min 3.340, max 3.681)였어요. 측정 코드는 overlap_bench.cu에 있어요. ↩︎RunPod는 여기서 사용한 원격 GPU 실행 서비스이고, 컨테이너는 실행에 필요한 소프트웨어를 모아 격리한 환경이에요.
nvcc는 CUDA 컴파일러,-O3는 최적화 수준,-arch=sm_80은 compute capability 8.0 GPU용 코드를 만들라는 설정이며, compute capability는 GPU가 지원하는 CUDA 하드웨어 기능 세대예요.asyncEngineCount는 장치가 보고한 비동기 복사 엔진 수로, 그 값만큼 모든 복사가 반드시 동시에 실행된다는 뜻은 아니에요. (CUDA 장치 속성) ↩︎Warm-up은 본 측정 전에 같은 작업을 몇 번 실행해 초기 준비의 영향을 줄이는 예열이에요. Median은 측정값을 크기순으로 놓았을 때 가운데 값으로, 개수가 짝수면 가운데 두 값의 평균을 쓰며 min과 max는 최솟값과 최댓값이에요.
ms는 1초의 1,000분의 1이고, 여기서 CUDA event는 GPU 작업 순서 안에 시점을 표시해 두 표시 사이의 시간을 재는 데 쓰여요. ↩︎chunkElements는 chunk 하나에 넣을 원소 개수예요. 코드에서는1 << 20, 즉 1,048,576개로 두었어요.N이 16,777,216개이니 chunk는 16개예요. 값을 크게 잡으면 chunk 수가 줄어 작업을 겹칠 기회도 적어져요. 작게 잡을수록 chunk 하나를 처리할 때 kernel launch와 copy 요청이 차지하는 비중이 커지고요. ↩︎반복문이 끝나도 CPU가 작업 제출을 마쳤을 뿐, GPU는 아직 실행 중이에요. 여기서 기다리지 않고 바로
cudaFreeHost와cudaFree로 넘어가면 GPU가 복사하거나 읽는 중인 memory를 해제하게 돼요.h_y의 결과를 읽는 코드도 같은 이유로 이 대기 뒤에 둬야 해요.cudaMemcpy를 쓰는 동기 버전에서는 그 함수가 끝날 때 복사도 끝나 있어서 이 줄이 필요 없어요. ↩︎반대로 같은 종류의 작업을 chunk 전체에 걸쳐 먼저 제출하는 순서는 breadth-first라고 해요. 아래처럼 나란히 놓고 보면 제출하는 순서가 보여요.
// depth-first
for (chunk 0..15) {
    H2D;  kernel;  D2H;
}
// breadth-first for (chunk 0..15) { H2D; } for (chunk 0..15) { kernel; } for (chunk 0..15) { D2H; }두 방식 모두 각 stream 안에서는 H → K → D 순서로 실행된다는 점은 같아요. ↩︎
Legacy는 이전부터 쓰이던 기본 동작을 뜻하며, 여기서는 같은 GPU에서
cudaStreamCreate로 만든 stream들과 자동으로 기다리는 관계를 만드는 default stream이에요.cudaStreamNonBlocking옵션으로 만든 stream은 이 자동 대기의 예외이고, 그 이름이 모든 CPU 호출의 즉시 반환을 보장하는 것은 아니에요. Per-thread 모드는 CPU thread마다 별도의 default stream을 두는 설정으로, 뒤의 예제에서 따로 볼게요. (CUDA stream 동기화 규칙) ↩︎CPU thread는 CPU 쪽 프로그램 안에서 코드를 순서대로 실행하는 흐름 하나예요. 같은 프로그램에 이런 흐름이 여러 개 있을 수 있어요. 앞에서 kernel의 원소 계산을 맡았던 GPU thread와 실행하는 곳이 다르답니다. ↩︎
Priority는 실행 대기 중인 kernel 작업을 선택할 때 참고하는 우선순위예요. 선택을 담당하는 동작을 scheduling이라고 하며, 이 우선순위는 이미 실행 중인 작업을 중단시키거나 특정 실행 순서를 보장하는 강제 규칙은 아니에요. 일반적으로 kernel 실행에 적용하는 힌트라서 복사에도 같은 우선순위가 적용된다고 가정하면 안 돼요. (CUDA stream 우선순위) ↩︎
NVLink는 NVIDIA가 제공하는 처리 장치 간 데이터 연결 기술이에요. 여기서는 GPU끼리 메모리 데이터를 주고받는 통로이며, 지원 장치와 실제 연결 구성이 맞아야 사용할 수 있어요. GPU가 여러 개 꽂혀 있다는 것만으로 NVLink 연결이나 peer access가 생기는 건 아니에요. ↩︎
이 예제는
cudaMemPrefetchAsync를 지원하는 Unified Memory 환경을 전제로 해요. CUDA 12.x의 이 호출은 관련 GPU의concurrentManagedAccess가 1이어야 하며, 이 속성은 CPU와 GPU가 managed memory에 함께 접근할 수 있는 지원 수준을 뜻해요. 앞 글에서 본 Orin의concurrentManagedAccess=0환경에 이 코드를 그대로 적용하면 안 돼요. (CUDA 12.4 메모리 API) ↩︎화면의 CUDA API 행은 CPU가 CUDA 함수를 호출한 구간이고, GPU의 kernel·memory 행은 GPU에서 실제 계산·복사가 실행된 구간이에요.
HtoD와DtoH는 각각 앞서 본 H2D와 D2H이며, Stream ID는 작업이 속한 stream을 구분하는 번호예요. CPU 호출 막대의 길이와 GPU 작업 시간을 같은 것으로 읽지 않도록 행 이름도 같이 봐주세요. (Nsight Systems 안내) ↩︎