Source: 01 CUDA C Basics
CUDA 스택
안녕하세요ㅎㅎ 오늘은 CUDA C 코드에서 CPU가 하는 일과 GPU가 하는 일1을 따라가보려고 해요.
CUDA(Compute Unified Device Architecture)는 NVIDIA GPU로 계산하기 위한 기술 전체를 가리켜요. 그 출발점은 GPU의 작업을 실행 단위인 thread에 어떻게 나누고 실행할지 정하는 programming model, 즉 작업의 구성과 실행 규칙이에요.
프로그램이 GPU에 작업을 요청할 때 부르는 API(Application Programming Interface)도 있고, 소스 코드를 GPU 명령으로 바꿔주는 compiler도 있어요. 자주 쓰는 연산을 미리 구현해둔 library까지 함께 쓰게 되고요.
API는 프로그램에서 어떤 함수를 어떻게 호출할지 정한 규칙이에요. Compiler는 사람이 쓴 코드를 hardware가 실행할 코드로 번역해주는 프로그램이고, library는 자주 쓸 기능을 미리 구현해둔 코드랍니다. 이름은 여러 개여도 맡은 일은 이렇게 구분할 수 있어요.
운영체제와 GPU 사이에서 명령을 전달하고 hardware 자원을 관리하는 software는 GPU driver예요. 이 driver를 직접 다루는 낮은 수준의 함수들이 CUDA Driver API이고요. 그 위의 CUDA Runtime API2에서는 cudaMalloc과 cudaMemcpy3처럼 CUDA C++에서 바로 쓸 수 있는 함수를 제공해요.
Library 이름도 잠깐 볼게요. 숫자를 행과 열로 배치한 matrix(행렬)와 한 줄로 나열한 vector(벡터) 연산에는 cuBLAS, deep neural network4 연산에는 cuDNN이 있어요. CUDA는 2007년에 공개된 뒤로 GPU를 그래픽 이외의 계산에 쓰는 기반이 됐고, 지금은 딥러닝 software에서 GPU를 사용하는 표준 경로로 자리 잡았답니다.
이 가운데 C++로 GPU 코드를 작성하는 방법이 CUDA C++예요. PyTorch5가 내부에서 CUDA library를 불러 쓰는 경우도 있고, 개발자가 GPU에서 실행할 함수인 kernel을 __global__ 표시를 붙여 직접 쓰는 경우도 있죠. 기능을 단계별로 나눈 층을 layer라고 하는데, 이 둘은 사용하는 layer가 달라요.
어느 쪽이든 CUDA 위에서 동작해요. 그래서 CUDA를 설명할 때는 여러 layer가 쌓인 stack 그림이 나오는 거예요. 코드 한 줄 쓰러 왔는데 아래에 꽤 많은 것이 받쳐주고 있네요ㅎㅎ
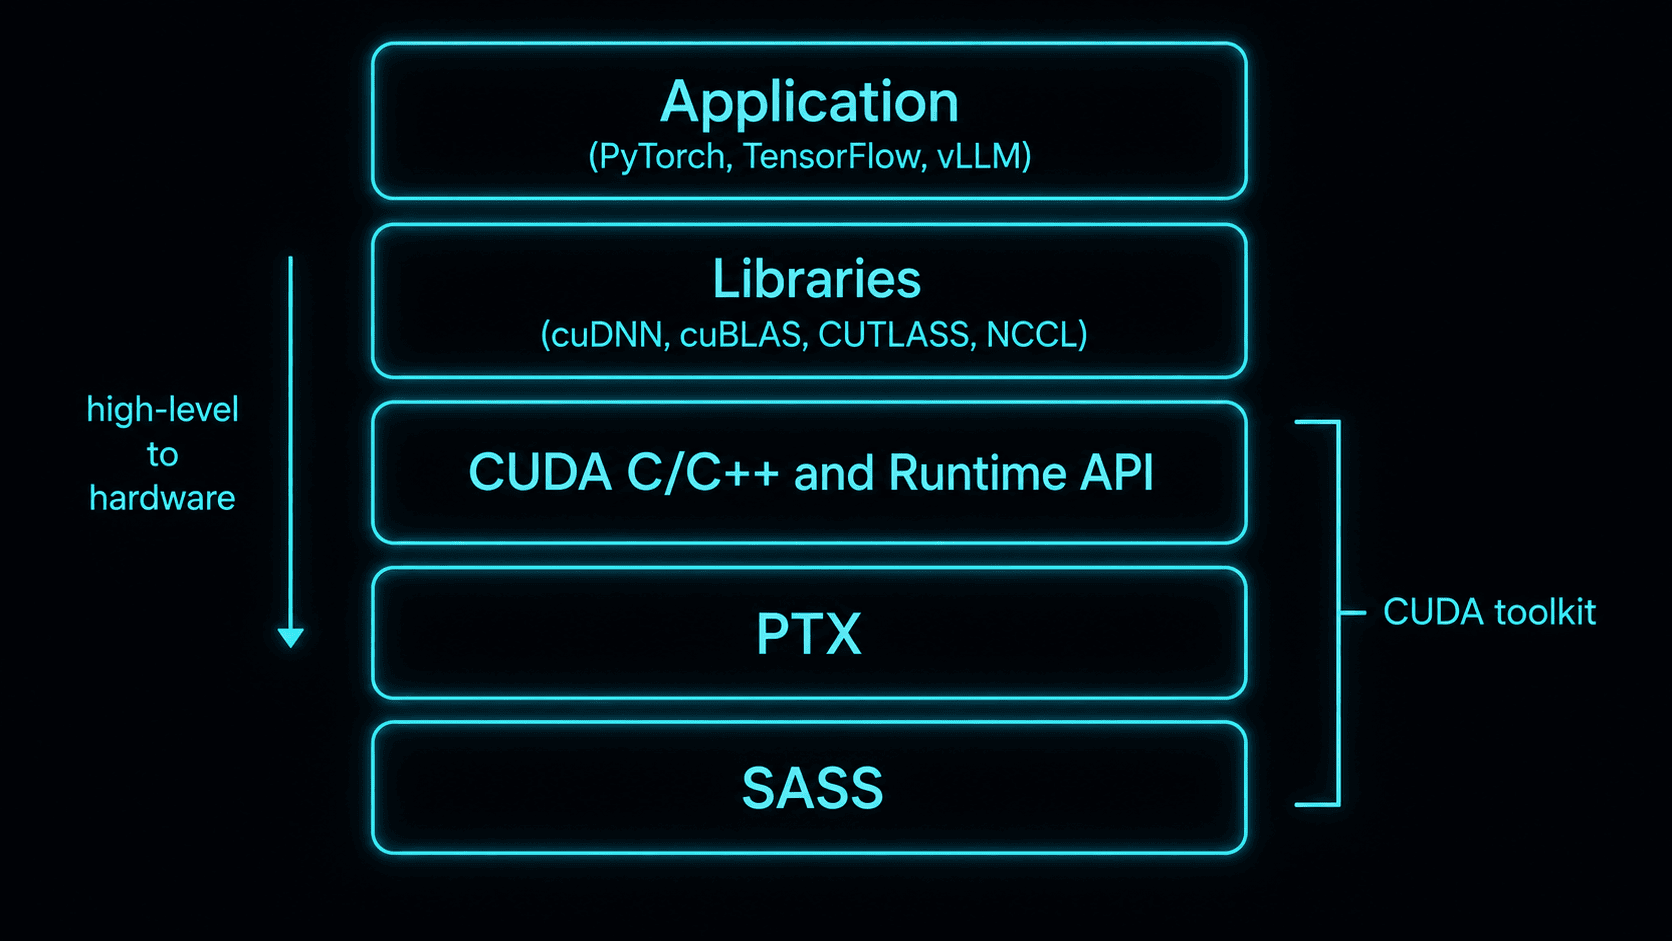
위 그림에서 CUDA C++ 코드가 PTX(Parallel Thread Execution)를 거쳐 SASS로 바뀌는 부분을 봐주세요. PTX는 여러 NVIDIA GPU 세대에서 공통으로 받아들이는 중간 명령어예요. SASS까지 가면 특정 GPU가 실제로 실행하는 명령어가 되고요. 여기서부터 CPU 쪽 코드와 메모리는 host, GPU 쪽은 device라고 부를게요. Kernel을 실행하도록 요청하는 동작은 kernel launch예요.
| 레이어 | 역할 |
|---|---|
| CUDA C/C++ | 개발자가 GPU 작업을 작성하는 C++ 확장. 실행 단위인 thread, thread 묶음인 block, 모든 block을 묶은 grid가 여기에 속한다. |
| CUDA Runtime API | cudaMalloc, cudaMemcpy, kernel launch처럼 host 코드가 CUDA에 요청할 때 쓰는 함수와 문법 |
nvcc | CUDA C++를 host 코드와 device 코드로 나누어 컴파일하는 프로그램 |
| PTX | 실제 GPU가 아니라 가상의 NVIDIA GPU를 대상으로 한 중간 명령어 |
| SASS | 특정 GPU 세대가 직접 실행하는 최종 명령어 |
GPGPU
GPGPU(General-Purpose computing on GPU)는 GPU를 그래픽 밖의 범용 연산에 쓴다는 뜻이에요. 딥러닝이 널리 쓰이기 전에는 주로 폴리곤6을 그리는 그래픽 장치로 만났지만, 지금은 대규모 병렬 수치 연산을 GPU에 맡기는 일이 많아졌죠.
컴퓨터가 처리할 작업의 종류와 양을 workload라고 해요. 영상 편집기인 VEGAS Pro나 NVIDIA 제어판에서 CUDA - GPUs 같은 option을 보셨다면, 영상 편집이나 데이터에서 규칙을 학습하는 machine learning 같은 GPGPU workload를 어느 GPU에서 실행할지 고르는 설정이에요.
GPU에 맡기기 좋은 작업을 보면 공통점이 있어요. 같은 연산을 많은 data에 독립적으로 반복한다는 거예요.
GPU는 명령 하나를 여러 thread가 각자의 data에 적용하는 SIMT(Single Instruction, Multiple Threads) 방식으로 실행해요. Thread는 같은 코드를 서로 다른 data에 적용하는 실행 단위라고 보시면 돼요. 아래 작업들이 그 방식과 잘 맞는답니다.
| 워크로드 | 본질 |
|---|---|
| 영상 인코딩/필터 | 픽셀 행렬7에 대한 병렬 수치 연산 |
| 딥러닝 학습/추론8 | 여러 차원의 숫자 배열인 tensor의 행렬곱(matrix multiplication, MatMul) |
| 암호화폐 채굴 | 입력을 고정된 길이의 값으로 바꾸는 hash 계산의 반복 |
| 과학 시뮬레이션 | 공간 격자 또는 particle9의 상태를 반복해서 갱신 |
| 3D 렌더링 (Blender Cycles 등) | 빛의 진행 경로를 나타내는 ray별 계산 |
참, 이런 계산을 CUDA가 나온 뒤에야 시작한 건 아니에요. 한국 연구진의 2004년 논문(Oh & Jung, “GPU implementation of neural networks”, Pattern Recognition)에도 GPU로 인공신경망을 학습한 초기 사례가 있어요.
당시에는 범용 GPU API가 없었어요. 그래서 그래픽 효과를 계산하는 프로그램인 shader로 신경망 연산을 표현했답니다. 계산하고 싶은 건 따로 있는데 그래픽 작업의 형태를 빌려야 했던 거죠.
이기종 컴퓨팅
이기종 컴퓨팅(Heterogeneous Computing)은 구조가 다른 CPU와 GPU가 한 프로그램의 일을 나눠 실행하는 방식이에요. CUDA에서는 CPU와 CPU memory를 host, GPU와 GPU memory를 device라고 불러요. 앞으로 이 두 이름이 자주 나올 거예요~
조건을 판단하고 실행 순서를 관리하는 일은 host가 맡아요. 행렬곱처럼 같은 계산을 많이 반복하는 부분은 device로 보내고요. CPU가 하던 계산을 GPU에 넘기는 일을 offload라고 한답니다.
CPU는 적은 수의 강한 core10를 두고, 자주 쓰는 data를 cache11에 가까이 보관해요. Branch prediction으로 조건문 뒤에 어느 경로를 갈지도 미리 추측하죠. 작업 하나를 끝낼 때까지 걸리는 시간인 latency를 줄이기에 유리한 구성이에요.
GPU에는 연산 장치가 훨씬 많이 있어요. 일정 시간에 처리하는 작업량, throughput을 높이는 데 맞춘 구조죠. 그래서 분기가 많고 순차적인 코드는 CPU에, 같은 연산을 많은 data에 적용하는 코드는 GPU에 배치해요. 각자 잘하는 일을 나눠 맡기는 셈이에요.
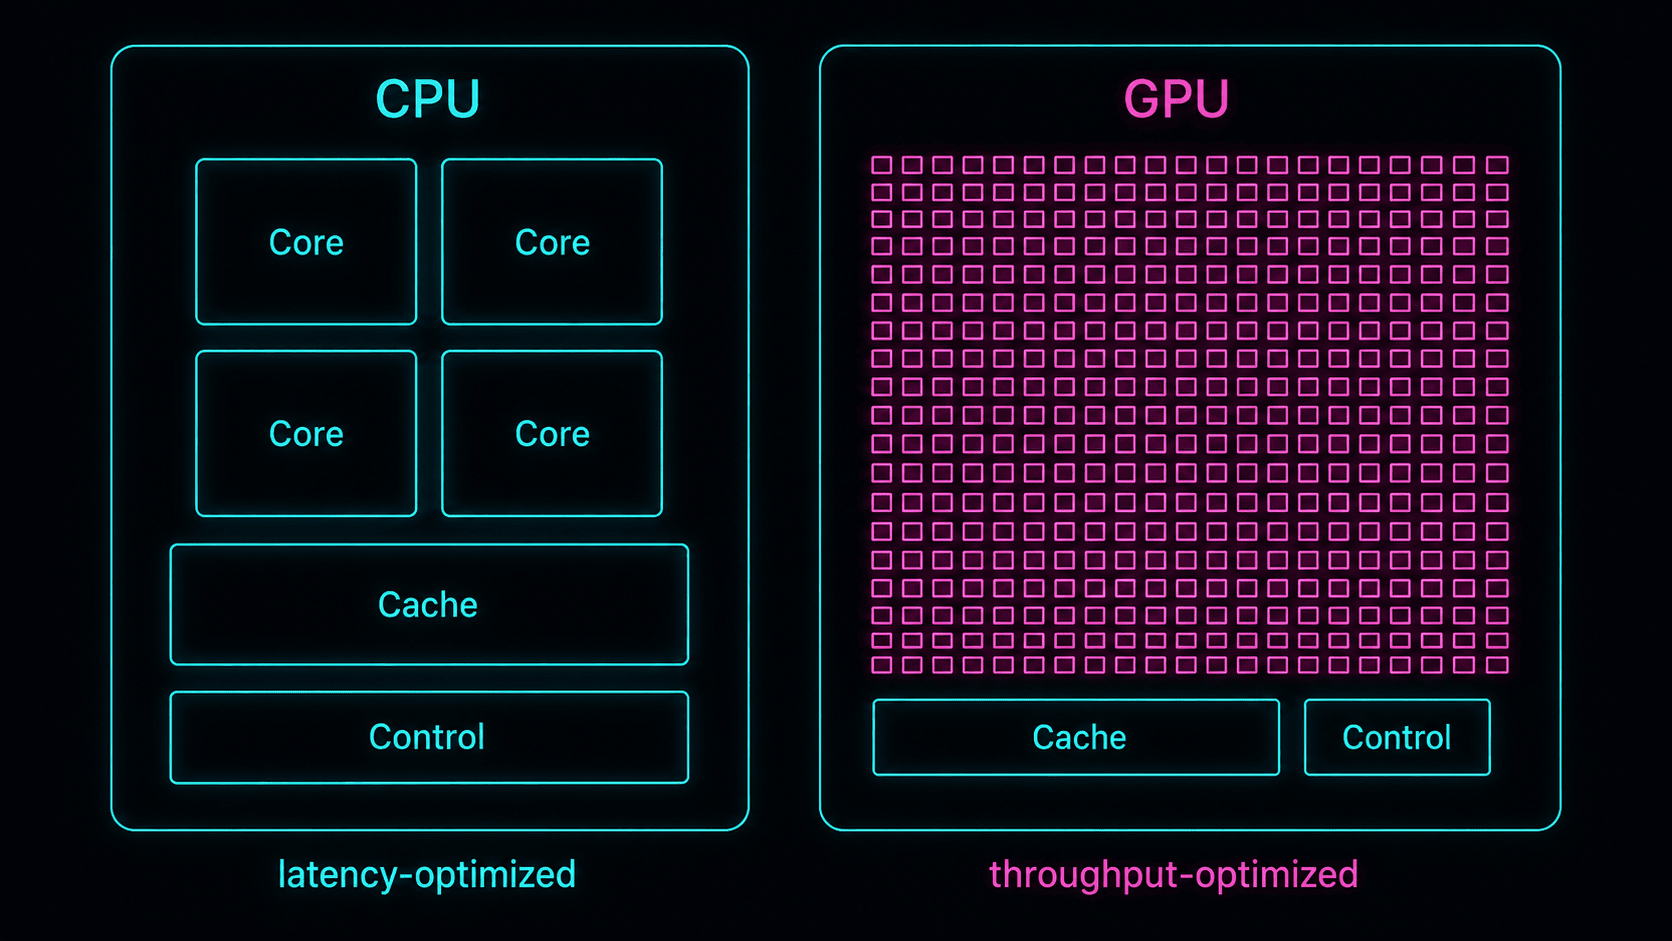
코드에서 이 역할을 나누려면 memory도 신경 써야 해요. CPU가 준비한 입력을 GPU가 계산하려면 우선 두 장치 사이에서 data를 옮겨줘야 하거든요.
Host-Device 데이터 흐름
프로그램이 쓸 memory 영역을 확보하는 일을 memory allocation이라고 해요. Pointer는 그 영역의 주소를 담는 변수이고요. Host memory와 device memory를 각각 allocation하고, 두 공간 사이의 복사도 개발자가 직접 요청하는 방법이 명시적 복사(explicit-copy)예요.
CPU에서 allocation한 일반 pointer가 device memory를 가리키는 건 아니에요. Kernel에 그대로 넘겨서 쓰면 되는 줄 알기 쉬운데, 먼저 입력을 device memory로 옮겨줘야 해요. 거기서 kernel을 실행한 뒤 결과를 host memory로 다시 가져오는 순서랍니다.
하나의 pointer로 CPU와 GPU가 함께 쓸 영역을 만드는 cudaMallocManaged와 Unified Memory도 있어요. CPU와 GPU가 같은 RAM12을 쓰는 integrated GPU는 memory 배치도 다르고요.
여기서는 별도 GPU를 쓸 때 기본이 되는 명시적 복사부터 따라가볼게요. 입력을 보내고, 계산하고, 결과를 받아오는 흐름이에요.
- Host → Device (
cudaMemcpy)
cudaMemcpy(d_data, h_data, size, cudaMemcpyHostToDevice);
cudaMemcpy(destination, source, size, direction)은 source에서 size bytes13를 읽어 destination으로 복사해요. 위 코드에서는 h_data가 host pointer, d_data가 device pointer예요. 마지막의 cudaMemcpyHostToDevice가 H2D(Host to Device), 즉 CPU에서 GPU로 보내는 방향을 정해준답니다.
이 data는 host와 device를 연결하는 통로인 interconnect를 지나가요. 별도 그래픽 카드라면 주로 PCIe(PCI Express)를 쓰는데요. 주변 장치를 CPU system에 연결하는 표준 bus예요.
NVIDIA의 고속 interconnect인 NVLink도 있어요. GPU끼리 연결하거나 GH200처럼 CPU와 GPU를 직접 연결하는 구성에서 사용해요. 어떤 장치를 어떤 통로로 연결했는지 나타내는 구성을 topology라고 부르니, 연결 속도를 비교할 때는 이 구성도 함께 봐주세요.
- Execute Kernel (
<<<...>>>)
kernel<<<gridDim, blockDim>>>(d_data);
Kernel은 GPU에서 실행되는 함수예요. <<<gridDim, blockDim>>>에는 실행할 block 수와 block마다 둘 thread 수를 넣어요. Block과 thread가 실제로 배열 원소를 어떻게 나눠 맡는지는 아래에서 이어서 볼게요.
- Device → Host (
cudaMemcpy)
cudaMemcpy(h_result, d_result, size, cudaMemcpyDeviceToHost);
이번에는 host pointer h_result가 destination, device pointer d_result가 source예요. 방향도 cudaMemcpyDeviceToHost로 바뀌었죠? D2H(Device to Host), 즉 GPU에서 CPU로 보내는 복사를 요청해서 계산이 끝난 결과를 CPU memory로 가져와요.
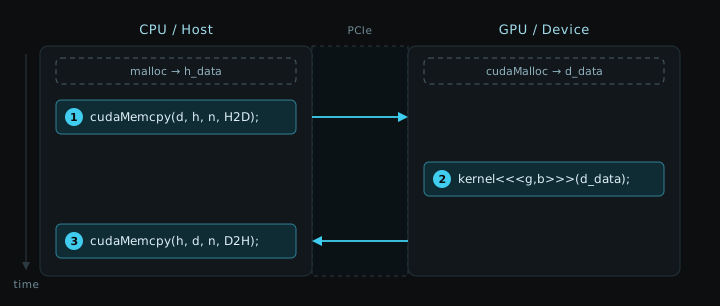
이 왕복 복사가 왜 비싼지는 bandwidth를 비교해보면 드러나요. Bandwidth는 1초에 옮길 수 있는 데이터의 양이에요. 별도 GPU가 host와 통신할 때 주로 쓰는 PCIe Gen4 x1614은 방향당 이론 bandwidth가 약 32 GB/s, Gen5 x16은 약 64 GB/s예요.
NVLink가 PCIe보다 빠르다고 해서 모든 host-device 복사에 그 속도를 쓸 수 있는 건 아니에요. H100의 NVLink 900 GB/s는 양방향을 합친 값이에요. NVLink로 직접 연결하거나, 여러 NVLink 장치를 이어주는 switch인 NVSwitch로 연결한 GPU 사이에 적용되는 수치랍니다.
GH200은 CPU와 GPU를 하나의 hardware 묶음인 package 안에서 NVLink-C2C15로 연결한 구성이에요. 일반적인 별도 GPU와 system RAM 사이의 cudaMemcpy는 PCIe를 사용하니 구분해두셔야 해요.
GPU 내부의 HBM(High Bandwidth Memory)16도 볼까요? A100 SXM은 약 2.0 TB/s, H100 SXM은 약 3.35 TB/s예요. SXM은 GPU와 HBM을 board에 장착하는 data center용 module 형태를 말해요.
이렇게 보면 GPU 내부 memory의 bandwidth는 PCIe host link보다 약 30배에서 100배 높아요. 같은 data를 host와 device 사이에서 자꾸 왕복시키면, GPU 계산이 빨라도 전체 시간은 복사에 묶일 수밖에 없겠죠.
계산은 얼른 끝났는데 오는 길 가는 길에 시간을 다 쓰네요..ㅠㅠ

그래서 CUDA 최적화에서는 복사 횟수와 양부터 줄여보는 게 중요해요. Host memory의 종류도 영향을 주는데요. 보통 malloc17으로 만든 영역은 운영체제가 필요할 때 RAM 밖으로 옮길 수 있는 pageable memory예요. Pinned memory는 GPU 전송 중 RAM의 같은 위치에 머물도록 고정한 host memory이고요.
Pinned host memory를 만들 때는 cudaHostAlloc, 해제할 때는 cudaFreeHost를 써요. Device memory를 만드는 함수는 여전히 cudaMalloc이에요. CPU가 복사 완료를 기다리지 않고 다음 일을 진행할 수 있는 방식을 비동기 복사라고 해요. 이 host-device 복사를 GPU 계산과 겹쳐 실행하려면 pinned memory가 필요하답니다. Pageable memory와 page fault18, 물리 RAM 한도와 비동기 복사의 조건은 05 CUDA Concurrency의 Pinned Memory에서 더 살펴볼게요.
연속된 여러 kernel을 하나로 합치는 kernel fusion도 있어요. 여기서 global memory는 cudaMalloc으로 만든 배열이 놓이는 device의 큰 DRAM19 영역이에요.
Kernel을 합치면 사이사이의 중간값을 global memory에 쓰고 다시 읽는 횟수를 줄일 수 있어요. Kernel을 시작할 때 드는 launch overhead도 줄고요. 중간 결과를 매번 host로 가져오던 프로그램이라면 host-device 왕복까지 덜 하게 돼요.
전송과 연산을 같은 시간대에 배치하는 방법은 05 CUDA Concurrency에서 이어갈게요. Fusion은 이후 최적화 글에서 다루고, 여기서는 kernel 하나를 어떻게 작성하고 실행하는지부터 볼게요.
CUDA C 기본 문법과 커널(Kernel)
CUDA C 문법은 vector addition을 보면서 익혀볼게요. 두 배열에서 같은 위치의 값을 더해 세 번째 배열을 만드는 계산이에요. c[i] = a[i] + b[i]를 보면 각 index20의 계산에 다른 index의 결과가 필요하지 않죠.
이렇게 작업 사이의 의존 관계가 없어서 바로 나눠 실행할 수 있는 문제를 embarrassingly parallel이라고 해요. Thread 하나에 원소 하나씩 맡기면, 서로의 결과를 기다리지 않고 독립적으로 계산할 수 있답니다.
GPU에서 함수를 실행하려면 실행되는 곳과 호출하는 곳을 표시해줘야 해요. CUDA C에서는 함수 앞에 붙이는 qualifier로 구분해요. 함수의 성질을 compiler에 알려주는 표시라고 보시면 돼요.
| 한정자 | 실행 위치 | 호출 위치 | 특징 |
|---|---|---|---|
__global__ | Device (GPU) | Host (CPU) | GPU에서 실행되는 kernel. 반환형은 void21이며 결과는 device memory에 기록 |
__device__ | Device (GPU) | Device (GPU) | kernel이나 다른 device 함수가 GPU 내부에서 호출하는 보조 함수 |
__host__ | Host (CPU) | Host (CPU) | 일반 C/C++ 함수 (기본값, 생략 가능). 한정자 없는 함수는 전부 __host__ |
__global__ kernel은 CUDA C++ 문법상 반환형이 void예요. 계산한 결과는 device memory에 써두는 방식으로 전달한답니다.
Host가 kernel을 launch하는 호출은 비동기예요. CPU가 kernel<<<...>>>()를 요청하면 kernel이 끝나기를 기다리지 않고 다음 줄로 넘어가요. 이렇게 호출한 쪽이 작업 완료를 기다리지 않는다는 뜻이에요. 요청했다고 결과까지 바로 준비된 건 아니겠죠?ㅎㅎ
CPU가 결과를 쓸 때는 D2H cudaMemcpy로 가져오거나, 앞선 device 작업이 모두 끝날 때까지 CPU를 기다리게 하는 cudaDeviceSynchronize를 호출해요.
한 source file에서 host 코드와 device 코드를 같이 쓸 수 있지만, compile할 때는 두 코드가 다시 나뉘어요. 그 과정을 잠깐 따라가볼게요.
nvcc 컴파일 파이프라인
.cu 파일 하나에는 CPU에서 실행할 host 코드와 GPU에서 실행할 device 코드가 함께 들어가요. NVIDIA의 CUDA compiler인 nvcc가 둘을 구분해서 처리해준답니다.
Host 코드는 GCC나 MSVC 같은 system C++ compiler에 넘겨요. Device 코드는 NVIDIA의 device code compiler인 cicc가 PTX로 바꾸고요. 이 단계의 PTX는 특정 GPU 하나에 묶이지 않은 중간 명령어예요.
다음에는 ptxas라는 assembler가 PTX를 특정 GPU architecture22의 SASS로 바꿔요. Assembler는 중간 명령어를 machine code로 바꾸는 프로그램이에요. SASS가 되면 GPU가 직접 실행하는 최종 machine code가 나온 거예요.
완성된 실행 파일에는 GPU 코드를 모아둔 fatbin이 들어가요. 보통 몇 가지 GPU architecture용 SASS와 PTX를 함께 넣어둔답니다.
CUDA가 GPU의 기능 세대를 구분하는 version은 compute capability라고 해요. sm_80, sm_86, sm_90 같은 번호로 나타내고, 앞 숫자가 major version이에요.
sm_80, sm_86, sm_89는 major version 8의 SASS 호환 범위를 공유해요. 하지만 sm_90처럼 major version이 달라지면 기존 SASS를 그대로 실행할 수 없어요.
이때 실행 파일에 PTX도 들어 있다면 driver가 프로그램을 불러오면서 새 GPU용 SASS를 만들 수 있어요. 실행 직전에 필요한 코드를 만드는 JIT(Just-In-Time) compilation이에요.
-arch=native처럼 현재 GPU용 SASS만 넣고 PTX를 빼면 다음 major 세대에서는 다시 컴파일해야 해요. -gencode arch=...,code=... option으로 어떤 SASS를 넣을지, PTX도 포함할지 정해줄 수 있답니다.
지금 잘 돌아간다고 다음 GPU에서도 그대로 될 줄 알면.. 다시 손볼 일이 생기겠네요 ^^;;
앞에서 이야기한 add kernel을 nvcc -arch=sm_80 -ptx vector_add.cu로 변환하면 아래와 같은 PTX를 볼 수 있어요. %r, %f, %rd로 시작하는 이름들은 계산 중인 값을 잠깐 보관하는 PTX register23예요.
mad.lo.s32    %r1, %r3, %r4, %r5;  // thread index i
setp.ge.s32   %p1, %r1, %r2;       // i >= N ?
@%p1 bra      $L__BB0_2;           // 범위 밖이면 건너뜀
...
ld.global.f32 %f1, [%rd8];         // b[i]
ld.global.f32 %f2, [%rd6];         // a[i]
add.f32       %f3, %f2, %f1;       // a[i] + b[i]
st.global.f32 [%rd10], %f3;        // c[i] = ...
C에서는 c[i] = a[i] + b[i] 한 줄인데, GPU 명령으로는 여러 줄이 나오죠. 먼저 mad.lo.s32는 index 주소를 구하는 32-bit 정수 곱셈과 덧셈이에요. 실수 곱셈과 덧셈을 한 명령으로 처리하는 FMA(Fused Multiply-Add)와 이름이 비슷해 보여도, 여기의 mad.lo.s32는 FP32 FMA24가 아니에요.
이어서 setp와 bra가 i < N을 검사해서 범위를 벗어난 thread를 건너뛰어요. ld.global.f32 두 줄은 device의 global memory에서 a[i], b[i]를 읽고요. add.f32로 더한 다음 st.global.f32로 c[i]에 결과를 저장해요.
원소 하나를 처리하려면 4-byte 값 두 개를 읽고 하나를 쓰니, memory 이동은 12 bytes예요. 실제 실수 덧셈은 한 번이고요. 실수 연산 횟수를 세는 단위가 FLOP(Floating-Point Operation)이니 여기서는 1 FLOP이랍니다. 이 비율은 뒤에서 vector addition의 roofline 병목25을 볼 때 다시 써볼게요.
최종 SASS가 궁금하시면 CUDA binary26를 읽는 도구인 cuobjdump에 -sass option을 주시면 돼요.
명령어가 준비됐으니 이제 몇 개의 thread가 이 kernel을 실행할지 정해야겠죠? 그 수는 launch 구성에서 정해요.
Thread와 Block 한계
Kernel을 실행하면 같은 함수를 수행하는 thread가 여러 개 만들어져요. CUDA는 이 thread를 block으로 묶고, 한 번의 kernel launch에 들어가는 모든 block을 grid로 묶어요. 크기를 쓸 때의 dim3(x, y, z)는 block이나 grid를 1차원, 2차원, 3차원으로 표현하는 CUDA 자료형이에요.
- Block 하나에는 thread를 최대 1024개까지 둘 수 있어요.
dim3의 x, y, z를 곱한 값이 1024를 넘으면cudaErrorInvalidConfiguration오류로 kernel launch가 실패해요.dim3(32, 32, 1)은 1024개라 가능하지만,dim3(32, 32, 2)는 2048개라 불가능하답니다. z축 크기는 따로 64라는 상한도 있어요. - Grid의 상한은 block보다 훨씬 커요. x축에는 최대 2³¹-1개 block, y축과 z축에는 각각 65535개 block을 둘 수 있어요.
- 같은 block의 thread가 함께 쓰는 GPU 내부 memory가 shared memory예요. 크기를 compile할 때 정하는 static allocation의 기본 상한은 block당 48KB예요.
Dynamic allocation은 kernel<<<grid, block, sharedMemoryBytes>>>의 세 번째 값으로 크기를 정해요. 기본 상한보다 더 필요하면 cudaFuncSetAttribute(kernel, cudaFuncAttributeMaxDynamicSharedMemorySize, bytes)로 opt-in을 요청해주세요.
Opt-in은 프로그램에서 더 큰 dynamic shared memory 한도를 명시적으로 선택하는 방식이에요. 최대치는 A100에서 약 163KB, H100에서 약 227KB예요. Block을 실행하는 GPU processor인 SM 안에서 L1 cache27와 shared memory가 함께 쓰는 전체 용량을 나눠 쓰는 거예요.
이 상한은 GPU 하드웨어의 구조에서 나와요. 여기서 SM의 정식 이름은 Streaming Multiprocessor랍니다.
Block 하나가 SM 하나에 배치되면 완료될 때까지 다른 SM으로 옮겨가지 않아요. SM은 block 안의 thread를 32개씩 warp로 묶어 실행하니, thread 1024개면 warp 32개가 돼요.
Thread가 계산 중인 값을 보관하는 가장 가까운 memory는 register예요. SM이 가진 register 전체를 register file이라고 하고요. 최근 GPU의 SM 하나에는 보통 32-bit register가 65,536개 있어요.
많아 보여도 thread 하나가 register를 많이 쓰면 같은 SM에 동시에 올릴 수 있는 thread 수가 줄어요. 이렇게 한정된 SM 자원이 머무를 수 있는 thread와 warp 수를 정해요. 그 수가 최대치에서 차지하는 비율을 occupancy라고 한답니다.
Warp와 SIMT 실행
Warp는 thread 32개로 이루어진 실행 묶음이에요. 이 크기를 개발자가 바꿀 수는 없어요. 그 안에서 thread 하나가 차지하는 자리가 lane이라서, warp 하나에는 lane 0부터 lane 31까지 있어요.
어느 warp를 실행할지 고르는 hardware가 warp scheduler예요. Scheduler가 warp에 명령 하나를 보내는 일을 issue라고 해요. 그 명령을 실행할 lane은 active mask28로 표시하고요. 32개 lane 중 활성화된 lane들이 같은 명령을 각자의 데이터에 적용하는 방식이 SIMT랍니다.
같은 warp 안에서 if/else의 선택이 달라지면 warp divergence가 생겨요. Warp 하나가 두 경로의 명령을 동시에 issue할 수는 없으니, 한쪽 lane만 켜서 먼저 실행하고 다른 쪽 lane을 이어서 실행해요. 분기 때문에 두 경로를 차례로 처리하게 되는 거죠.
Volta부터는 independent thread scheduling29이 도입됐어요. 다음에 실행할 명령의 위치를 program counter라고 하는데, Volta 이후에는 이 값을 thread마다 따로 가져요.
갈라졌던 thread가 다시 합쳐지는 지점을 post-dominator30라고 해요. 다만 여기에 도착했다고 모든 lane이 곧바로 같은 명령으로 돌아왔다고 가정하면 안 돼요. __syncwarp()로 참여하는 warp thread가 모두 도착할 때까지 기다려서 실행 시점을 다시 맞춰줘요.
Block의 thread 수가 32의 배수가 아니어도 마지막 warp는 만들어져요. Block당 thread를 100개 두면 warp가 4개 필요하니 lane은 128개를 잡게 돼요. 실제로 일하는 건 100개이고 나머지 28개는 비활성 상태라, lane 활용률은 $100/128 \approx 78\%$예요.
딱 100명만 필요했는데 자리 계산은 따로 해야 하네요..ㅎㅎ
그래서 block 크기는 보통 128, 256, 512 가운데 골라요. 이 선택은 occupancy에도 영향을 줘요. SM의 active warp 수를 그 SM이 허용하는 최대 warp 수로 나눈 비율인데, 여기서는 SM에 올라와 실행에 참여하는 warp를 세는 거예요.
최대 warp 수는 A100과 H100에서 64개, 소비자용 Ampere와 Ada에서 48개예요. Thread 자리, block 자리, register, shared memory 중 하나라도 먼저 부족해지면 active warp 수도 그 한도에 걸려요.
GPU clock이 한 번 진행되는 시간 단위를 cycle이라고 해요. Global memory에서 값을 읽는 global load는 대략 400회에서 800회 cycle을 기다릴 수 있어요. Floating-point, 즉 실수 연산인 FP 연산은 대략 4회에서 6회 cycle이면 끝나고요. 계산과 memory 대기의 차이가 꽤 크죠.
Occupancy가 필요한 이유도 이 memory latency에 있어요. 한 warp가 global load를 기다리는 동안 scheduler가 실행 준비를 마친 다른 warp를 고를 수 있거든요.
이때 CPU의 thread 전환처럼 register를 저장했다가 복원하는 과정은 없어요. SM에 배치된 warp의 register는 register file에 계속 남아 있으니까요.
준비된 warp가 많으면 한쪽이 memory를 기다릴 때 다른 작업으로 채울 가능성도 커져요. Occupancy는 이렇게 memory 대기를 가릴 여유가 얼마나 있는지 보여주는 값이에요.
SM에 배치된 뒤 아직 실행을 마치지 않은 block은 resident block이라고 불러요. 몇 개가 들어갈 수 있는지는 thread 자리, hardware block 자리, register, shared memory가 각각 허용하는 block 수를 구해서 가장 작은 값으로 정해요.
아래 식에 쓸 기호를 먼저 모아둘게요. floor 기호 $\lfloor x\rfloor$는 내림, ceil 기호 $\lceil x\rceil$는 올림이에요. Block이 통째로 들어갈 자리를 세는 계산이라 둘을 구분해서 봐주세요.
| 기호 | 의미 |
|---|---|
| $B_{\text{res}}$ | SM 하나에 resident 상태로 들어가는 block 수 |
| $T_{\text{SM}}$ | SM 하나가 수용하는 최대 thread 수 |
| $T_{\text{block}}$ | block 하나의 thread 수 |
| $B_{\text{SM}}^{\max}$ | SM 하나가 수용하는 최대 block 수 |
| $R_{\text{SM}}$ | SM 하나의 전체 register 수 |
| $R_{\text{thread}}$ | thread 하나가 사용하는 register 수 |
| $S_{\text{SM}}$ | SM 하나가 제공하는 shared memory 크기 |
| $S_{\text{block}}$ | block 하나가 사용하는 shared memory 크기 |
| $W_{\text{SM}}^{\max}$ | SM 하나가 수용하는 최대 warp 수 |
| $B_{\text{shared}}$ | shared memory 용량이 허용하는 block 수 |
| $B_{\text{warp}}$ | warp 자리 수가 허용하는 block 수 |
한도는 compute capability마다 달라요. A100의 cc 8.0을 예로 들면 $T_{\text{SM}}=2048$, $B_{\text{SM}}^{\max}=32$, $R_{\text{SM}}=65536$, $W_{\text{SM}}^{\max}=64$예요.
$T_{\text{block}}=256$으로 두면 thread 자리에는 $\lfloor 2048/256 \rfloor=8$개 block이 들어가요. Register도 8개 block을 받아주려면 $8\cdot256\cdot R_{\text{thread}}\le65536$이어야 하니, thread당 register는 32개 이하여야 해요.
다만 이 식은 각 자원 한도를 연결한 1차 계산이에요. 실제 GPU는 register를 warp마다 정해진 묶음 크기로 할당하거든요. 이 크기가 allocation granularity예요. 그래서 resident block 수가 바뀌는 경계는 위 계산보다 계단처럼 나타나요.
Vector addition처럼 shared memory를 쓰지 않으면 $S_{\text{block}}=0$이에요. 이때는 $B_{\text{shared}}=\infty$로 놓아서 shared memory가 block 수를 제한하지 않게 해요.
그렇다고 occupancy 숫자만 계속 올리면 빨라지는 건 아니에요. Memory 대기가 이미 충분히 가려졌다면 더 올려도 얻을 게 없거든요. Thread당 register까지 억지로 줄이다 보면 계산이 오히려 느려질 수 있어요.
숫자는 좋아졌는데 시간은 더 걸리면.. 좀 억울하겠죠 ^^;;
한 thread가 서로 독립적인 여러 명령을 함께 준비하는 instruction-level parallelism도 봐야 해요. DRAM bandwidth나 cache가 어떻게 동작하는지도 성능에 영향을 주고요.
실제 값을 보려면 NVIDIA의 CUDA kernel 분석 도구인 Nsight Compute를 사용할 수 있어요. 실행 중 hardware 상태를 세는 측정 항목을 counter라고 해요. 그중 sm__warps_active.avg.pct_of_peak_sustained_active는 실제로 resident 상태였던 warp 비율, achieved occupancy를 보여줘요.
Warp를 충분히 올려두었어도 필요 없는 memory 구간까지 읽어오면 bandwidth가 낭비돼요. 이번에는 warp 하나가 data를 얼마나 알뜰하게 가져오는지 봐볼게요.
메모리 병합 (Coalescing)
Global memory는 GPU에 달린 DRAM이에요. cudaMalloc으로 allocation한 배열도 여기에 놓여요. Warp의 32개 thread가 읽기를 요청하면 GPU는 가까운 주소끼리 묶어서 처리하는데요. 여러 lane의 인접한 memory 요청을 가능한 적은 전송으로 합치는 동작을 coalescing이라고 해요.
Compute capability 6.0 이상에서는 global memory를 32-byte sector 단위로 전송해요. Sector는 memory system이 한꺼번에 가져오는 32-byte 주소 구간이에요. Warp가 연속된 4-byte 값 32개를 읽으면 128 bytes가 필요하니 sector 4개를 가져와요. Lane마다 멀리 떨어진 주소를 읽으면 더 많은 sector가 필요해지고요.
Warp가 load 한 번으로 건드린 서로 다른 sector 수를 $S$라고 해볼게요. Bus efficiency $\eta$는 kernel이 요청한 byte 수를, sector 단위로 실제 전송한 byte 수로 나눈 값이에요. 요청한 만큼만 옮겼는지 비교하는 거예요.
$$ S = \bigl|\{\, \lfloor \text{addr}_{\text{lane}}/32 \rfloor \,\}\bigr|, \qquad \eta = \frac{\text{requested bytes}}{32\,S} $$addr는 lane마다 요청한 byte 주소예요. $\lfloor\text{addr}_{\text{lane}}/32\rfloor$로 그 주소가 속한 sector 번호를 구하고, 바깥의 집합 크기로 서로 다른 sector가 몇 개인지 $S$를 세요.
Warp가 float 32개를 읽으면 필요한 양은 $32\times4=128$ bytes예요. 같은 양을 요청하더라도 주소 배치에 따라 실제로 전송하는 양이 달라져요.
- 주소가 연속되고 32-byte 경계에 맞으면 sector 4개로 충분해요. $S=4$이니 $\eta=128/(32\cdot4)=1$이에요. 128-byte 전송 한 번으로 읽는다는 뜻은 아니고, 32-byte sector 네 개에서 가져온 내용을 모두 쓴 경우랍니다.
- Lane마다 서로 다른 sector에 접근하면 32개가 필요해요. 요청한 건 128 bytes인데 $32\cdot32=1024$ bytes가 이동해서 $\eta=128/1024=1/8$이 돼요. Compute capability 6.0 이후의 sector 방식을 기준으로, 4-byte 원소를 읽을 때 최저 효율은 $1/8$이에요.

Vector addition의 i = blockIdx.x * blockDim.x + threadIdx.x를 보면 이웃 lane이 a[0], a[1], a[2]처럼 이웃 주소를 읽어요. 이 경우에는 연속된 sector 4개를 써서 $\eta=1$이 돼요.
그런데 a[i * stride]처럼 index 사이를 일정 간격으로 건너뛰면 이야기가 달라져요. stride가 커질수록 sector를 더 많이 가져와야 하고, 효율도 $1/8$에 가까워져요.
필요한 건 조금인데 덩어리째 받아오느라 나머지를 남기네요. 이럴 때는 memory가 바쁜 데에도 이유가 있겠죠ㅠㅠ
Nsight Compute에서 l1tex__t_sectors_pipe_lsu_mem_global_op_ld.sum을 보면 global load로 가져온 sector 수를 알 수 있어요. l1tex__t_requests_pipe_lsu_mem_global_op_ld.sum은 load 명령 요청 수이고요. 둘을 나누면 요청 하나당 평균 sector 수가 나와요.
Warp 전체가 32-bit 값을 읽는 경우라면 이상적인 값은 4, 가장 흩어진 경우는 32예요. Thread를 x축의 연속된 주소에 배치하는 건 이 값을 4에 가깝게 유지하려는 거예요.
Memory 접근을 봤으니 이제 thread끼리 어디까지 함께 일할 수 있는지 볼게요. CUDA에서는 그 기본 범위를 block으로 잡아요.
Block 독립성
같은 block의 thread들은 shared memory를 같이 쓰고 __syncthreads()로 실행 시점을 맞출 수 있어요. Block의 모든 thread가 그 위치에 도착할 때까지 기다리는 barrier예요. 참여자가 모두 와야 다음 명령으로 넘어가는 동기화 지점이라고 보시면 돼요.
하지만 서로 다른 block까지 이 barrier로 기다리게 할 수는 없어요. 일반 kernel의 block은 서로 독립적이어야 하고, 실행 순서도 정해져 있지 않아요. Block 7이 block 0보다 먼저 끝날 수도 있답니다. Kernel 안에서 임의의 두 block을 모두 기다리게 하는 일반적인 barrier는 없어요.
그렇다고 서로 다른 block끼리 값을 전할 수 없는 건 아니에요. Global memory를 통해 전달할 수 있어요. Atomic operation은 다른 thread의 연산이 중간에 끼지 못하도록 memory 연산을 한 단위로 처리해주고요.
여기서는 memory order도 챙겨야 해요. 여러 thread의 읽기와 쓰기가 다른 thread에 어떤 순서로 관찰되는지 정하는 개념이에요. 동기화와 memory order를 지정하지 않으면, 한 block이 쓴 값이 다른 block에 언제 보이는지, 즉 memory visibility와 실행 순서가 보장되지 않아요.
Grid 전체가 기다려야 한다면 kernel을 두 번 launch해서 첫 kernel이 끝난 뒤 다음 kernel을 실행할 수 있어요. 여러 thread의 협력 범위를 표현하는 API인 Cooperative Groups도 있어요. Grid 전체 동기화를 허용하는 cooperative launch를 쓰면 grid.sync()로 모든 block의 실행 시점을 맞출 수 있답니다.
Hopper에는 여러 block을 한 묶음으로 배치하는 thread block cluster가 있어요. 이 cluster 안에서는 서로 연결된 shared memory 영역인 distributed shared memory도 사용할 수 있어요.
일반적인 block끼리 shared memory를 함께 쓰지 못하는 건 physical memory 구조 때문이에요. 같은 block의 thread는 한 SM에 있으니, 그 SM의 빠른 정적 memory인 SRAM31으로 구현한 shared memory를 같이 쓸 수 있어요. 하지만 서로 다른 SM의 SRAM은 분리돼 있거든요.
Block이 독립적으로 실행되도록 만들면 배치는 유연해져요. CUDA Runtime이 준비된 block을 사용 가능한 SM에 순서와 관계없이 올릴 수 있답니다.
SM이 적으면 여러 차례 나눠 실행하고, 많으면 더 많은 block을 동시에 실행해요. 같은 kernel이 GPU의 SM 수에 맞춰 확장되는 이 성질을 NVIDIA에서는 transparent scalability라고 불러요.
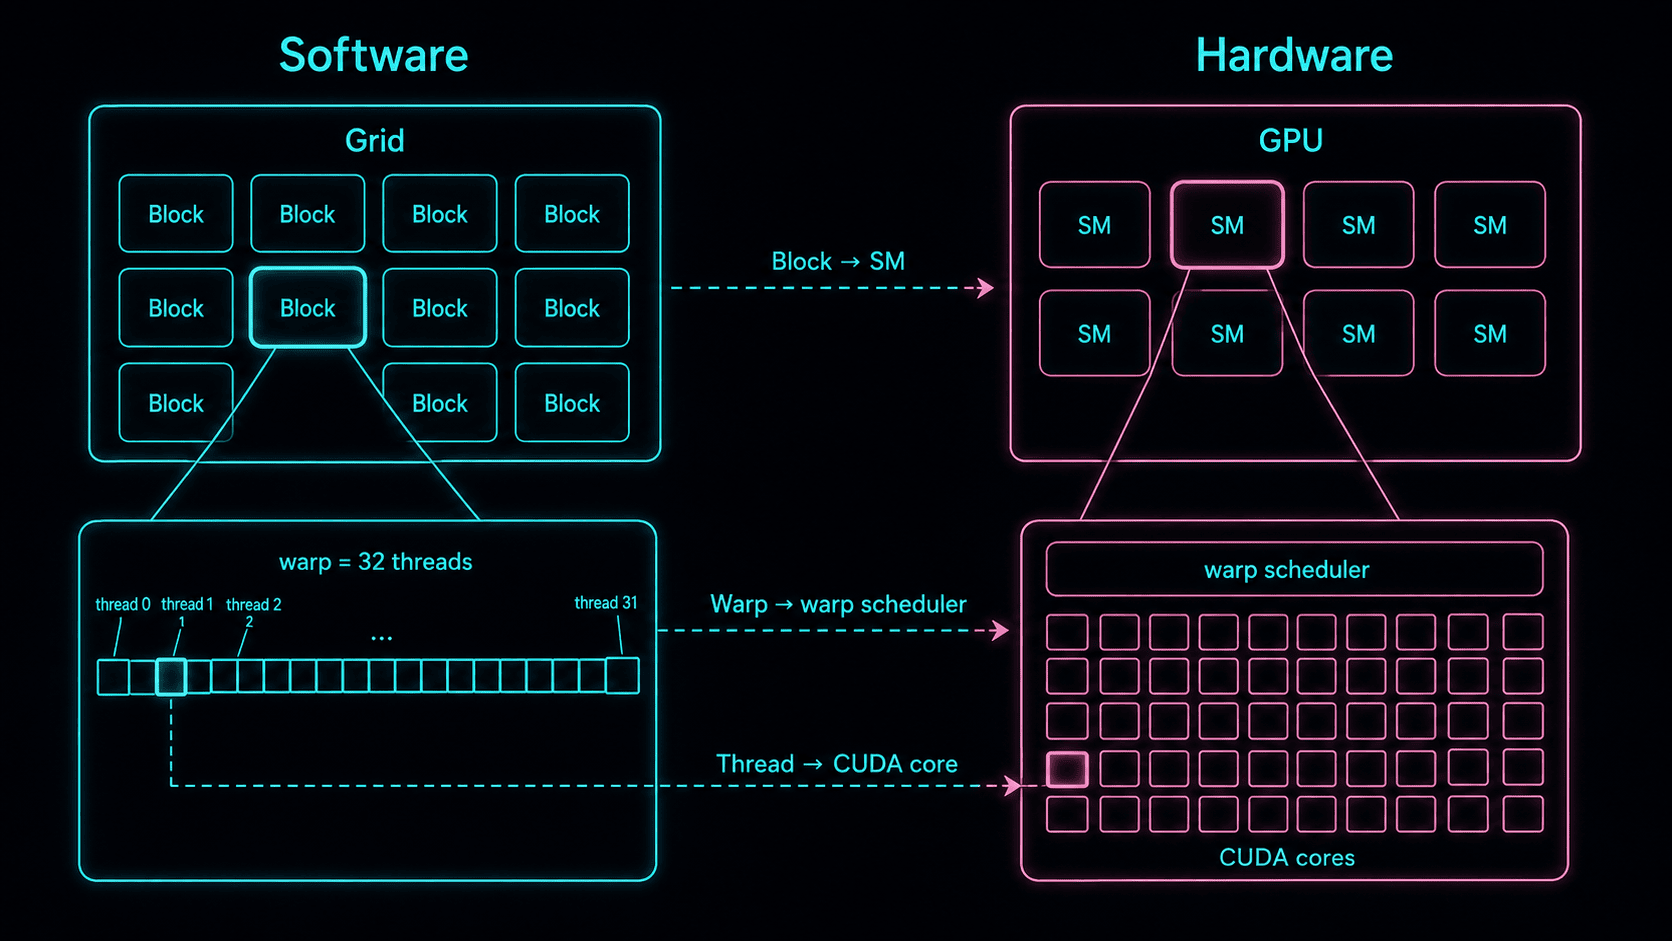
Grid, block, thread는 software에서 만드는 실행 구조예요. SM, warp, lane은 그 실행을 맡는 hardware 쪽 구조이고요. 둘을 고정된 1대1 관계로 연결하기보다는 어떻게 scheduling되는지 보셔야 해요.
Block을 SM 하나에 배치하면, SM은 그 안의 thread를 warp 단위로 issue해요. CUDA core는 lane 하나의 수치 연산을 처리하는 연산 장치예요. Thread는 program counter와 register 상태를 가진 논리적인 실행 단위라서 특정 CUDA core 하나를 계속 소유하지는 않아요.
Thread 번호마다 전용 core가 하나씩 붙는 줄 알면 헷갈리겠죠? 배치 관계를 그림으로 같이 봐주세요~
이번에는 software 쪽에서 grid와 block으로 배열 좌표를 어떻게 표현하는지 볼게요.
배열이나 image, volume data의 좌표를 자연스럽게 쓰도록 grid와 block은 1차원, 2차원, 3차원을 지원해요. 1차원 kernel<<<4, 8>>>이면 block 4개에 thread를 8개씩 넣으니 총 32개 thread예요. 2차원과 3차원은 앞에서 본 dim3로 각 축의 크기를 정하면 돼요.
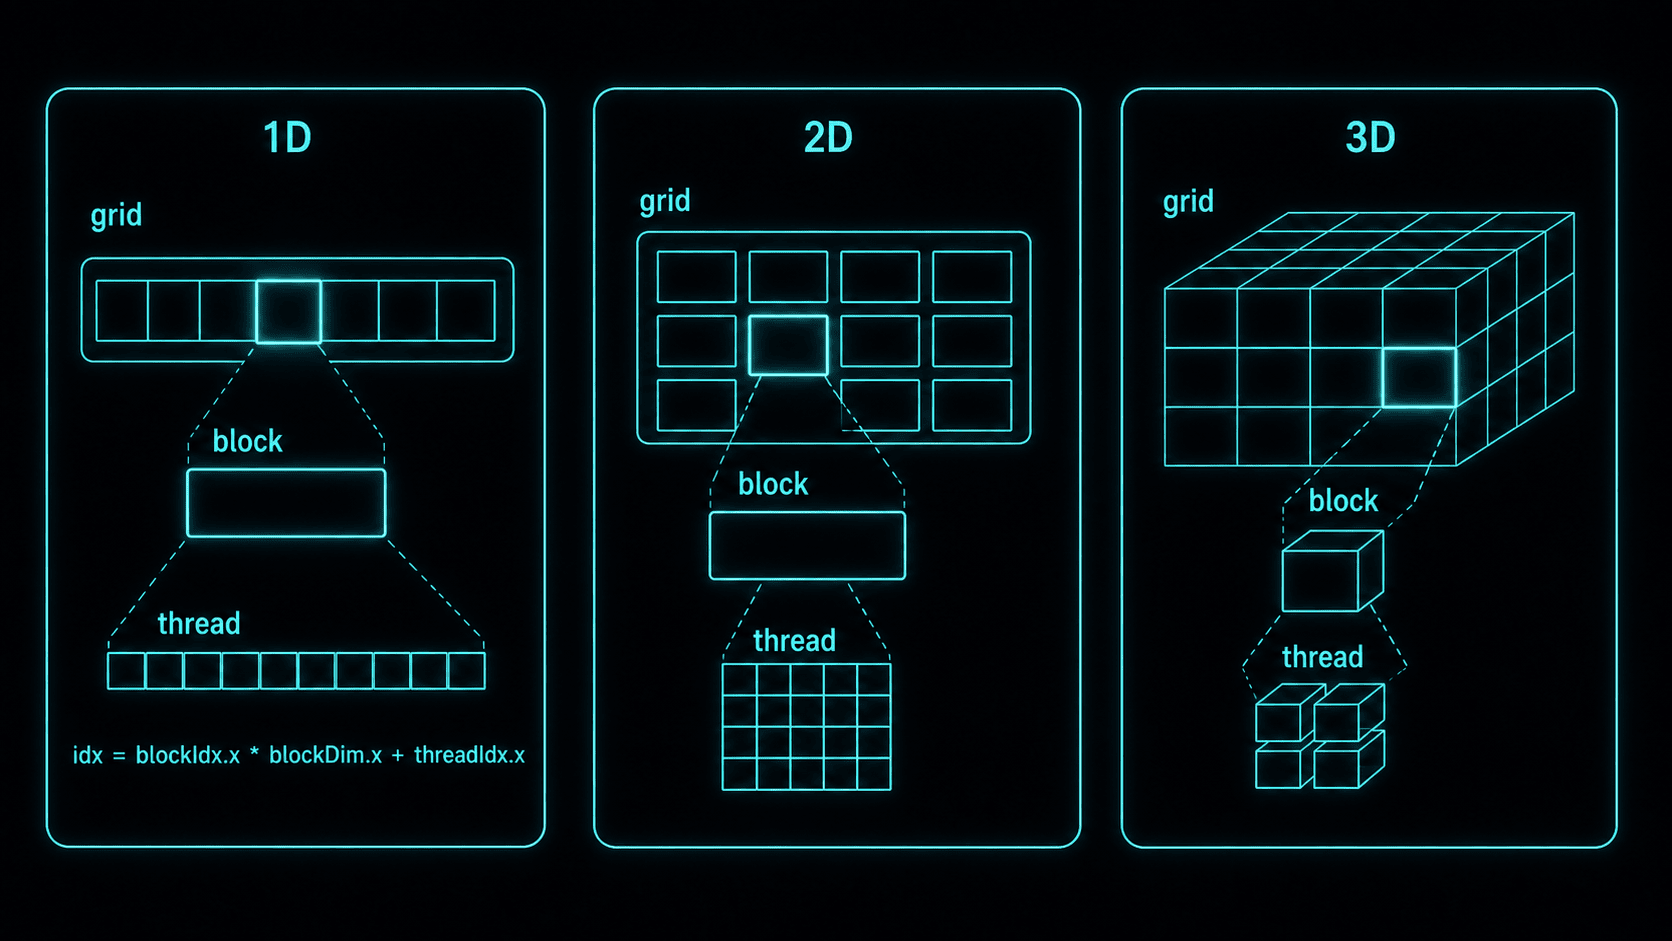
이렇게 정한 차원과 크기를 kernel launch에 전달할 때 쓰는 문법이 <<<...>>>예요.
실행 구성: <<<>>>
__global__ 함수는 일반 함수처럼 호출해서 시작할 수 없어요. CUDA kernel의 실행 구성을 지정하는 세 겹 꺾쇠, triple chevron 문법을 써야 해요. 처음 보면 꺾쇠가 좀 많죠ㅎㅎ
mykernel<<<gridSize, blockSize>>>(args);
//        ^^^^^^^^  ^^^^^^^^^
//        Block 개수, Block당 thread 개수
gridSize: grid 안의 block 개수blockSize: block 안의 thread 개수args: kernel에 전달할 값이나 pointer- 총 thread 수 =
gridSize × blockSize
첫째 값이 grid 크기, 둘째 값이 block 크기예요. Kernel 안에서는 CUDA가 자동으로 제공하는 built-in 변수로 이 정보를 읽을 수 있어요. gridDim과 blockDim에는 크기가, blockIdx와 threadIdx에는 현재 block과 thread의 번호가 들어 있어요.
<<<gridSize, blockSize>>>에서 직접 정하는 건 software의 실행 구성이에요. SM이나 warp를 지정하는 자리는 아니에요. CUDA Runtime이 block을 SM에 올리면, 그 안의 thread를 SM이 32개씩 warp로 묶어 실행해줘요.
아주 작게 실행해보는 구성은 이래요.
mykernel<<<1, 1>>>(); // Block 1개, thread 1개
Vector addition에서 원소 하나에 thread 하나를 맡기려면 N개 원소에 N개 thread가 필요해요. <<<N, 1>>>도 합계는 N개라 맞아 보이는데요. Block마다 thread가 하나뿐이라 각 warp에서 lane 하나만 쓰게 돼요.
개수는 맞췄는데 자리가 너무 널널하네요..ㅎㅎ
보통은 block마다 thread를 128개에서 512개 정도로 묶어요. N을 그 block 크기로 올림 나눗셈하면 필요한 grid 크기를 구할 수 있어요. 아래의 int는 정수를 담는 자료형이에요.
int N = 10000;
int blockSize = 256;
int gridSize = (N + blockSize - 1) / blockSize;  // 올림 나눗셈
add<<<gridSize, blockSize>>>(a, b, c, N);
여기까지는 thread 하나가 원소 하나를 처리했어요. Grid 크기를 data 크기와 따로 정하고 싶다면, thread 하나가 여러 원소를 처리하는 grid-stride loop를 쓸 수 있어요.
이때 stride는 한 번의 launch로 만든 전체 thread 수, blockDim.x * gridDim.x예요. Thread마다 이 간격으로 index를 늘려가면, N이 전체 thread 수보다 커도 모든 원소를 처리할 수 있답니다. 코드의 float*는 float 값이 놓인 메모리를 가리키는 pointer예요. for 반복문은 조건을 만족하는 동안 같은 코드를 되풀이하고, i += stride는 i에 stride를 더해 다음 원소 번호로 넘어가요.
__global__ void add(float* a, float* b, float* c, int N) {
    int stride = blockDim.x * gridDim.x;
    int i = blockIdx.x * blockDim.x + threadIdx.x;
    for (; i < N; i += stride)
        c[i] = a[i] + b[i];
}
전체 예제: 벡터 덧셈
이제 host-device 복사, qualifier, kernel launch를 한 파일에 모아볼게요. 입력을 준비하는 곳부터 계산 결과를 가져오고 memory를 정리하는 곳까지 이어서 보시면 돼요. 처음 나오는 C++ 표기도 몇 개 짚고 갈게요.32
#include <cstdlib>
#include <cuda_runtime.h>

__global__ void add(const float* a, const float* b,
                    float* c, int N) {
    int i = blockIdx.x * blockDim.x + threadIdx.x;
    if (i < N) c[i] = a[i] + b[i];   // 경계 밖 thread는 건너뛴다
}

int main() {
    const int N = 1 << 20;                 // 원소 약 100만 개
    const size_t bytes = N * sizeof(float);

    // 1) Host 할당 + 초기화
    float *h_a = (float*)malloc(bytes);
    float *h_b = (float*)malloc(bytes);
    float *h_c = (float*)malloc(bytes);
    for (int i = 0; i < N; i++) { h_a[i] = 1.0f; h_b[i] = 2.0f; }

    // 2) Device 할당
    float *d_a, *d_b, *d_c;
    cudaMalloc(&d_a, bytes);
    cudaMalloc(&d_b, bytes);
    cudaMalloc(&d_c, bytes);

    // 3) Host -> Device 전송
    cudaMemcpy(d_a, h_a, bytes, cudaMemcpyHostToDevice);
    cudaMemcpy(d_b, h_b, bytes, cudaMemcpyHostToDevice);

    // 4) 커널 실행 (block당 256 thread, grid는 올림 나눗셈)
    int blockSize = 256;
    int gridSize = (N + blockSize - 1) / blockSize;
    add<<<gridSize, blockSize>>>(d_a, d_b, d_c, N);

    // 5) Device -> Host 전송 (kernel 결과가 준비된 뒤 복사)
    cudaMemcpy(h_c, d_c, bytes, cudaMemcpyDeviceToHost);

    // 6) 정리
    cudaFree(d_a); cudaFree(d_b); cudaFree(d_c);
    free(h_a); free(h_b); free(h_c);
    return 0;
}
__global__은 add가 device에서 실행할 kernel이라는 표시예요. 변수 이름 앞의 h_, d_는 각각 host memory와 device memory를 가리키는 pointer에 붙이는 관례이고요. N = 1 << 20은 1을 왼쪽으로 20 bit 옮긴 값이라 $2^{20}=1,048,576$이에요. Float 원소 N개의 전체 byte 수를 bytes에 담아요.
malloc으로 host 배열을 만들고, cudaMalloc(&d_a, bytes)로 device memory를 확보해요. cudaMalloc이 시작 주소를 d_a에 써줘야 해서, 전달하는 값도 d_a 자체가 아닌 그 주소 &d_a예요. Host에서 h_a, h_b를 초기화한 뒤에는 H2D cudaMemcpy 두 번으로 입력을 device에 보내요.
gridSize는 N을 blockSize로 올림 나눗셈한 값이에요. 마지막 block에는 N의 범위를 벗어나는 thread가 생길 수 있죠. 그래서 kernel의 if (i < N)으로 그 thread가 memory에 접근하지 않도록 막아둬요.
Kernel이 결과를 d_c에 쓰면 D2H cudaMemcpy로 h_c에 가져와요. 마지막에는 cudaFree로 device memory를, free로 host memory를 해제해요. 할당한 곳에 맞춰 정리까지 해주시면 돼요.
컴파일은 아래 명령으로 해요.
nvcc vector_add.cu -o vector_add
참, 예제에서는 실행 흐름을 보기 쉽도록 오류 검사를 생략했어요. CUDA Runtime 함수는 성공 여부를 상태값으로 돌려주니 실제 프로그램에서는 반환값을 확인해주세요. Kernel launch 직후에는 cudaGetLastError()로 launch 오류도 확인해야 해요.
Roofline으로 보는 Memory 병목
Vector addition이 얼마나 빠를지는 GPU의 산술 처리량보다 memory bandwidth에 크게 영향을 받아요. Float 원소 하나를 더할 때 a, b에서 4 bytes씩 읽고 c에 4 bytes를 써서 총 12 bytes를 옮겨요. 계산은 실수 덧셈 한 번, 1 FLOP이고요. 덧셈하느라 바쁠지, 값을 옮기느라 바쁠지 숫자로 볼게요.
연산량을 $W$, memory에서 옮긴 data 양을 $Q$로 둘게요. Arithmetic intensity $I=W/Q$는 1 byte를 옮길 동안 실수 연산을 몇 번 하는지 나타내요.
$$ \begin{aligned} Q &= 2 \times 4\,\text{B} \;+\; 1 \times 4\,\text{B} = 12\,\text{B} \quad(\text{load } a,b\text{; store } c) \\ I &= \frac{W}{Q} = \frac{1\ \text{FLOP}}{12\ \text{B}} \approx 0.083\ \text{FLOP/B} \end{aligned} $$Roofline model에서는 kernel의 처리량 상한을 연산 능력과 memory 공급 능력으로 나눠 봐요. 달성 가능한 처리량은 $P$, GPU의 최대 연산 처리량은 $P_{\text{peak}}$, memory bandwidth는 $\beta$로 적을게요.
Memory가 초당 $\beta$ bytes를 보내고 byte마다 $I$번 계산한다면, memory 공급으로 가능한 상한은 $I\beta$ FLOP/s예요. 실제 상한은 이 값과 GPU의 연산 한도, 즉 $P_{\text{peak}}$와 $I\beta$ 가운데 작은 쪽으로 정해져요.
$$P = \min\!\bigl(P_{\text{peak}},\ I \cdot \beta\bigr)$$Graph의 가로축은 arithmetic intensity $I$, 세로축은 처리량 $P$예요. $I\beta$는 오른쪽으로 갈수록 올라가는 선이고, $P_{\text{peak}}$는 수평선으로 그려져요.
두 선이 만나는 곳을 ridge point라고 해요. $I^{*}=P_{\text{peak}}/\beta$로 계산할 수 있어요. 이 지점의 왼쪽에서는 memory 공급이, 오른쪽에서는 GPU의 연산 능력이 상한을 정해요.

A100의 수치를 넣어볼게요. 32-bit 실수 연산인 FP32 peak가 약 19.5 TFLOP/s, HBM bandwidth가 약 2.0 TB/s예요. TFLOP/s는 1초에 $10^{12}$번 실수 연산, TB/s는 1초에 $10^{12}$ bytes 전송이라는 뜻이에요. 이 둘로 ridge point를 구하면 아래처럼 나와요.
$$I^{*} = \frac{19.5 \times 10^{12}}{2.0 \times 10^{12}} \approx 9.75 \ \text{FLOP/byte}$$Vector addition의 $I=0.083$ FLOP/byte는 ridge point인 9.75 FLOP/byte보다 100배 이상 작아요. 연산 장치의 한도에 가기 전에 memory bandwidth가 먼저 한계에 닿는 거죠. Memory bandwidth로 계산한 처리량 상한도 구해볼게요.
$$ \begin{aligned} P_{\text{vadd}} = I \cdot \beta &= \frac{1\ \text{FLOP}}{12\ \text{B}} \times 2.0\times10^{12}\ \text{B/s} \\ &= 1.67\times10^{11}\ \text{FLOP/s} \\ &\approx 166\ \text{GFLOP/s} \quad(0.85\%\ \text{of peak}) \end{aligned} $$166 GFLOP/s면 A100 FP32 peak의 약 0.85%예요. 여기서 GFLOP/s는 1초에 $10^9$번 실수 연산을 뜻해요. Peak 숫자만 생각하면 너무 적어 보이겠지만, 이 계산은 memory가 공급하는 양에 맞춰 나온 값이랍니다.
그래서 vector addition은 GPU의 산술 능력을 전부 쓰는 예제로 보기는 어려워요. Memory bandwidth와 병렬 index 배치를 익히기에 좋은 예제예요. Matrix multiplication처럼 한 번 읽은 값을 여러 계산에 재사용하면 arithmetic intensity를 높여서 ridge point 오른쪽으로 이동할 수 있어요.
배열 두 개 더하는 코드에서 시작했는데 복사할 양도, thread 자리도 꽤 챙겼네요ㅎㅎ 다음 계산을 볼 때도 값을 몇 번 읽고 몇 번 쓰는지 함께 봐주세요~
참고
- CUDA C++ Programming Guide: 프로그래밍 모델, occupancy, 메모리 계층의 1차 출처
- CUDA Compiler Driver NVCC: 컴파일 파이프라인과
-gencode - Nsight Compute: occupancy·병목 자원 진단
스티커: LINE Moon · Moon & James · LINE Characters in Love!
CPU(Central Processing Unit)는 프로그램의 실행 순서와 일반 연산을 맡는 중앙처리장치예요. GPU(Graphics Processing Unit)는 많은 데이터에 비슷한 연산을 병렬로 적용하는 데 맞춘 처리장치이고요. ↩︎
Runtime은 프로그램이 실행되는 동안 메모리 할당이나 GPU 작업 실행을 지원하는 코드예요. CUDA Runtime은 Driver API를 통해 GPU에 일을 요청하면서 초기화 같은 세부 작업도 처리해줘요. Compiler와 개발용 library, 도구를 모아 설치하는 배포 묶음은 CUDA Toolkit이라고 해요. ↩︎
cudaMalloc은 GPU에서 쓸 메모리 영역을 확보하고,cudaMemcpy는 지정한 두 메모리 영역 사이에서 데이터를 복사해요. 함수 호출의 인자와 방향은 아래 데이터 흐름 예제에서 하나씩 볼게요. ↩︎Neural network(신경망)는 입력에 가중치를 곱하고 값을 변환하는 계산 단위를 연결한 모델이에요. 그 계산을 여러 층으로 쌓은 것이 deep neural network이고, 데이터에 맞춰 가중치를 조정하는 학습을 딥러닝이라고 불러요. ↩︎
숫자 배열 계산과 신경망 학습을 작성하는 데 쓰는 공개 software예요. 사용자가 Python 등으로 작성한 연산을 CPU나 GPU에서 실행하도록 연결해줘요. ↩︎
여러 꼭짓점을 이은 다각형이에요. 3D 그래픽에서는 물체 표면을 주로 삼각형 조각으로 표현해서 화면에 그려요. ↩︎
Pixel(픽셀)은 이미지의 색을 담는 가장 작은 칸이에요. 그 칸들을 행과 열로 배열한 것이 픽셀 행렬이랍니다. ↩︎
학습(training)은 예제 데이터로 모델의 가중치를 조정하는 과정이에요. 추론(inference)은 그렇게 정한 가중치로 새 입력의 결과를 계산하는 과정이고요. ↩︎
시뮬레이션에서 위치와 속도 등의 상태를 가진 개별 입자예요. 실제 원자일 수도 있고, 유체의 작은 영역을 대표하도록 만든 계산용 입자일 수도 있어요. ↩︎
CPU 같은 처리 장치 안에서 명령을 실행하는 연산 부분이에요. 여기서는 CPU core를 말하며, 뒤에 나오는 GPU의 CUDA core와 실행 구조나 맡는 범위가 같지는 않아요. ↩︎
멀리 있는 큰 메모리의 데이터를 가까운 작은 메모리에 보관해, 같은 값을 다시 읽을 때 기다림을 줄이는 장치예요. Cache에 없는 값은 원래 메모리에서 가져와야 해요. ↩︎
Random Access Memory의 약자로, 실행 중인 프로그램과 데이터를 두는 메모리예요. 여기서는 CPU와 GPU가 함께 사용하는 시스템의 실제 주기억장치를 가리켜요. ↩︎
Byte는 메모리 크기를 세는 단위예요. 1 byte는 0 또는 1을 담는 bit 8개이고, CUDA 예제의 32-bit 값 하나는 4 bytes를 차지해요. ↩︎
Gen4와 Gen5는 PCIe 규격의 세대이고, x16은 연결에 쓰는 통신 경로가 16개라는 뜻이에요. GB/s는 1초에 10억 bytes, TB/s는 1초에 1조 bytes를 옮긴다는 단위예요. 여기의 PCIe 통신 경로는 뒤에서 나올 warp의 lane과는 다른 개념이랍니다. ↩︎
C2C는 Chip-to-Chip이에요. 서로 다른 칩을 직접 이어서 데이터를 주고받게 하는 NVLink 연결로, 여기서는 GH200의 CPU와 GPU 사이 통로예요. ↩︎
여러 메모리 칩을 수직으로 쌓고 GPU와 넓은 데이터 통로로 연결한 메모리예요. 많은 데이터를 동시에 주고받도록 설계해서 GPU의 대규모 계산에 값을 공급해요. ↩︎
C/C++에서 지정한 byte 수만큼 host 메모리를 확보하고 시작 주소를 돌려주는 함수예요. 쓰고 나면
free로 해제해요. ↩︎프로그램이 접근한 메모리의 page(운영체제가 관리하는 일정 크기 구간)가 아직 RAM에 없거나 접근 준비가 안 되어 발생하는 처리 요청이에요. 운영체제 등이 필요한 데이터를 준비하거나 주소 연결을 갱신해야 원래 접근을 계속할 수 있어요. ↩︎
Dynamic Random Access Memory예요. 저장한 값을 유지하려고 주기적으로 전하를 보충하는 메모리로, 큰 용량을 제공하기 좋아 시스템 RAM이나 GPU의 큰 메모리에 쓰여요. ↩︎
배열에서 몇 번째 원소인지 나타내는 번호예요. C/C++의 배열은 0부터 세므로
a[0]이 첫 원소이고,a[N - 1]이 N개 배열의 마지막 원소예요. ↩︎반환형은 함수가 호출한 쪽에 돌려줄 값의 자료형이에요.
void는 그런 반환값이 없다는 뜻이며, kernel은 pointer로 전달받은 메모리에 결과를 써서 전달해요. ↩︎명령어와 연산 장치, 메모리 등을 어떤 규칙과 구조로 구성했는지를 말해요. 여기서는 그 구조가 같은 GPU 세대를 구분하는 뜻으로 쓰고 있어요. ↩︎
PTX 코드 안에서 중간값을 담는 가상의 저장 이름이에요. 이 예제의
%r는 정수,%f는 실수,%rd는 64-bit 주소 계산,%p는 참·거짓 조건을 담으며, 이름 앞의@%p1은 그 조건이 참일 때만 뒤의 명령을 실행한다는 표시예요. 실제 register 배치는 최종 번역 때 정해져요. ↩︎FP32는 32-bit floating-point(부동소수점) 수 표현이에요. 소수점 위치를 고정하지 않고 유효 숫자와 크기를 나타내는 지수로 값을 저장하며, CUDA의
float가 이 형식이에요. ↩︎연산 장치가 계산할 수 있는 속도와 메모리가 데이터를 공급할 수 있는 속도를 함께 비교하는 성능 모델이에요. 둘 가운데 먼저 한계에 닿는 쪽을 보면 어떤 자원이 성능을 막는지, 즉 병목인지 알 수 있어요. ↩︎
컴파일해서 만든 실행 코드가 들어 있는 파일이에요.
cuobjdump는 그 안의 GPU 코드를 사람이 읽을 수 있는 명령어 표기로 보여주는 도구예요. ↩︎Level 1 cache예요. GPU에서는 각 SM 가까이에 두는 첫 단계 cache로, 자주 쓰는 데이터 접근을 빠르게 처리해요. ↩︎
Warp의 32개 lane 가운데 어느 lane이 현재 명령에 참여하는지 bit 하나씩으로 표시한 값이에요. Mask에서 켜진 bit에 해당하는 lane만 그 명령의 작업에 참여해요. ↩︎
같은 warp의 thread라도 다음 명령 위치와 대기 상태를 따로 관리할 수 있는 방식이에요. 여전히 명령은 warp의 lane 묶음에 발행하므로, thread 32개가 각각 전용 연산 장치를 얻는다는 뜻은 아니에요. ↩︎
어떤 분기점에서 어느 경로를 선택하더라도 종료로 가려면 반드시 지나야 하는 지점을 말해요. 코드의 경로 관계에 관한 말이라서, 그 지점이 모든 thread의 도착을 기다리는 동기화 지점이라는 뜻은 아니에요. ↩︎
Static Random Access Memory예요. 전원이 공급되는 동안 DRAM처럼 주기적으로 값을 재충전할 필요가 없는 저장 회로라, 작고 빠른 cache나 shared memory에 쓰여요. ↩︎
#include는 함수와 자료형 선언이 들어 있는 header를 불러오는 표시예요.<cstdlib>는malloc과free같은 C 표준 기능을,<cuda_runtime.h>는 CUDA Runtime 기능을 쓰게 해주며,main은 프로그램이 시작하는 함수예요.const float*는 그 pointer를 통해 입력값을 바꾸지 않겠다는 뜻이에요.size_t는 byte 수처럼 크기를 담는 정수형이고,sizeof(float)는 float 값 하나의 byte 수를 구해요.(float*)는 주소를 float pointer로 해석하는 형 변환이에요.1.0f의f는 float 상수라는 표시고요. ↩︎