컴파일러는 사람이 읽고 쓰는 소스 코드를 CPU가 실행할 수 있게끔 기계어로 번역하는 프로그램이다. CPU는 태생적으로 기계어만 실행할 수 있으므로, C 같은 언어로 짠 코드는 실행하기 전에 반드시 이 번역을 한 번 거쳐야 한다.
번역을 언제 하느냐에 따라, 프로그램을 실행하는 방식은 크게 셋으로 갈라진다.
| 방식 | 번역 시점 | 실행 사이에 남는 것 | 예1 |
|---|---|---|---|
| 인터프리터 | 번역하지 않고 실행할 때마다 소스를 해석 | 없음 | CPython |
| JIT(just-in-time) | 실행 중에, 자주 실행되는 부분만 | 메모리에 둔 기계어 | Java JVM, 브라우저의 V8 |
| AOT(ahead-of-time) | 실행 전에 전부 | 실행 파일 | clang, GCC |
세 방식의 차이는 같은 함수를 반복해서 호출해 보면 시간으로 드러난다. 아래 그래프는 같은 정수 반복 계산을 CPython(인터프리터), numba2(JIT), clang -O2로 미리 컴파일한 C 라이브러리(AOT) 세 가지로 각각 12번씩 호출해서 잰 호출별 시간이다.
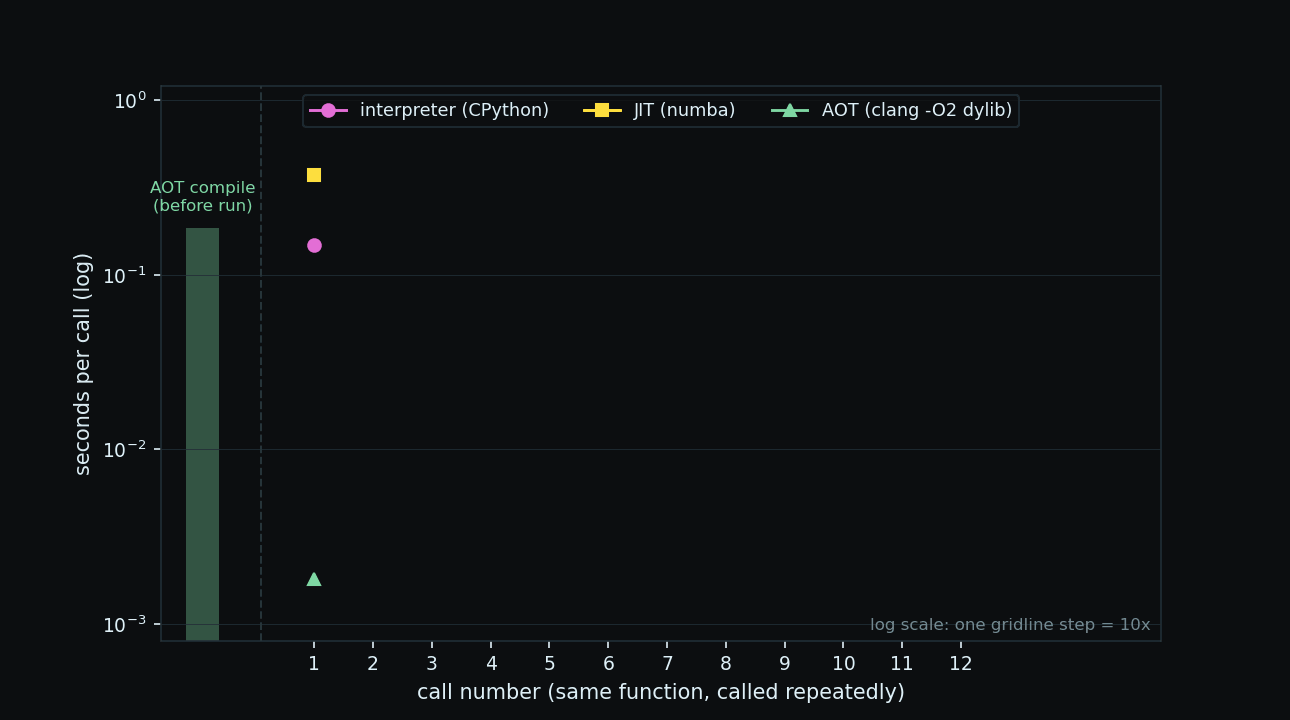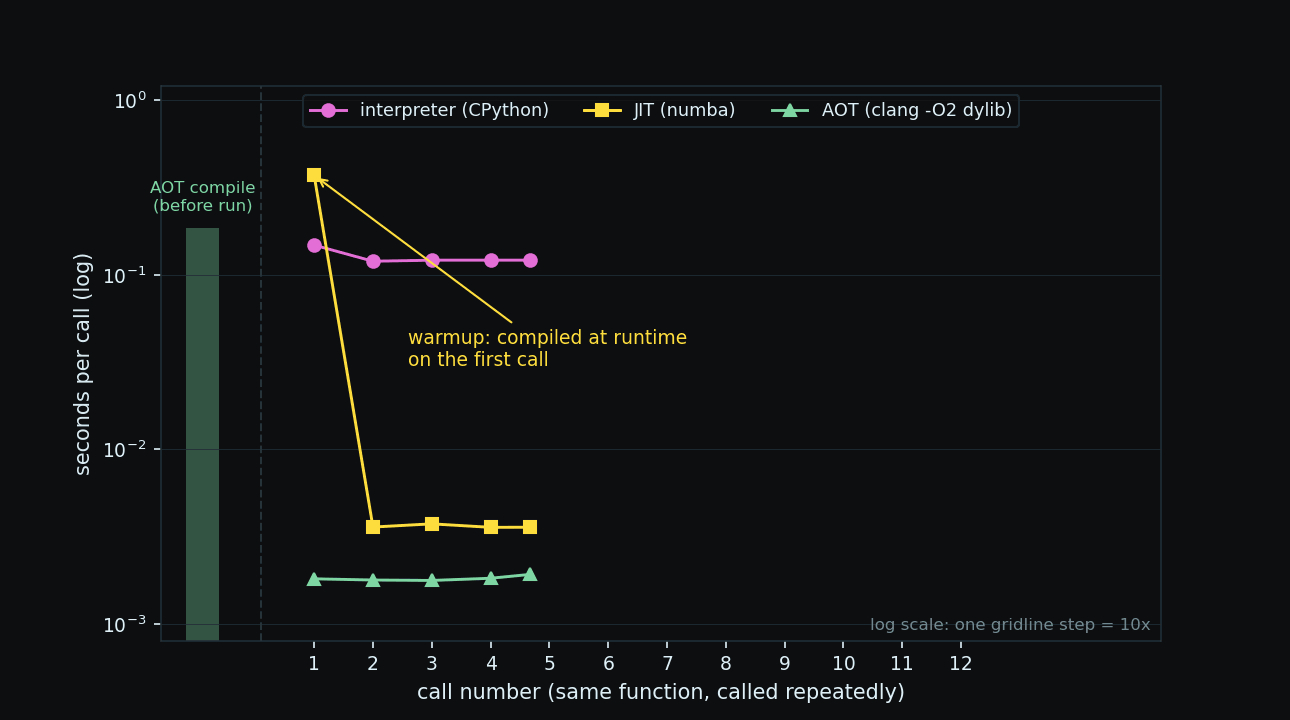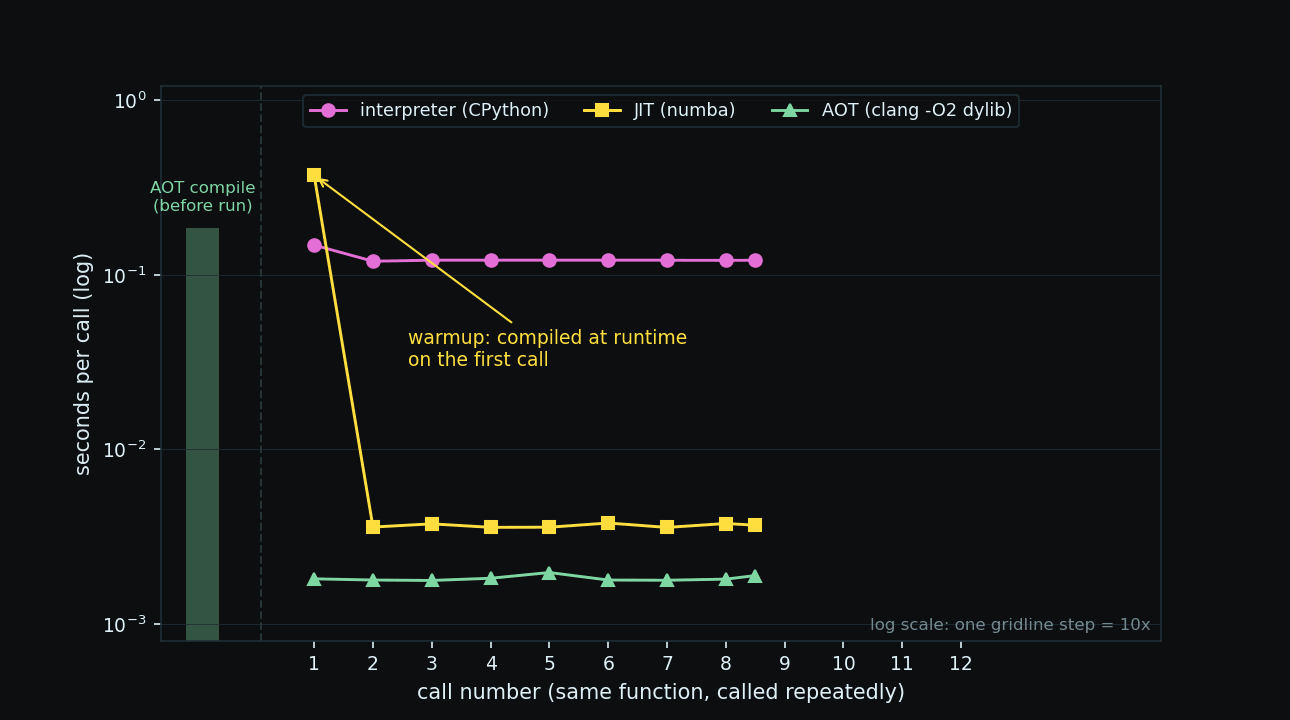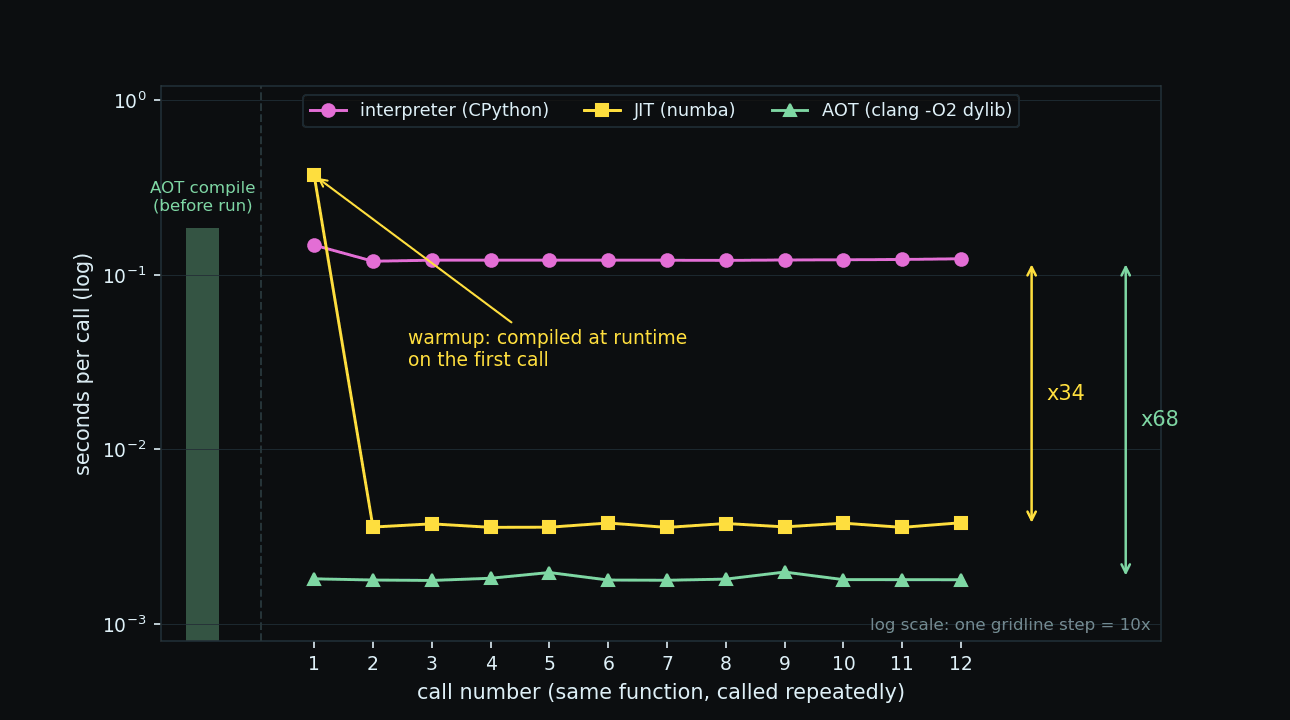
인터프리터는 호출마다 같은 해석을 되풀이해 매번 같은 비용을 낸다. JIT는 첫 호출에 컴파일 비용을 몰아 내고(warmup3) 그다음부터 번역된 기계어를 재사용하며, AOT는 그 비용을 실행 전에 내서 첫 호출부터 빠르다.
LLVM4은 C/C++ 같은 native 언어(가상 머신5 없이 CPU가 직접 실행하는 기계어로 번역되는 언어)를 위한 AOT 컴파일러다.
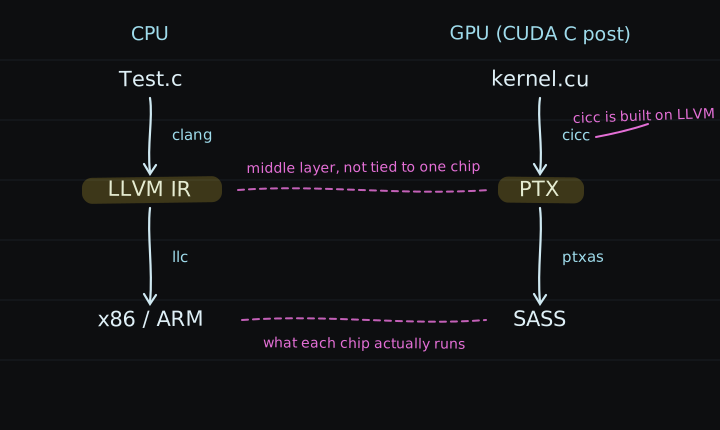
소스 코드를 곧바로 기계어로 바꾸지 않고 중간 언어를 거쳐 내려가는 구조는 CUDA C 기초의 nvcc에서도 이미 나왔다. NVIDIA의 CUDA 컴파일러인 nvcc는 .cu 파일을 CPU에서 실행할 host 코드와 GPU에서 실행할 device 코드로 나누어 처리하는데, device 코드를 PTX6라는 중간 명령어로 바꾸고, PTX를 GPU 기계어인 SASS로 내린다. CPU 쪽 컴파일러도 같은 방식으로 중간 단계를 거쳐 내려가며, 그 대표가 LLVM이다. 실제로 nvcc의 device 코드 컴파일러인 cicc가 LLVM 위에서 만들어져 있어서, 두 스택은 층별로 그대로 대응한다.
파이프라인

- 프론트엔드(clang):
Test.c→Test.ll. 파싱7과 타입 검사. - 미들엔드(opt):
Test.ll→Test.ll'. pass들이 IR을 고쳐 쓰는 최적화. - 백엔드(llc, as, ld):
Test.ll'→Test.s→Test.o→a.out. 기계어 생성과 조립.
IR(intermediate representation, 소스와 기계어 사이의 중간 언어) 하나가 프론트엔드, 미들엔드, 백엔드 세 구간을 전부 지나다닌다. 다른 컴파일러들은 IR을 메모리 안 객체로만 들고 있어서 파일로 꺼낼 수가 없다. LLVM IR은 문법이 공개된 텍스트라서, 파일로 저장해 놓고 손으로 고친 다음 컴파일러에 도로 넣는 것까지 된다.
C에서 IR로
예제는 두 함수짜리 C 파일이다.
// Test.c
int func1(void) { int a = 4; return a; }
int main(void)  { return 0; }
clang -emit-llvm -S Test.c # → Test.ll
-emit-llvm -S는 기계어까지 가지 않고 사람이 읽을 수 있는 IR에서 멈추라는 옵션이다. 나온 Test.ll의 func1은 다음과 같다.
define i32 @func1() #0 {
  %1 = alloca i32, align 4
  store i32 4, ptr %1, align 4
  %2 = load i32, ptr %1, align 4
  ret i32 %2
}
| IR | 뜻 | 대응 C 코드 |
|---|---|---|
define i32 @func1() #0 | i32(32비트 정수)를 반환하는 함수 func1 정의. #0은 attributes 묶음 참조 | int func1(void) |
%1 = alloca i32, align 4 | 스택8에 i32 한 칸 확보. 그 주소에 %1이라는 이름표9 | int a의 자리 |
store i32 4, ptr %1 | 그 주소에 4 저장 | a = 4 |
%2 = load i32, ptr %1 | 그 주소에서 읽어 %2에 담기 | return a의 a 읽기 |
ret i32 %2 | %2 반환 | return |
IR 본문에 나오는 기호는 이 4개다.
| 기호 | 뜻 |
|---|---|
i32 | 32비트 정수 타입. i1, i8, i64도 있다 |
%이름 | 지역 이름표. 가상 레지스터10라 개수 제한이 없다 |
@이름 | 전역 이름표. 함수 이름이 여기 속한다 |
; | 주석 |
파일 머리의 target triple11과 꼬리의 attributes12, ! 메타데이터는 환경 설정이라 본문 해독에는 필요 없다.13
IR에서 어셈블리로
llc Test.ll -o Test.s
llc는 IR을 target triple11이 가리키는 CPU의 어셈블리14로 내리는 백엔드 도구다. 그래서 출력되는 어셈블리는 대상 CPU마다 다르다. x86-64를 지정하면 x86-64 어셈블리가, ARM64를 지정하면 ARM64 어셈블리가, RISC-V를 지정하면 RISC-V 어셈블리가 나오고, llc -mtriple=x86_64-pc-linux-gnu Test.ll처럼 옵션으로 대상을 바꿀 수 있다. IR은 하나인데 백엔드가 대상별로 갈라지는 이 구조가 파이프라인 절에서 말한 IR의 역할이다.
다음은 ARM64 대상의 출력에서 func1을 대응시킨 표다.15
| Test.ll (가상) | Test.s (ARM 실물) | 뜻 |
|---|---|---|
%1 = alloca i32 | sub sp, sp, #16 | 스택 프레임 확보. %1의 실체는 sp+12 칸 |
store i32 4, ptr %1 | mov w8, #4 → str w8, [sp, #12] | 4를 레지스터에 담아 스택에 저장 |
%2 = load i32, ptr %1 | ldr w0, [sp, #12] | 스택에서 읽어 w0에. %2의 실체는 w0 |
ret i32 %2 | add sp, sp, #16 → ret | 프레임 반납 후 복귀. w0가 반환값 |
백엔드는 가상 이름표(%N)를 실물 장소(레지스터, 스택 칸)에 배정한다. 어셈블리 파일의 줄은 3종류다.
| 줄의 형태 | 정체 | 읽을 때 |
|---|---|---|
.으로 시작 | 어셈블러 지시자16 | 건너뜀 |
이름: | 라벨17 | 위치 표시 |
| 들여쓰인 줄 | CPU 명령 | 읽을 대상 |
Test.ll의 store i32 4를 store i32 9로 바꾸고 llc를 다시 돌리면 mov w8, #9가 나온다. IR 텍스트 자체가 컴파일러의 입력이라, 프론트엔드를 거치지 않고 IR을 고치는 것만으로 프로그램이 바뀐다.
어셈블리에서 실행 파일로
Test.s는 mov w8, #4 같은 명령이 문자로 적힌 텍스트 파일이다. 그런데 CPU는 명령마다 정해진 비트 패턴이 입력돼야 동작하는 회로라서, ’m’, ‘o’, ‘v’ 같은 문자 데이터를 명령으로 실행하지 못한다. 그래서 어셈블러(as)가 이 문자 표기를 명령 비트 패턴으로 바꾸는데, 그 결과물이 object 파일 Test.o다.
프로그램 하나는 보통 여러 소스 파일로 만들고, 소스 파일 하나가 object 파일 하나가 된다. 여기에 라이브러리(printf처럼 자주 쓰는 함수를 미리 컴파일해 둔 object 파일 묶음)가 더해진다. Object 파일은 기계어지만 혼자서는 실행되지 않는다. 자기가 호출하는 다른 object 파일이나 라이브러리 속 함수의 주소가 아직 비어 있기 때문이다. 링커(ld)가 이 object 파일들과 라이브러리를 모아 빈 주소를 채우고 하나로 이어 붙이면 실행 파일이 된다. 이 과정을 링크(link)라 한다.
clang -c Test.s -o Test.o   # assemble
clang Test.o -o a.out       # link
두 단계 모두 clang 명령으로 부를 수 있고, clang이 내부에서 as와 ld를 호출한다.
pass와 최적화 레벨
pass는 LLVM에 내장된 작은 프로그램으로, IR 전체를 한 차례 훑으며 정해진 한 가지 분석 또는 변환을 수행한다. pass마다 담당하는 변환이 하나씩 정해져 있다.
| pass | 담당하는 한 가지 |
|---|---|
| mem2reg | 지역 변수의 메모리 왕복(alloca, store, load)을 값 전달로 바꾼다 |
| instcombine | 명령 조합을 같은 결과의 더 짧은 조합으로 바꾼다 |
| simplifycfg | 도달할 수 없는 블록18을 지우고 분기를 단순화한다 |
| dce | 결과에 영향을 주지 않는 명령을 지운다 (dead code elimination) |
| licm | 반복문 안에서 반복마다 값이 같은 계산을 반복문 앞으로 옮긴다 (loop invariant code motion) |
pass를 실행하는 방법은 두 가지로 나뉜다. opt를 쓰면 원하는 pass를 낱개로 골라 실행할 수 있고, clang의 -O1 -O2 -O3 옵션을 쓰면 미리 정해둔 pass 목록이 순서대로 실행된다. 그리고 세 옵션의 목록은 서로 포함 관계에 있다.19
레벨을 올리는 대가는 컴파일 시간이고, -O3의 추가분은 코드 크기를 늘려서라도 속도를 우선하는 pass들이라 배포 빌드는 보통 -O2에서 멈춘다.
목록의 실제 내용은 다음 명령이 출력한다. 위 표의 pass들이 전부 이 목록 안에 들어 있다.
opt -passes='default<O1>' -print-pipeline-passes Test.ll -S -o /dev/null
최적화를 diff로 관찰하기
읽을 수 있는 IR의 장점은 최적화 전후를 비교할 때 나온다.
clang -O1 -emit-llvm -S Test.c -o Test_O1.ll
-O0(기본값)로 뽑은 Test.ll(좌측)과 -O1로 뽑은 Test_O1.ll(우측)을 VS Code의 diff 편집기20로 비교하면 다음과 같다.
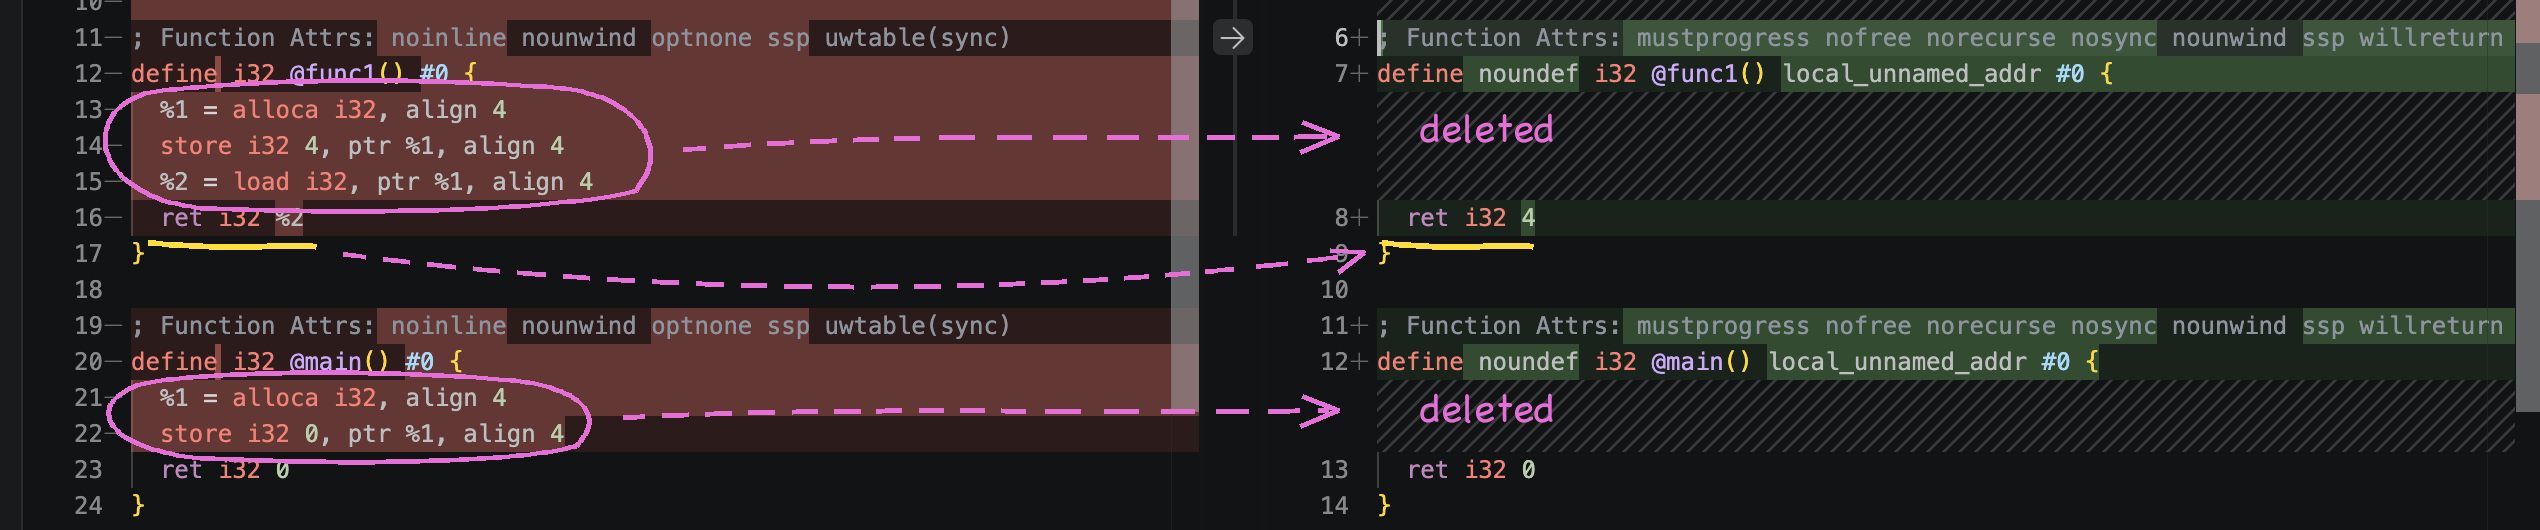
func1의 본문이 어떻게 바뀌었는지 줄 단위로 대응시키면 다음과 같다.
왼쪽 -O0 (최적화 전) | 오른쪽 -O1 (최적화 후) | 변화 |
|---|---|---|
%1 = alloca i32 | 없음 | 변수 a가 쓸 스택 자리가 삭제됨 |
store i32 4, ptr %1 | 없음 | 4를 메모리에 쓰는 명령이 삭제됨 |
%2 = load i32, ptr %1 | 없음 | 메모리에서 도로 읽는 명령이 삭제됨 |
ret i32 %2 | ret i32 4 | 변수에서 읽은 값 대신 상수 4를 바로 반환 |
최적화 pass가 이 함수는 4를 메모리에 넣었다가 곧바로 꺼내 반환하므로 답이 항상 4라는 것을 증명하고 변수의 존재 자체를 지웠다. C 코드는 그대로인데 프로그램이 네 줄에서 한 줄이 됐고, 그 과정이 텍스트 diff로 남는다.
optnone
optnone은 -O0로 IR을 뽑을 때 clang이 모든 함수의 attributes12에 붙이는 최적화 금지 표식이다. pass를 실험할 때 이 표식이 다음과 같이 드러난다.
앞 절의 mem2reg를 opt로 단독 적용해 본다.
opt -passes=mem2reg Test.ll -S -o Test_m2r.ll
그런데 출력이 입력과 똑같이 나온다. opt가 함수를 처리하기 전에 attributes를 읽고, optnone이 보이면 그 함수를 건너뛰기 때문이다. attributes가 pass의 실행 여부까지 제어하는 것이다.
표식 없이 뽑으면 정상 동작한다.21
clang -Xclang -disable-O0-optnone -emit-llvm -S Test.c -o Test_noopt.ll
opt -passes=mem2reg Test_noopt.ll -S
func1이 ret i32 4 한 줄로 접힌다. IR로 pass 실험을 할 때는 이 옵션으로 뽑는다.
참고
- LLVM for Grad Students: What is LLVM? / The Pieces / Understanding LLVM IR 세 챕터.
- LLVM Language Reference: IR 문법의 공식 정의.
- The Architecture of Open Source Applications: LLVM: Chris Lattner가 쓴 LLVM 설계 배경.
CPython은 파이썬의 표준 인터프리터, Java JVM은 자바 실행기, V8은 크롬 브라우저의 자바스크립트 실행기, GCC는 clang과 같은 역할의 또 다른 C/C++ 컴파일러다. ↩︎
파이썬 함수를 실행 중에 기계어로 컴파일하는 JIT 라이브러리. ↩︎
JIT가 초반 호출에서 번역 비용을 지불하느라 느린 구간을 부르는 말. ↩︎
LLVM은 Low Level Virtual Machine의 약자로 출발했지만, 프로젝트가 가상 머신과 무관해진 지금은 약자가 아닌 이름 그 자체로 쓰인다. ↩︎
기계어 대신 중간 코드를 받아 실행해 주는 프로그램. 자바의 JVM이 대표다. ↩︎
Parallel Thread Execution의 약자. ↩︎
소스 코드 문자를 문법 규칙에 따라 분해해 구조(트리)로 만드는 일. ↩︎
스택은 함수의 지역 데이터가 쌓이는 메모리 영역이다. 함수에 들어갈 때 늘어나고 반환할 때 줄어든다. ↩︎
align 4는 그 주소를 4바이트 배수에 맞추라는 정렬 지시다. ↩︎
레지스터는 CPU 내부의 고속 저장 칸으로 개수가 정해져 있다. 가상 레지스터는 IR이 제한 없이 만들어 쓰는 이름표이고, 백엔드가 실물 레지스터에 배정한다. ↩︎
target triple은 IR 파일 첫머리에 적힌 대상 명세로, 이름 그대로 세 조각(CPU-제조사-운영체제)으로 구성된다. 예:
arm64-apple-macosx15.0.0. ↩︎ ↩︎attributes는 함수에 적용되는 속성들을 모아 둔 목록이다. IR 파일 아래쪽의
attributes #0 = {...}줄이 그것이고, 함수 정의의#0이 이 묶음을 가리킨다. ↩︎ ↩︎옛 LLVM(14 이전)은
ptr대신i32*로 타입까지 표기했다. LLVM 15부터 opaque pointer(가리키는 대상의 타입을 적지 않는 포인터 표기)로 통일됐고, 문법 세대가 다를 뿐 뜻은 같다. ↩︎어셈블리는 CPU 명령을 사람이 읽을 수 있는 글자로 적은 표기법이다. 기계어 비트와의 관계는 다음 절에서 다룬다. ↩︎
표의 sp는 스택의 현재 꼭대기 주소를 담는 레지스터(스택 포인터)이고, w8과 w0는 ARM의 범용 레지스터이며 w0는 반환값 전달에 쓰인다. ↩︎
지시자는 어셈블러에게 주는 지시문으로, CPU 명령이 아니다. ↩︎
라벨은 코드 위치에 붙인 이름이다. 분기와 호출이 이 이름으로 위치를 가리킨다. ↩︎
블록(basic block)은 분기 없이 위에서 아래로만 실행되는 명령 묶음이다. ↩︎
괄호 안은 LLVM 22의 목록 출력을 센 pass 수이며, 버전에 따라 달라진다. ↩︎
두 파일의 차이를 좌우로 나란히 표시하는 화면. 삭제된 줄은 왼쪽에 빨간색, 추가된 줄은 오른쪽에 초록색으로 표시된다. ↩︎
명령의 -Xclang은 clang이 뒤따르는 옵션을 내부 프론트엔드에 그대로 전달하게 하는 스위치이고, -disable-O0-optnone이 표식을 붙이지 말라는 옵션이다. ↩︎