안녕하세요~ㅎㅎ
반복문은 바쁘게 돌고 있는데, 그 안에서 매번 똑같은 값을 계산하고 있다면 조금 아깝겠죠? 오늘은 이런 계산을 반복문 밖으로 옮겨주는 LLVM 최적화 pass, LICM(loop-invariant code motion)을 알아보려고 해요!
반복문이 도는 동안 결과가 달라지지 않는 명령을 반복 불변 명령이라고 해요. 한 번 계산해 두면 될 것 같지만, LLVM은 옮긴 뒤에도 프로그램의 동작이 같다는 걸 확인해야 움직여준답니다. 생각보다 꼼꼼하죠~^^
그중 반복문 앞쪽으로 명령을 옮기는 변환이 hoisting(호이스팅)이에요. 아래 transform에서는 factor를 만드는 곱셈과 덧셈이 그 대상인데요. 실제로 어느 줄이 움직이는지 같이 볼게요!
반복마다 같은 계산
이 함수는 input에서 읽은 값에 factor를 곱해서 output에 써요. 두 배열에는 각각 count개의 unsigned 원소가 있고, 여기서는 count를 0 이상으로 둘게요. 반복문이 실행되면 i는 0부터 count - 1까지 움직여요.
배열을 따라가는 i와, 함수 인자로 받은 scale, offset을 비교하면서 보시면 좋겠어요~
// licm.c
void transform(const unsigned *input, unsigned *output,
               int count, unsigned scale, unsigned offset) {
  for (int i = 0; i < count; ++i) {
    unsigned factor = scale * scale + offset;
    output[i] = input[i] * factor;
  }
}
i는 매번 증가하지만 scale과 offset은 그대로죠? 그래서 두 값을 입력, 즉 operand로 받는 scale * scale과 그 결과에 offset을 더하는 계산도 매번 같아요.
그런데 최적화 전 IR에서는 factor 계산이 반복문 본문인 for.body에 들어 있답니다. 값은 그대로인데 계산만 또 하는 셈이네요ㅎㅎ
반면 input[i]와 output[i]의 주소는 i를 따라 바뀌어요. 이쪽은 다음 원소를 처리해야 하니 반복문 안에 남을 일이 있는 거고요. 이제 IR을 준비해서 factor를 구하는 두 명령만 어떻게 달라지는지 확인해볼게요.
LICM 직전의 IR
이제 IR에서 정말 같은 계산을 반복하고 있는지 살펴볼게요~
먼저 clang으로 C를 LLVM IR로 바꾸고, opt로 준비 pass를 실행할 거예요. clang은 C를 받는 프론트엔드, opt는 IR에 pass를 실행하는 도구랍니다. 두 도구 모두 Homebrew LLVM 22.1.81을 사용하고, 아래 명령의 LLVM_BIN에는 그 LLVM 실행 파일들이 든 디렉터리 경로를 넣었어요.
옵션이 조금 붙어 있는데요~ -fno-discard-value-names로 C 식별자를 IR 이름에 남기고, -Xclang으로 바로 뒤의 옵션을 clang 내부 프론트엔드에 전달해요. 그렇게 전달하는 -disable-O0-optnone은 optnone을 붙이지 않게 해준답니다. 나중에 최적화를 해볼 참이니 여기서 막혀 있으면 곤란하겠죠?ㅎㅎ
IR을 읽을 때는 값이 어디서 오는지, 실행이 어디로 이어지는지를 함께 보시면 돼요. LLVM IR의 지역 이름은 SSA(static single assignment) 형식을 따라서 가상 레지스터 하나를 한 번만 정의하거든요. 여러 제어 흐름이 합쳐지는 곳에서는 phi가 어느 이전 basic block의 값을 받을지 골라줘요. basic block은 중간에 분기하지 않고 위에서 아래로 실행되는 IR 명령 묶음이고요.
반복문 바깥에서 안으로 들어갈 때 가장 먼저 거치는 basic block이 header예요. 그 바깥에서 header로만 이어지는 단일 진입 basic block을 preheader라고 부른답니다. 계산을 앞으로 꺼내놓을 자리가 바로 여기예요~
반복문 안에서 header로 돌아오는 제어 흐름은 backedge, 그 backedge가 출발하는 basic block은 latch예요. 반복문을 다 빠져나온 뒤 도착하는 곳은 exit block이고요. 들어갔다가, 돌아갔다가, 빠져나오기까지… 이름이 제법 있네요ㅎㅎ 아래 IR의 block들과 함께 보면 어디를 말하는지 확인할 수 있어요.
LICM을 실행하기 전에는 mem2reg, loop-simplify, lcssa로 IR을 준비할게요. 각 pass가 맡은 일은 이렇답니다.
| pass | 역할 |
|---|---|
mem2reg | alloca로 만든 지역 변수 중 승격 가능한 대상을 SSA 값 흐름으로 바꿈 |
loop-simplify | preheader, 하나의 backedge, 반복문 안에서만 들어오는 전용 exit block들을 갖춘 Loop Simplify Form을 보장 |
lcssa(loop-closed SSA) | 반복문 안에서 정의하고 밖에서 쓰는 값이 exit block의 phi를 거치게 함 |
loop pass는 반복문을 하나씩 처리해요. LLVM이 loop pass 앞에서 loop-simplify와 lcssa를 자동으로 실행해주기도 하는데요. 여기서는 세 준비 pass를 먼저 실행해서 before.ll로 저장해둘 거예요. clang이 만든 원래 IR은 raw.ll에 두고요.
이렇게 해두면 before.ll을 읽기도 편하고, 나중에 비교할 때 LICM이 바꾼 부분만 남길 수 있답니다. 무엇 때문에 달라졌는지는 알고 봐야겠죠~^^
LLVM_BIN=/opt/homebrew/opt/llvm/bin

"$LLVM_BIN/clang" -O0 -Xclang -disable-O0-optnone \
  -fno-discard-value-names \
  -S -emit-llvm licm.c -o raw.ll

"$LLVM_BIN/opt" -S \
  -passes='mem2reg,loop-simplify,lcssa' \
  raw.ll -o before.ll
참, 이 transform에는 반복문 안에서 정의한 값을 반복문 밖에서 쓰는 경우가 없어요. 그래서 lcssa가 before.ll에 새 phi를 추가하지는 않는답니다. 준비 pass를 돌렸다고 꼭 무언가 더 생기는 건 아니네요ㅎㅎ
이제 before.ll의 transform을 볼게요. 파일 수준 설정, 매개변수와 함수의 attributes, metadata는 덜어냈어요.
이 파일의 target triple은 arm64-apple-macosx15.0.0이에요. 이 환경에서 pointer는 64비트이고, int와 unsigned는 32비트랍니다.
define void @transform(ptr %input, ptr %output,
                       i32 %count, i32 %scale, i32 %offset) {
entry:
  br label %for.cond

for.cond:
  %i.0 = phi i32 [ 0, %entry ], [ %inc, %for.inc ]
  %cmp = icmp slt i32 %i.0, %count
  br i1 %cmp, label %for.body, label %for.end

for.body:
  %mul = mul i32 %scale, %scale
  %add = add i32 %mul, %offset
  %idxprom = sext i32 %i.0 to i64
  %arrayidx = getelementptr inbounds i32, ptr %input, i64 %idxprom
  %0 = load i32, ptr %arrayidx, align 4
  %mul1 = mul i32 %0, %add
  %idxprom2 = sext i32 %i.0 to i64
  %arrayidx3 = getelementptr inbounds i32, ptr %output, i64 %idxprom2
  store i32 %mul1, ptr %arrayidx3, align 4
  br label %for.inc

for.inc:
  %inc = add nsw i32 %i.0, 1
  br label %for.cond

for.end:
  ret void
}
앞에서 말한 header와 preheader가 어디 있는지 보이시나요~? 이 함수의 다섯 basic block에 하나씩 짝을 지어보면 이렇게 돼요.
| basic block | 역할 |
|---|---|
entry | 함수 시작점이자 preheader. 반복문 바깥에서 for.cond로 들어가는 유일한 block |
for.cond | header. i < count를 검사하고 for.body 또는 for.end로 분기 |
for.body | 배열 원소를 읽고 factor를 곱한 뒤 결과를 씀 |
for.inc | latch. i를 증가시키고 backedge로 for.cond에 돌아감 |
for.end | 반복문을 빠져나온 뒤 도착하는 exit block |
각 명령이 C 코드의 어느 부분에 해당하는지도 같이 적어둘게요. 비교할 때는 factor를 만드는 %mul, %add가 지금 for.body에 있다는 점을 기억해주세요~
| IR | 뜻 |
|---|---|
ptr, i1, i32, i64 | 각각 pointer, 1비트 정수, 32비트 정수, 64비트 정수 타입 |
br label, br i1 | 다른 basic block으로 무조건 분기하거나 i1 조건에 따라 분기 |
%i.0 = phi ... | 첫 반복에는 0, 이후 반복에는 %inc를 i로 선택 |
%cmp = icmp slt ... | signed less-than 비교로 i < count를 계산 |
%mul, %add, %mul1 | 각각 scale * scale, %mul + offset, input[i] * factor를 계산 |
%idxprom, %idxprom2 | 각각 input과 output의 주소에 쓸 i를 sext로 i32에서 i64로 부호 확장 |
%arrayidx, %arrayidx3 | getelementptr inbounds로 각각 input[i]와 output[i]의 주소를 계산. inbounds는 주소가 같은 할당 객체의 허용 범위 안에 있다는 약속 |
%0 = load, store, align 4 | %arrayidx에서 input[i]를 읽어 %0에 정의하고 %arrayidx3에 %mul1을 씀. 32비트 unsigned의 주소가 4바이트 경계에 맞는다고 표시 |
%inc = add nsw ... | i + 1을 계산. nsw는 signed overflow가 없다는 약속이며 0 이상인 count와 i < count가 이 조건을 보장 |
LICM 실행
준비가 끝났으니 -passes='licm'으로 LICM을 실행해볼게요! LLVM 22에서는 패스 매니저가 필요한 Loop Simplify Form, LCSSA, MemorySSA2도 준비해줘요.
MemorySSA는 메모리 사용과 정의의 연결, 즉 use-def 관계를 기록한 분석 결과예요. 어떤 쓰기가 읽을 값을 바꿀 수 있는지 살필 때 쓰는데요. 뒤에서 load를 옮기는 이야기를 할 때 다시 등장한답니다~
결과를 after.ll에 저장하고, diff -u로 before.ll과 비교해요. -I '^; ModuleID'는 입력 파일 이름만 담긴 주석을 비교에서 빼는 옵션이에요. 파일 이름이 달라진 것까지 세면 괜히 한 줄 더 바뀐 것처럼 보이겠죠ㅎㅎ
"$LLVM_BIN/opt" -S \
  -passes='licm' \
  before.ll -o after.ll

diff -u -I '^; ModuleID' before.ll after.ll
함수 본문에서 달라진 건 아래 네 줄이에요. -로 표시된 두 줄이 빠지고, 같은 명령 두 줄이 + 위치에 들어갔네요!
 entry:
+  %mul = mul i32 %scale, %scale
+  %add = add i32 %mul, %offset
   br label %for.cond

 for.body:
-  %mul = mul i32 %scale, %scale
-  %add = add i32 %mul, %offset
   %idxprom = sext i32 %i.0 to i64
%mul과 %add가 for.body에서 entry로 올라갔죠? 이제 같은 곱셈과 덧셈을 매번 할 필요가 없어졌어요~^^
여기서 for.body로 가려면 반드시 entry를 지나야 해요. 이렇게 한 블록에 도착하는 모든 경로가 다른 블록을 거치는 관계를 dominance(지배 관계)라고 해요. 이 예제에서는 entry가 for.body를 지배하는 거죠.
덕분에 %mul1이 %add를 쓰기 전에, entry에서 그 값이 먼저 계산돼요. 밖으로 옮겨놓고 정작 쓸 때 값이 없으면 곤란하겠죠? 이 순서도 맞아야 한답니다ㅎㅎ
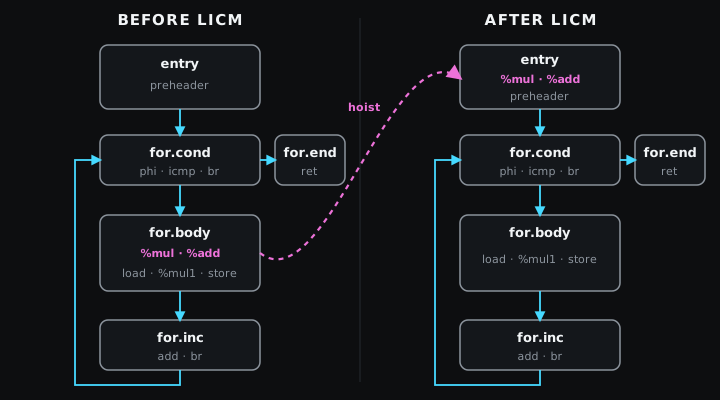
그런데 하나 더 볼 게 있어요. count가 0이면 for.body는 아예 실행되지 않는데, 밖으로 나온 %mul과 %add는 entry에서 한 번 실행돼요.
원래 안 하던 계산을 하게 된 거네요… 괜찮은 걸까요?
이 두 명령은 괜찮아요. 결과의 하위 32비트를 남기는 계산이고, 메모리를 읽거나 쓰지도 않거든요. 어떤 scale, offset이 들어와도 결과가 정의되어 있어서, 계산만 하고 그 값을 쓰지 않아도 문제가 없어요.
이렇게 결과가 필요한지 결정되기 전에 계산하는 걸 speculative execution이라고 해요.
어디서 많이 본 단어 같죠?ㅎㅎ LLM 추론에서 유명한 speculative decoding의 그 speculative이에요. 사실 speculative execution 쪽이 먼저 있었고, speculative decoding이 이 아이디어에서 출발했답니다. 논문 저자들의 설명에서도 이 연결을 직접 짚어줘요.
작은 draft model이 다음 토큰 후보를 먼저 만들고, 큰 model이 그 후보들을 한꺼번에 검증하는 방식이 익숙하실 텐데요. 최종적으로 쓸지 확정되기 전에 일을 미리 해둔다는 생각이 여기에도 이어져요. LLVM 보다가 LLM에서 보던 이름을 만나네요ㅎㅎ
이 LICM 예제에서는 LLVM이 미리 실행해도 안전하다고 증명한 명령을 옮겨요. 토큰 후보를 만들고 나중에 검증하는 절차와는 구분해서 봐주세요. 두 명령을 preheader로 옮길 때 확인할 조건을 모아보면 다음과 같아요.
- 계산에 필요한 모든 operand가 반복 불변이어야 해요.
- 메모리 읽기·쓰기나 함수 호출 등 외부에서 볼 수 있는 동작이 달라지면 안 돼요.
- 원래 건너뛰던 계산까지 실행하게 된다면, 그 실행도 안전해야 해요.
%mul과 %add는 이 조건을 모두 만족해요. 원래도 반드시 실행되던 명령임을 증명해서 옮길 수 있는 경우도 있지만, 지금처럼 실행을 건너뛰는 경로가 있으면 그 경로까지 살펴봐야 한답니다.
계산 결과만 같으면 끝날 줄 알았는데, 생각보다 볼 게 많죠~ㅎㅎ
반복 불변이어도 남는 나눗셈
이번 transform_div는 factor를 numerator / denominator로 구해요. 배열을 읽고 결과를 쓰는 부분은 앞의 예제와 같고, count와 배열에 대한 조건도 그대로예요.
분자와 분모도 반복문 안에서 바뀌지 않으니, 이 나눗셈도 밖으로 나올 것 같죠? 한번 볼게요~
// licm_div.c
void transform_div(const unsigned *input, unsigned *output,
                   int count, unsigned numerator,
                   unsigned denominator) {
  for (int i = 0; i < count; ++i) {
    unsigned factor = numerator / denominator;
    output[i] = input[i] * factor;
  }
}
transform_div에도 mem2reg, loop-simplify, lcssa, licm을 차례로 적용해요. 그런데 이번에는 LICM을 거친 뒤에도 %div가 for.body에 남아 있네요.
아래 udiv가 unsigned 나눗셈이에요. 그 결과를 받는 %div도 그대로 반복문 안에 있고요.
for.body:
  %div = udiv i32 %numerator, %denominator
  ; input[i]를 읽고 %div를 곱한 뒤 output[i]에 쓰는 명령
곱셈은 보내주더니 나눗셈만 남겨뒀네요… 조금 서운할 수도 있겠어요ㅠㅠ
아까 봤던 count == 0을 다시 생각해볼게요. 원래 코드는 for.body에 들어가지 않으니, denominator가 0이어도 나눗셈을 하지 않아요.
그런데 %div를 entry로 옮기면 루프에 들어갈지 확인하기도 전에 나누게 되죠. 원래 없던 0 나누기가 새로 생길 수 있어요.
LLVM IR의 udiv는 0으로 나눌 때 undefined behavior를 만들어요. 계산 결과와 이후 동작을 LLVM이 보장하지 않는 상황이 되는 거예요. 계산을 줄여주려다 이런 일이 생기면 참 난감하겠죠…
두 operand가 반복 불변이어도, 이 나눗셈은 speculative execution이 안전하지 않아서 그대로 남는답니다. 안 옮기는 데는 다 이유가 있었네요ㅎㅎ
메모리를 읽는 load도 주소가 같다는 것만으로는 부족해요. 다른 포인터가 같은 메모리를 가리킬 수도 있는데, 이런 가능성을 alias라고 해요. 루프 안의 store나 함수 호출이 그 자리에 값을 써버리면, 같은 주소에서 읽어도 값은 달라지겠죠?
LLVM은 alias 분석과 MemorySSA로 충돌하는 쓰기가 있는지 찾아요. 루프가 한 번도 실행되지 않을 때도 그 주소를 미리 읽어도 되는지는 따로 확인하고요. 앞에서 준비했던 MemorySSA가 여기서 쓰이는 거랍니다~
volatile 접근은 생략하거나 합치면 안 되는 메모리 접근이에요. 실행 횟수 자체가 의미가 있으니 매번 하던 접근을 밖으로 꺼내 한 번으로 줄일 수 없어요. 일반 함수 호출도 호출의 의미와 attributes, 분석 결과를 보고 메모리 효과나 다른 부작용이 이동을 허용하는지부터 확인해야 하고요.
값이 같다는 것과, 먼저 실행해도 된다는 건 따로 확인해야겠죠~^^
오늘은 두 줄을 옮기는 데도 이것저것 살펴볼 게 많았네요ㅎㅎ 아래에는 설명에 참고한 문서들을 남겨둘게요. 그럼 다음 글에서 만나요~♡
참고
- LLVM’s Analysis and Transform Passes: LICM: LICM의 동작과 메모리 명령 이동 조건.
- LLVM Loop Terminology: header, preheader, latch, exit과 Loop Simplify Form의 정의.
- Using the New Pass Manager:
opt -passes문법과 자동으로 선택되는 pass 실행 범위. - MemorySSA: 메모리 use-def 관계와 alias 분석을 이용한 충돌 판정.
- LLVM Language Reference:
udiv: unsigned 나눗셈과 0으로 나누는 경우의 의미. - LLVM 22.1.0 LICM implementation: 실제 hoisting 안전성 검사와 MemorySSA 사용.
- 스티커: LINE의 Moon 캐릭터. Moon & James, LINE Characters in Love!.
명령과 IR은
/opt/homebrew/opt/llvm/bin의 Homebrew LLVM 22.1.8 기준이에요. 다른 LLVM 버전에서는 IR 표기와 pass 실행 구조가 조금 달라질 수 있어요. ↩︎LLVM 22.1.8에서
-passes='licm' -print-pipeline-passes는function(loop-mssa(licm<allowspeculation>)),verify를 출력해요.loop-mssa는 LICM에 MemorySSA를 제공하고,function(...)은 모듈(한 IR 파일)의 각 함수에 반복문 pass를 적용해요.allowspeculation은 안전성 검사를 통과한 명령의 speculative execution을 허용하는 LICM 설정이고,verify는 변환 뒤 IR의 구조를 검사한답니다. ↩︎