기준 자료: MIT 6.5930/1 Spring 2026, L01 - Introduction and Applications
첫 강의라서 가벼운 수업 소개 정도일 줄 알았는데, GPU와 TPU를 지나 CPU pipeline, TeAAL, Roofline까지 한 번에 간다. 사례는 계속 바뀌지만 질문은 하나다.
딥러닝 연산을 왜 그냥 CPU나 GPU에 맡기지 않고, 별도 하드웨어까지 만들어가며 다루는가?
L01의 답을 먼저 쓰면 이렇다. 연산량은 너무 빨리 커졌고, 이제 연산 자체보다 데이터를 먹여 살리는 비용이 더 크다. 범용 프로세서가 유연성을 위해 들고 있는 복잡한 제어 로직도 DNN의 규칙적인 tensor 연산에는 꽤 비싼 짐이다.
Compute and Deep Learning
강의는 Ilya Sutskever가 2017년 ACM 튜링상 50주년 행사에서 한 말로 시작한다.
Compute has been the oxygen of deep learning.
Big Data, GPU acceleration, 새로운 ML 기법. 흔히 지금의 AI를 만든 세 재료라고 묶는 것들이다.
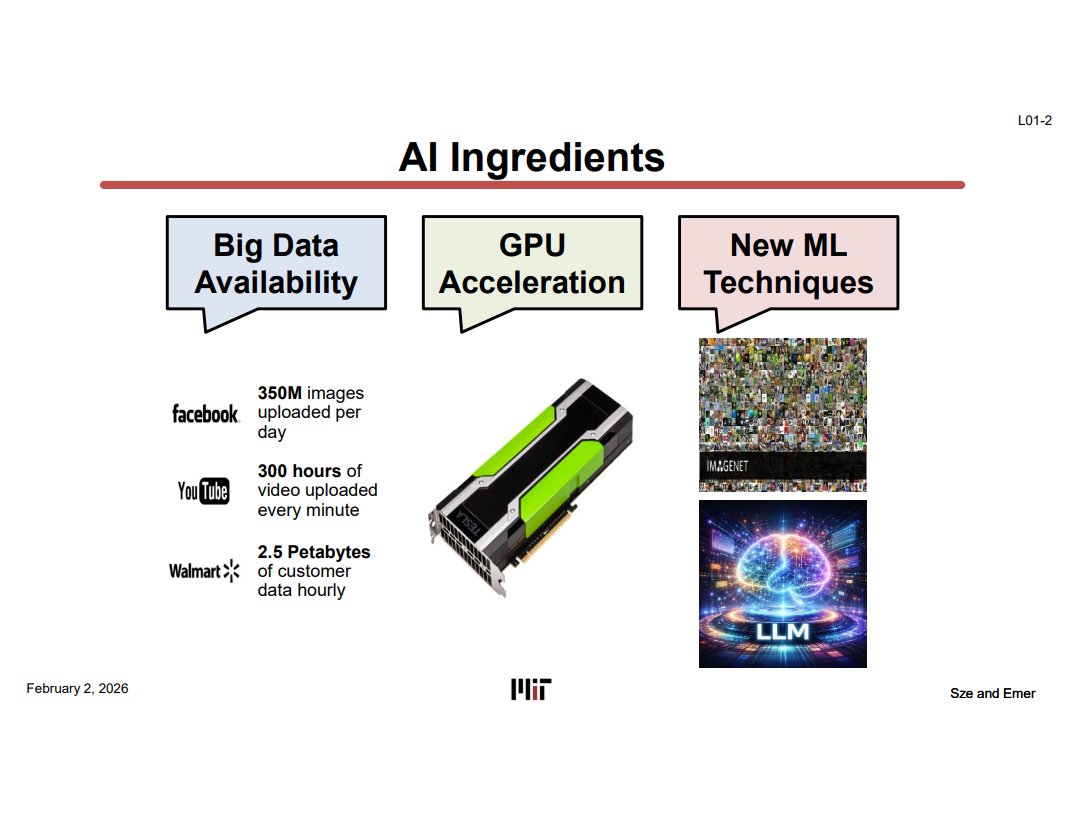
데이터가 쌓였고, AlexNet과 Transformer 같은 모델이 나왔고, 그 계산을 현실적인 시간 안에 끝낼 GPU가 있었다. 셋 중 하나만 빠져도 지금 규모의 모델은 안 나왔을 것이다. 6.5930은 그중 compute를 열어보는 수업이다. 정확히는, FLOP 숫자만 보는 게 아니라 그 FLOP이 실제 칩에서 어떻게 실행되고 어디서 막히는지를 본다.
GPU가 변해온 방향도 꽤 노골적이다.
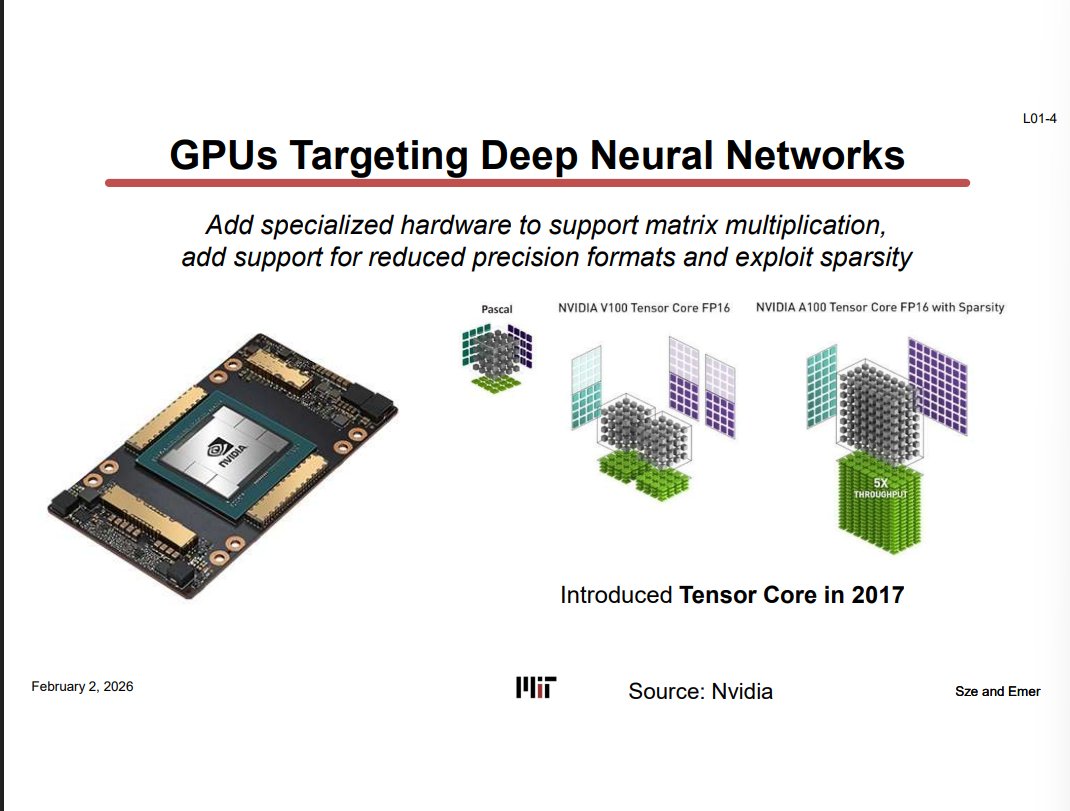
Pascal까지는 행렬곱도 주로 범용 CUDA core가 맡았다. Volta V100부터는 작은 행렬의 multiply-accumulate를 통째로 처리하는 Tensor Core가 들어왔다. Ampere A100에서는 여기에 2:4 structured sparsity 지원까지 붙었다. 네 원소 중 두 개가 0인 패턴을 맞추면 유효한 값만 계산한다.
여기서 sparse = fast로 읽으면 곤란하다. 아무 위치나 0으로 만든 비정형 sparsity는 하드웨어가 바로 건너뛸 수 없다. pruning 결과가 2:4라는 계약을 지켜야 Tensor Core의 sparse path를 탄다. 모델 구조와 하드웨어가 서로의 형편을 봐줘야 성능이 나온다는 첫 사례다.
Software Companies Building Hardware
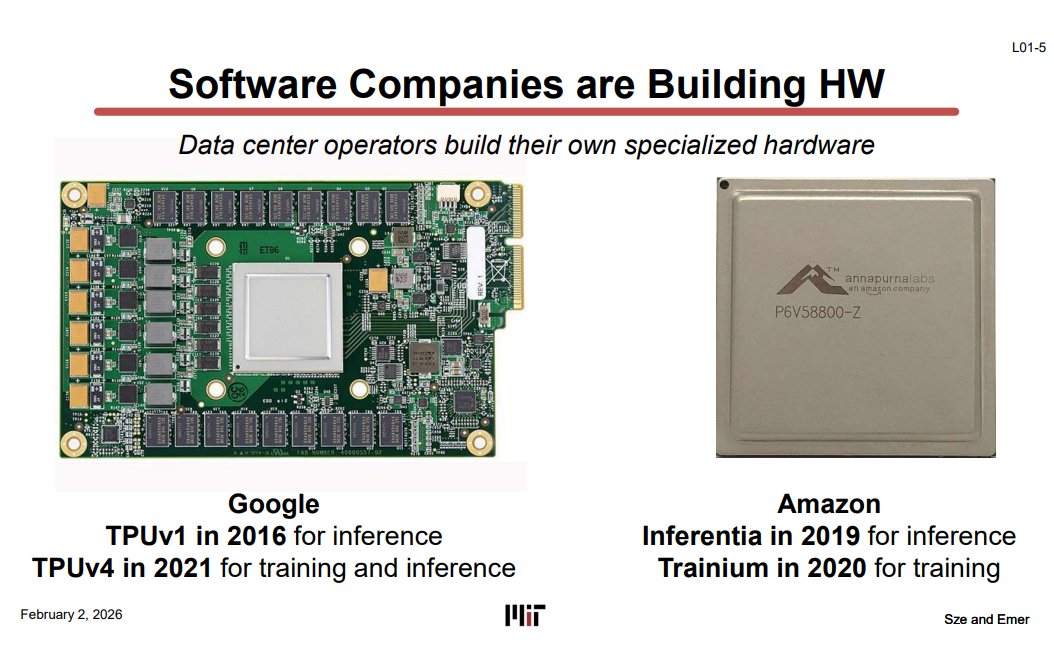
Google과 Amazon은 NVIDIA GPU를 많이 사는 회사이면서, TPU·Inferentia·Trainium도 직접 만든다. 처음 보면 굳이 싶다. GPU는 이미 빠르고 CUDA 생태계도 있는데 왜 칩 설계까지 떠안나.
범용성의 세금 때문이다. GPU는 그래픽, 과학 계산, DNN을 모두 받아야 한다. 반면 데이터센터에서 실제로 돌릴 workload와 서비스 규모를 알고 있다면 필요한 연산, 메모리 용량, 통신 패턴에 맞춰 면적과 전력을 다시 배분할 수 있다. Google TPU v1은 inference용 256×256 systolic array로 시작했고, v2부터 training까지 넓어졌다. AWS도 클라우드 안에서 반복되는 inference와 training의 단가를 낮추려고 각각 Inferentia와 Trainium을 만들었다.
Cerebras WSE는 이 논리를 웨이퍼 끝까지 밀어붙인 물건이다.
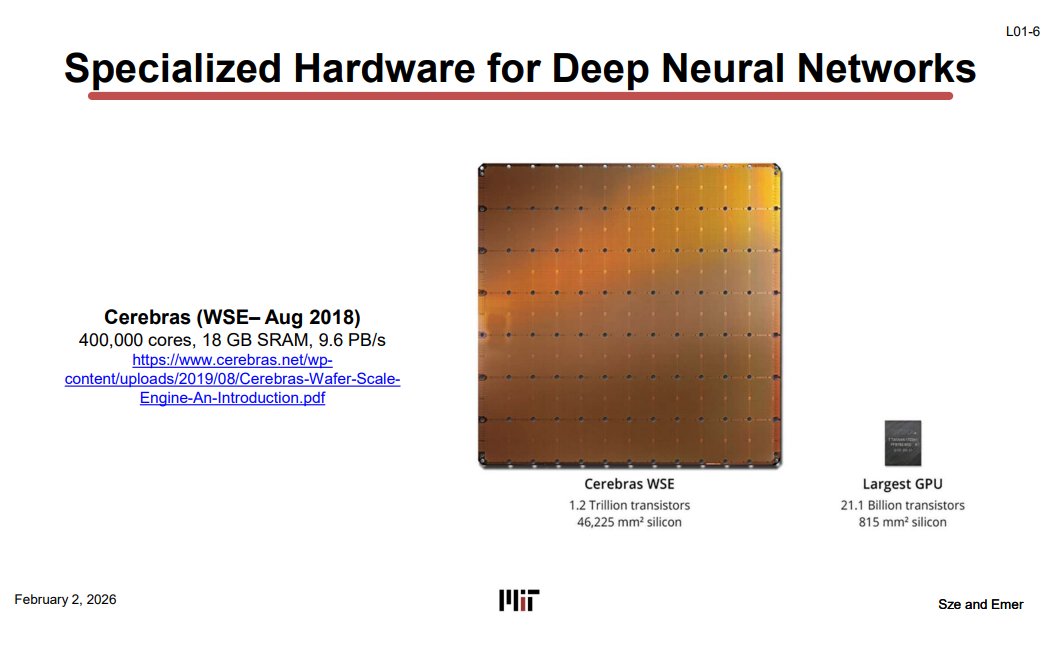
보통은 웨이퍼에서 작은 die를 잘라 패키징한다. WSE는 웨이퍼 한 장을 거의 그대로 칩 하나로 쓴다. 슬라이드에 나온 1세대 WSE의 온칩 SRAM은 18GB다. 수많은 작은 칩을 연결할 때 생기는 off-chip 통신을 줄이고, 모델과 중간값을 가능한 한 가까이 두겠다는 선택이다.
당연히 공짜는 아니다. 결함이 하나만 생겨도 버릴 수 없으니 redundant core와 routing이 필요하고, 전력 공급과 냉각, 패키징도 전부 별도 문제다. WSE를 보편적인 정답으로 볼 필요는 없다. 대신 data movement가 너무 비싸지면 설계자가 어디까지 과격해질 수 있는지는 잘 보여준다.
같은 방향은 폰 안에서도 보인다.
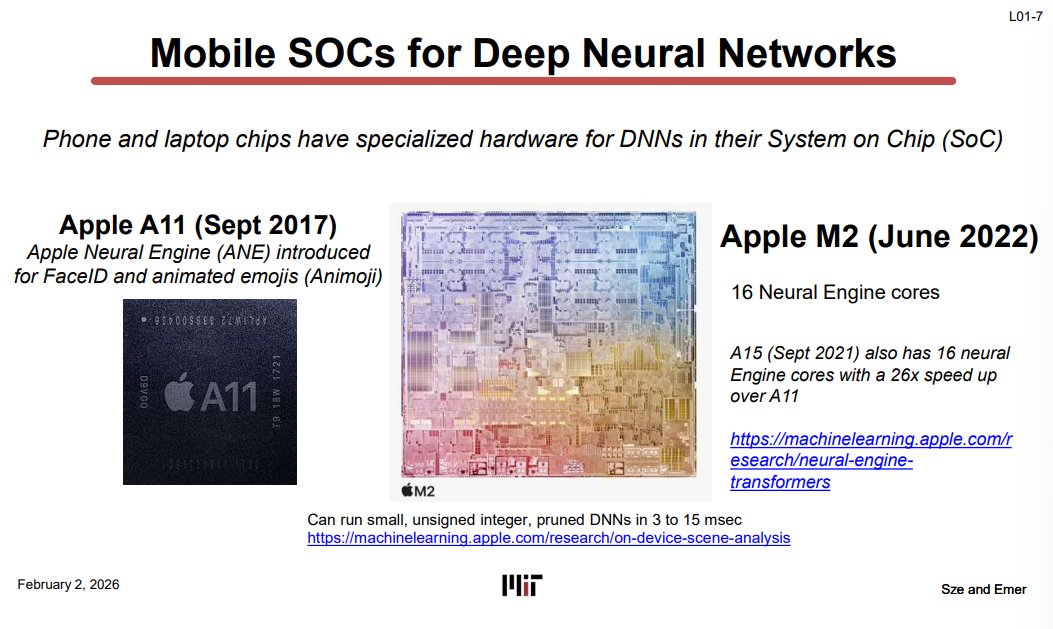
Apple은 A11부터 Neural Engine을 넣었다. Face ID처럼 네트워크 왕복을 기다릴 수 없고, 카메라 데이터를 클라우드로 보내기도 곤란한 기능이 첫 용도였다. 데이터센터 accelerator가 throughput과 TCO를 쫓는다면 모바일 NPU는 작은 전력·메모리 예산 안에서 latency와 privacy를 지켜야 한다. 그래서 quantization이나 pruning이 모바일에서 특히 세게 등장한다.
Data Movement Cost
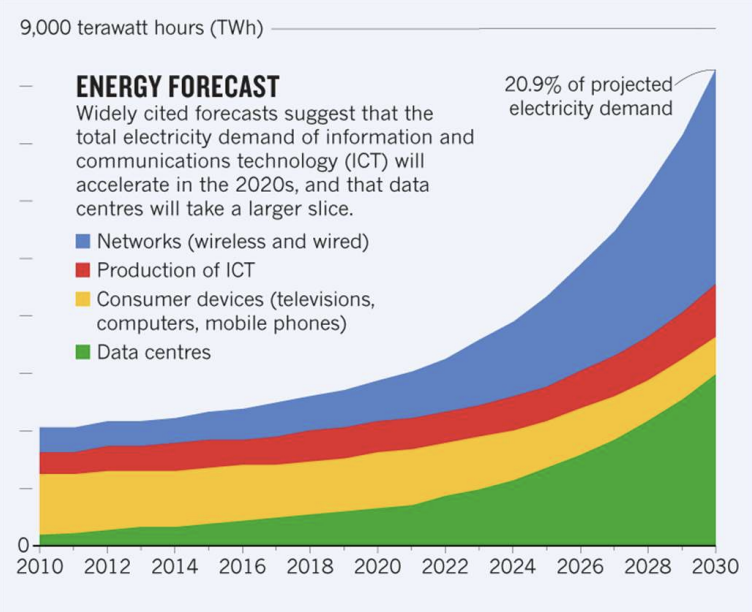
슬라이드는 데이터센터 전력 비중이 빠르게 늘어날 것이라는 여러 전망을 가져온다. 전망치 자체는 조사 시점과 범위에 따라 크게 흔들린다. 여기서 읽어야 할 건 정확히 8%냐 9%냐가 아니다. 모델 크기와 서비스 호출량은 커지는데 전력과 메모리 대역폭은 같은 속도로 따라오지 못한다는 사실이다.
더 직접적인 숫자는 이쪽이다. 강의의 65nm 기준 normalized energy 표에서 ALU 연산을 1로 놓으면, global buffer 접근은 6, DRAM 접근은 200이다. 공정도 다르고 메모리 종류도 달라졌으니 지금 칩에 200이라는 숫자를 그대로 대입하면 안 된다. 그래도 순서는 안 바뀐다.
멀고 큰 메모리일수록 비싸다.
PE 안의 작은 register file, 칩 안의 SRAM, 칩 밖의 DRAM 순서로 갈수록 용량은 커지지만 에너지와 지연도 커진다. accelerator가 PE array만큼이나 memory hierarchy와 dataflow를 중요하게 다루는 이유다. 같은 값을 DRAM에서 열 번 읽는 대신 한 번 가져와 register에서 열 번 쓰면, 연산기는 그대로인데 전체 비용은 크게 달라진다.
Training Cost와 Inference Volume
슬라이드의 GPT-3 예시는 175B 모델 학습에 약 \(3.14 \times 10^{23}\) FLOPs가 필요하고, V100 한 장이면 수백 년이 걸린다는 계산을 보여준다. 뒤이어 GPT-4의 추정 학습비와 DeepSeek가 공개한 최종 training run 비용도 비교한다.
이런 숫자는 범위를 먼저 봐야 한다. GPT-4 쪽은 외부의 총비용 추정이고, DeepSeek 쪽은 최종 학습 런의 GPU 비용에 가깝다. 서로 다른 항목을 그대로 나눠 “몇 배 싸다”고 하면 이야기는 화려해져도 비교는 망가진다. DeepSeek에서 시스템적으로 볼 만한 부분은 MoE다. 전체 671B parameter를 매 token마다 전부 쓰지 않고 일부 expert만 활성화해 실제 계산량을 줄인다.
Training은 한 번이 무겁다. Inference는 한 번은 가벼워도 서비스가 살아 있는 동안 끝없이 반복된다. 챗봇 요청, 추천, 번역, 카메라 처리까지 합치면 누적 inference 비용이 운영비를 결정한다. “학습시킬 수 있는가”와 “돈을 벌면서 서빙할 수 있는가”는 다른 문제다.
On-device Inference
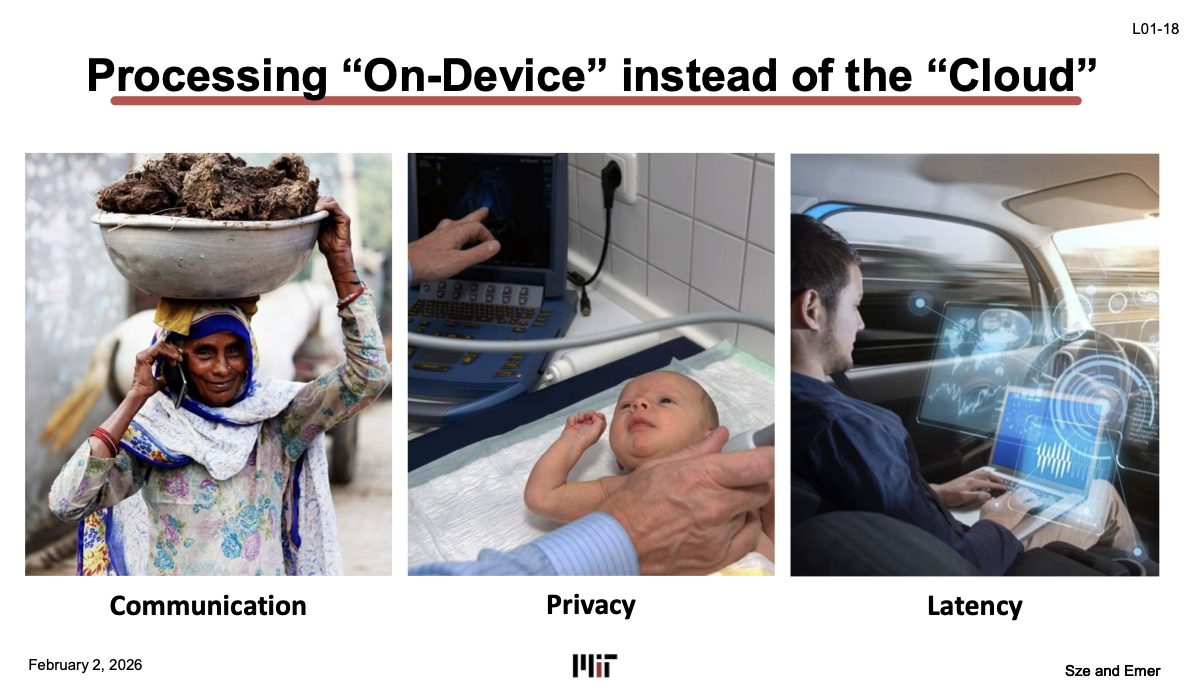
On-device inference에는 통신, privacy, latency라는 세 가지 아주 현실적인 이유가 있다. 네트워크가 끊기면 기능도 같이 멈추는 제품은 만들기 어렵고, 의료·국방 데이터는 애초에 밖으로 보내기 곤란하다. 자율주행은 수십 ms의 왕복 지연조차 안전 문제로 이어진다.
자율주행차의 센서 데이터와 DNN 호출량을 계산한 슬라이드가 재미있다. 차량 한 대만 보면 처리할 수 있어 보이지만, 10개 DNN을 여러 카메라에 60Hz로 돌리고 그 차량이 백만 대가 되면 단위가 금방 조 단위 inference로 바뀐다. 2.5kW짜리 prototype compute box를 그대로 차에 넣는 것도 답이 아니다. 이 문제는 “GPU를 더 꽂자”로 끝나지 않는다.
Moore’s Law와 Dennard Scaling
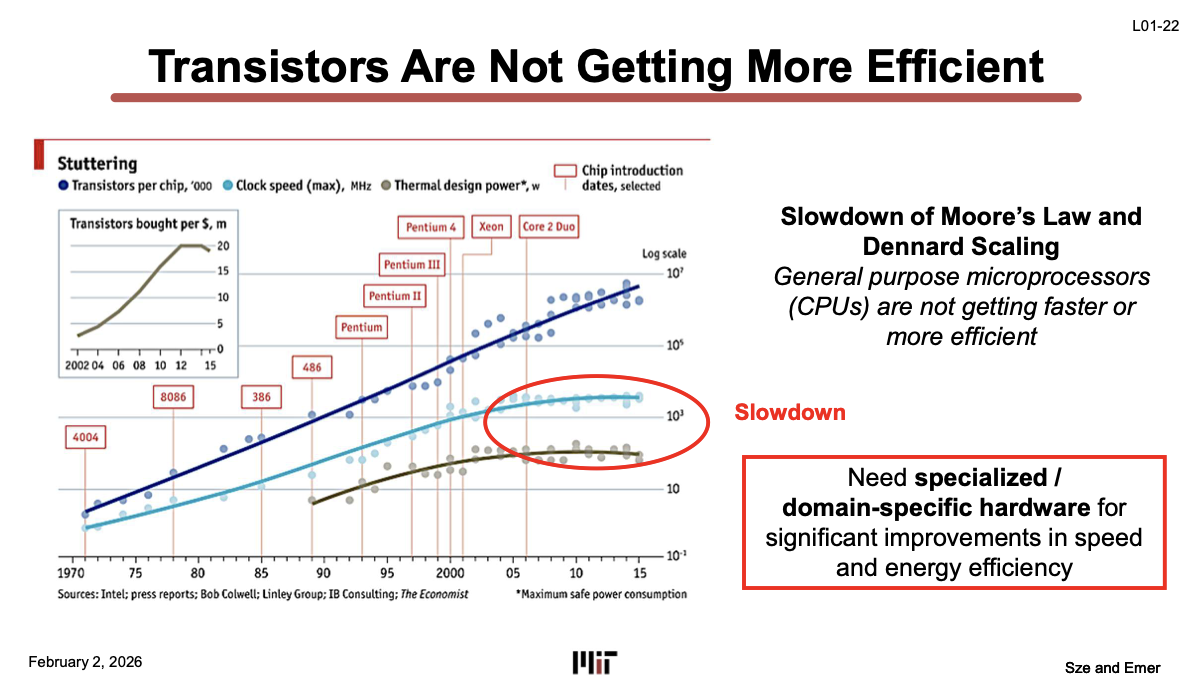
트랜지스터 수는 계속 늘지만, Dennard scaling은 2000년대 중반에 이미 깨졌다. 트랜지스터를 작게 만들 때 전력도 같은 비율로 줄던 시절이 끝나면서 clock은 멈췄고, 칩 전체를 동시에 켤 수도 없게 됐다. 공정 세대만 바꾸면 같은 코드가 저절로 빨라지는 보너스가 줄었다.
그래서 남은 트랜지스터를 어디에 쓸지가 중요해졌다. 범용 CPU는 어떤 코드가 올지 모르기 때문에 branch predictor, out-of-order issue, register renaming, speculative execution, cache coherence 같은 장치를 잔뜩 들고 있다. 이것들은 쓸모없는 장식이 아니다. irregular한 범용 코드에서 execution unit을 놀리지 않으려면 필요하다.
다만 DNN의 대부분은 크고 규칙적인 MAC loop다. 같은 control overhead를 매 instruction마다 지불할 이유가 적다.
CPU Pipeline: In-order, OoO, SMT
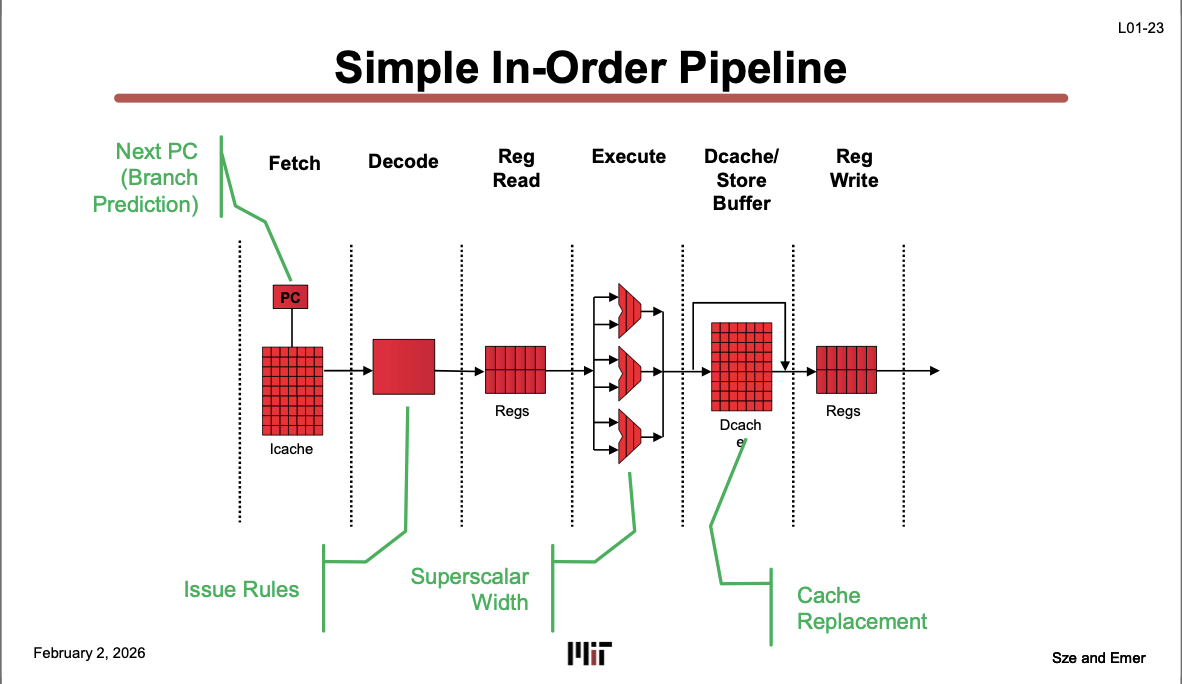
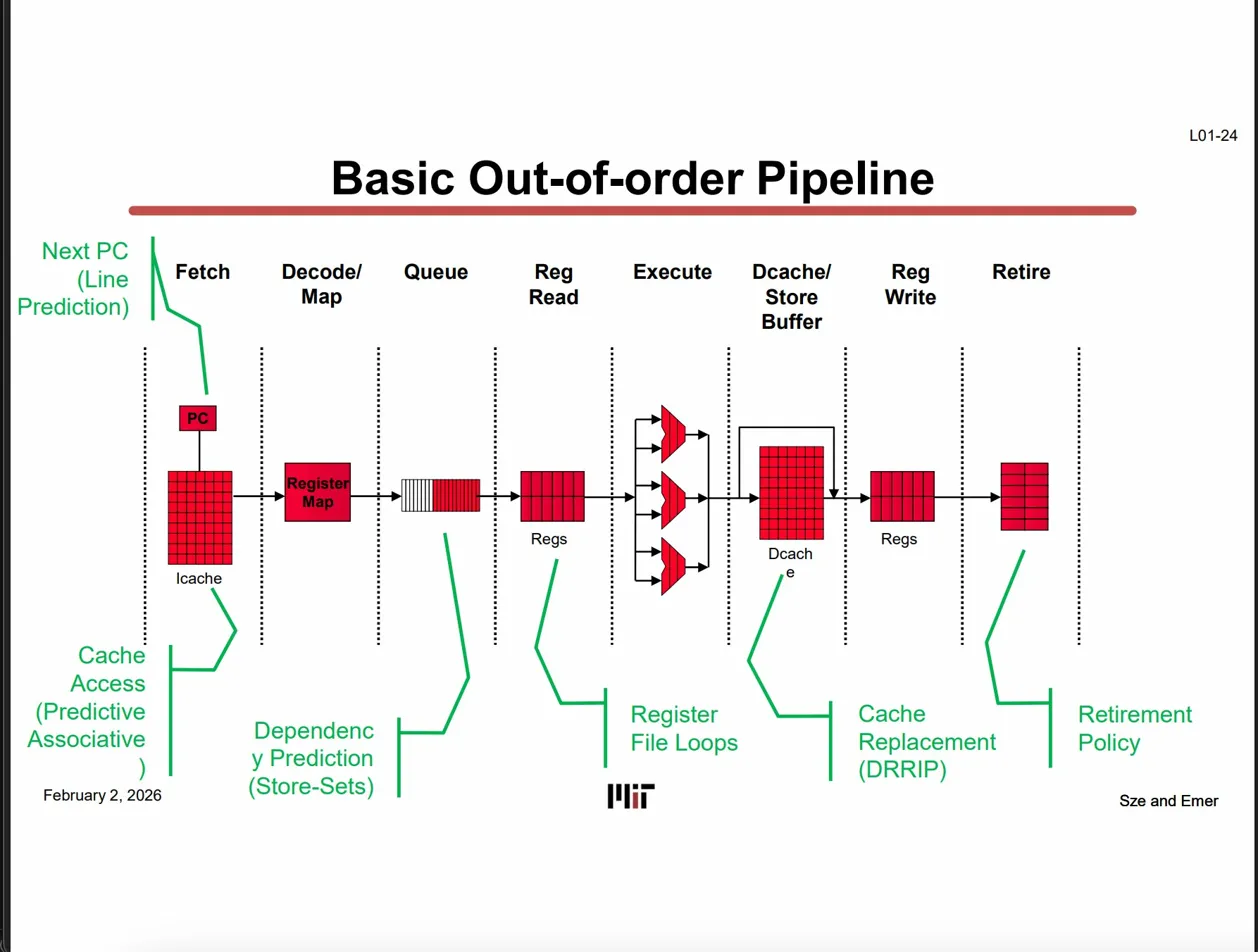
In-order superscalar는 한 cycle에 여러 instruction을 내보낼 수 있어도, 앞선 load가 cache miss에 걸리면 뒤의 독립적인 instruction까지 같이 기다린다. 그래서 out-of-order pipeline은 issue queue에 instruction을 모아두고 operand가 준비된 것부터 실행한다.
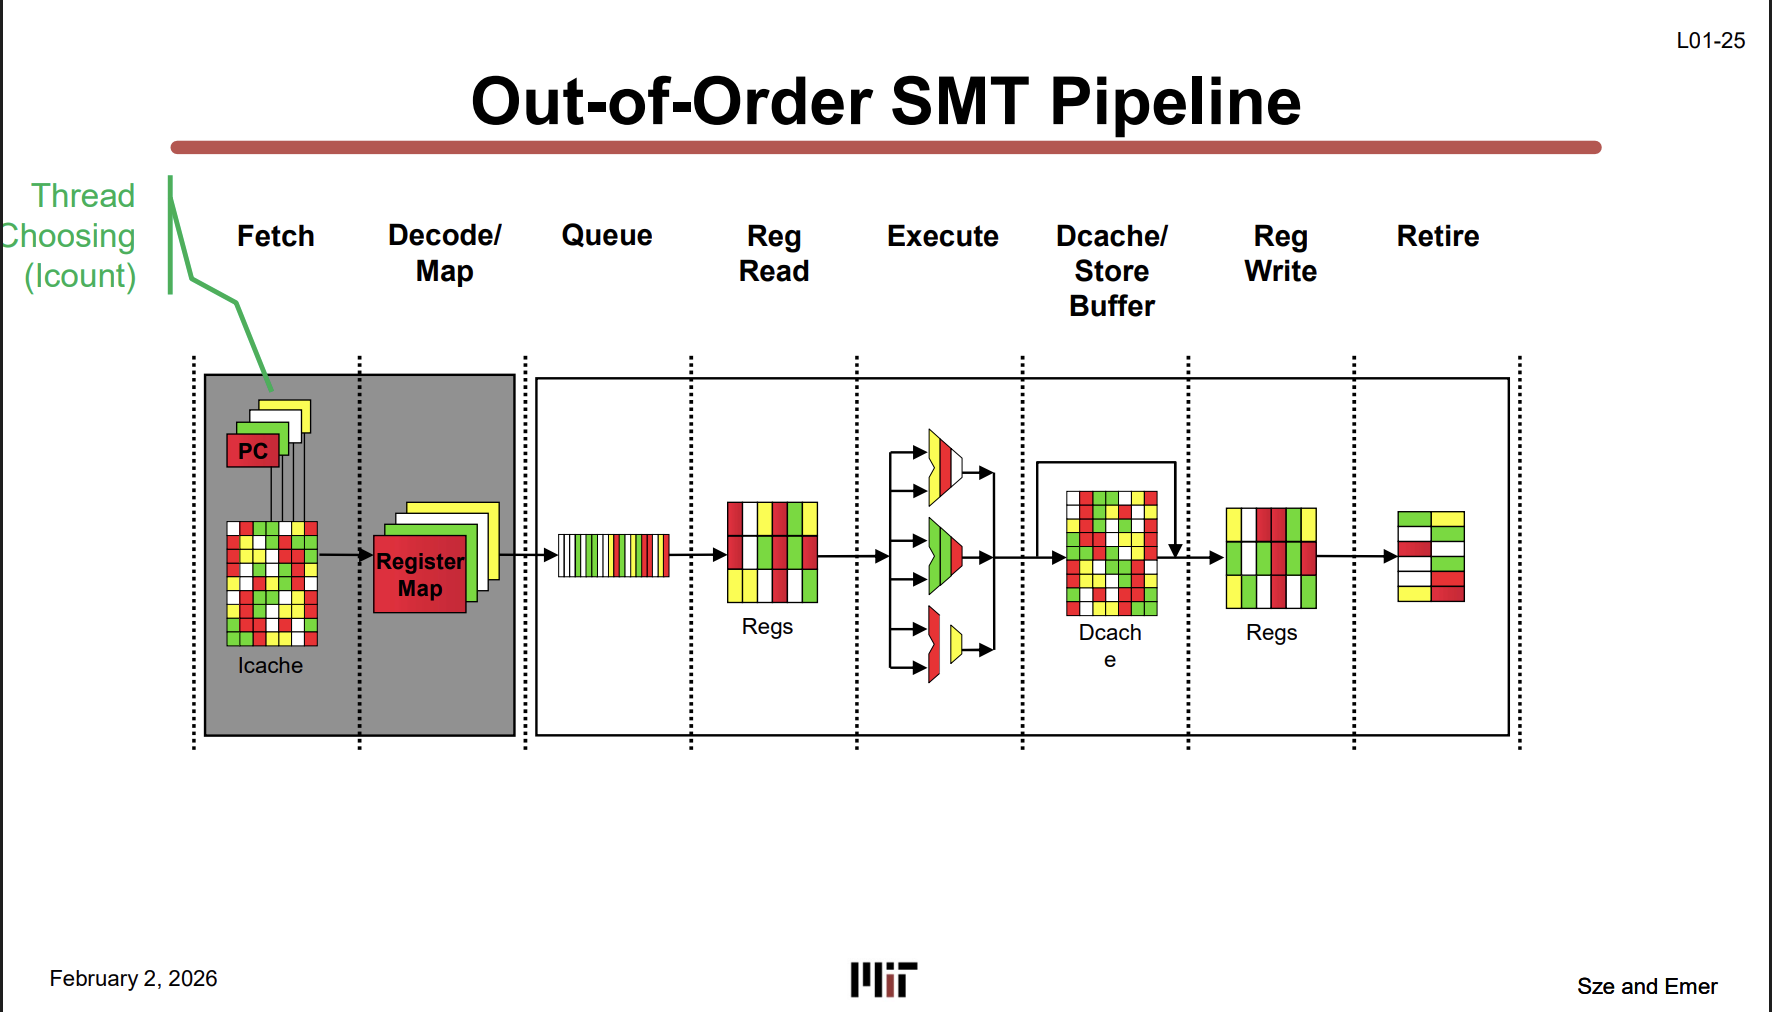
SMT는 한 thread가 막혔을 때 다른 thread의 instruction으로 빈 execution slot을 채운다. Intel의 Hyper-Threading이 이 계열이다. GPU의 SIMT와 이름이 비슷하지만 다른 개념이다. SMT는 여러 독립 thread가 한 CPU pipeline의 자원을 공유하는 것이고, SIMT는 한 instruction으로 여러 lane의 thread를 함께 움직이는 실행 모델이다.
이 장치들은 “다음에 무슨 코드가 올지 모른다”는 문제를 풀기 위해 존재한다. DNN accelerator는 반대로 workload를 좁혀버린다. 복잡한 instruction window 대신 수백~수천 개의 단순한 PE와 명시적인 buffer, predictable한 dataflow를 택한다. 유연성을 덜 사고 그 면적을 MAC과 SRAM에 쓴다.
DNN Accelerator Design Space
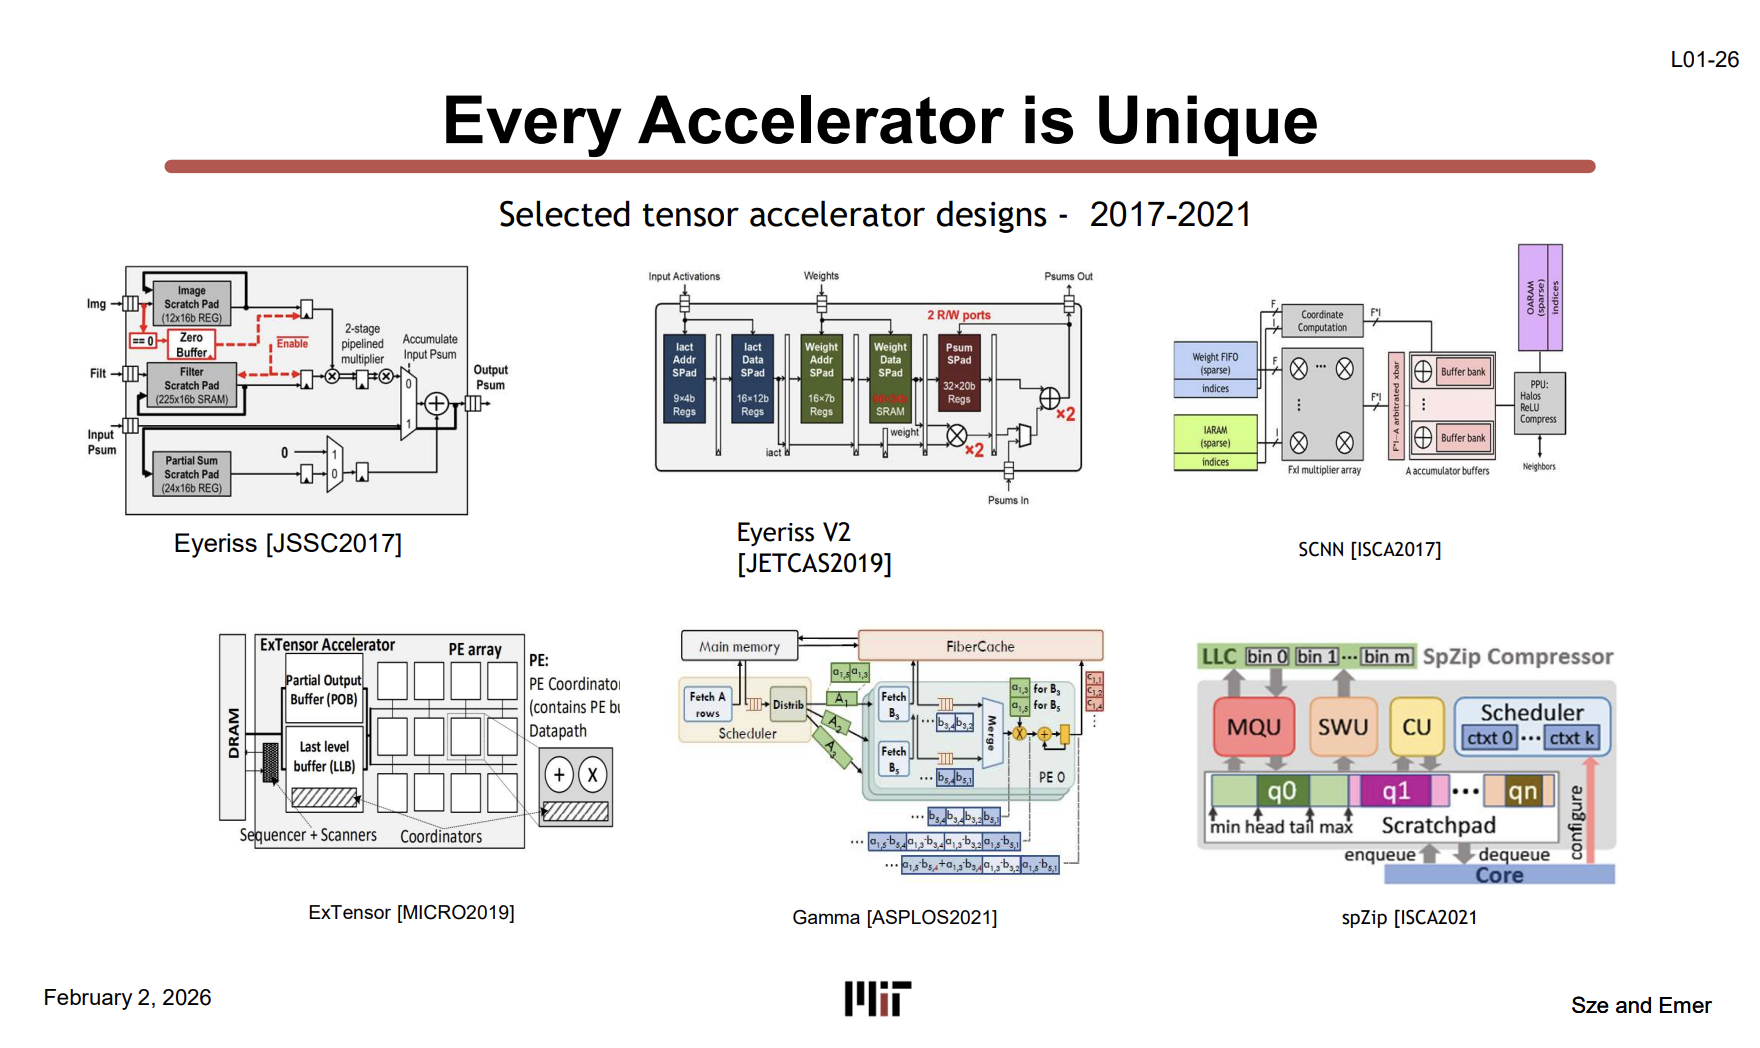
여기서부터 수업의 본론이 시작된다. “DNN accelerator”라고 부르면 다 비슷한 systolic array일 것 같지만 실제로는 꽤 다르다.
Eyeriss는 CNN inference와 data reuse에 맞춘 spatial array다. SCNN은 sparse CNN의 0을 건너뛰는 데 초점을 맞춘다. ExTensor와 Gamma는 sparse tensor와 sparse matrix의 irregular한 access를 다루기 위해 서로 다른 network와 scheduling을 쓴다. workload가 dense인지 sparse인지, CNN인지 attention인지에 따라 PE 배치, interconnect, buffer, 데이터 순회 순서가 전부 갈린다.
CPU pipeline은 큰 틀이 표준화돼 있다. accelerator 쪽은 논문 두 편만 읽어도 서로 쓰는 용어와 그림이 달라진다. 비교가 어렵다. TeAAL이 등장하는 자리가 여기다.
TeAAL Pyramid of Concerns
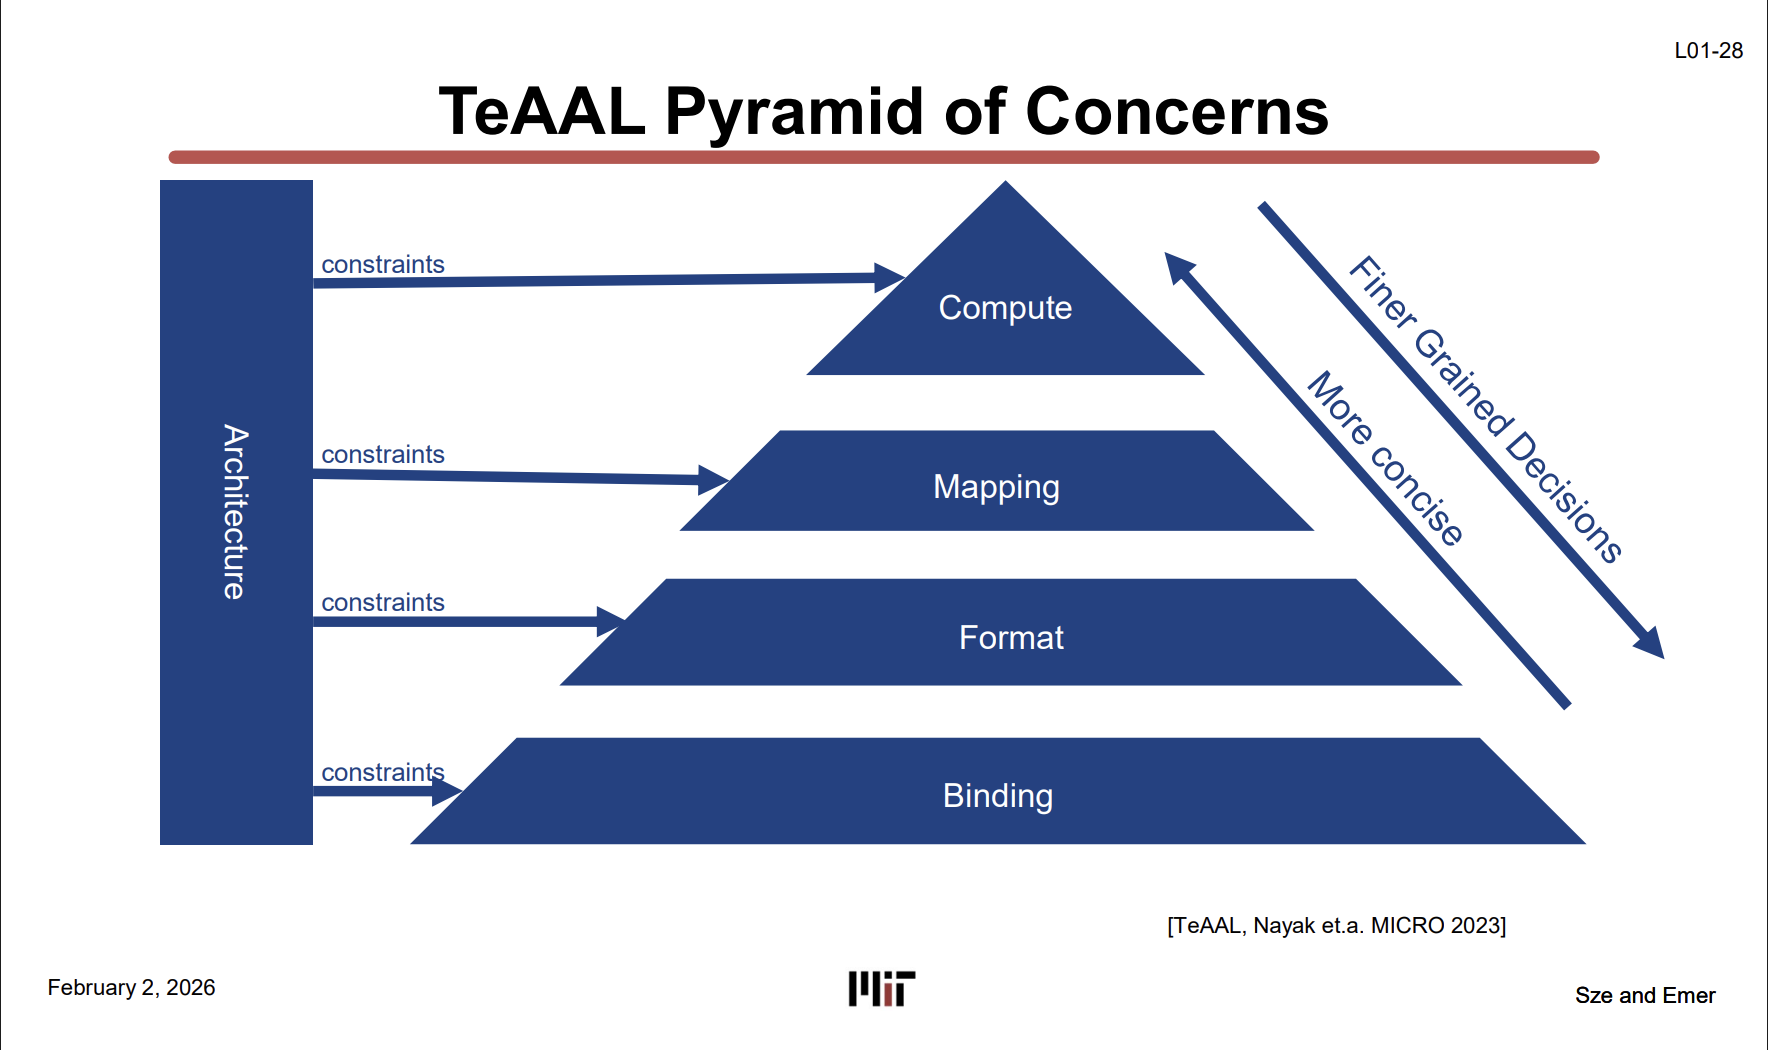
TeAAL은 tensor algebra accelerator를 한 덩어리의 블록 다이어그램으로 보지 않고 네 종류의 결정으로 나눈다.
| 층 | 묻는 질문 |
|---|---|
| Compute | 무슨 tensor 연산을 하는가. MatMul인가, attention인가 |
| Mapping | iteration space를 어떤 순서와 병렬성으로 순회하는가 |
| Format | tensor를 dense, CSR 같은 어떤 형태로 저장하는가 |
| Binding | 계산과 데이터를 실제 PE·buffer·network 어디에 붙이는가 |
이렇게 나누면 “빠르다”를 쪼개서 말할 수 있다. 수식은 같은데 loop order가 달라서 traffic이 늘었는지, sparse format이 문제인지, PE에 일이 고르게 안 나뉜 건지 따로 잡아낼 수 있다.
FuseMax: Compute, Mapping, Binding
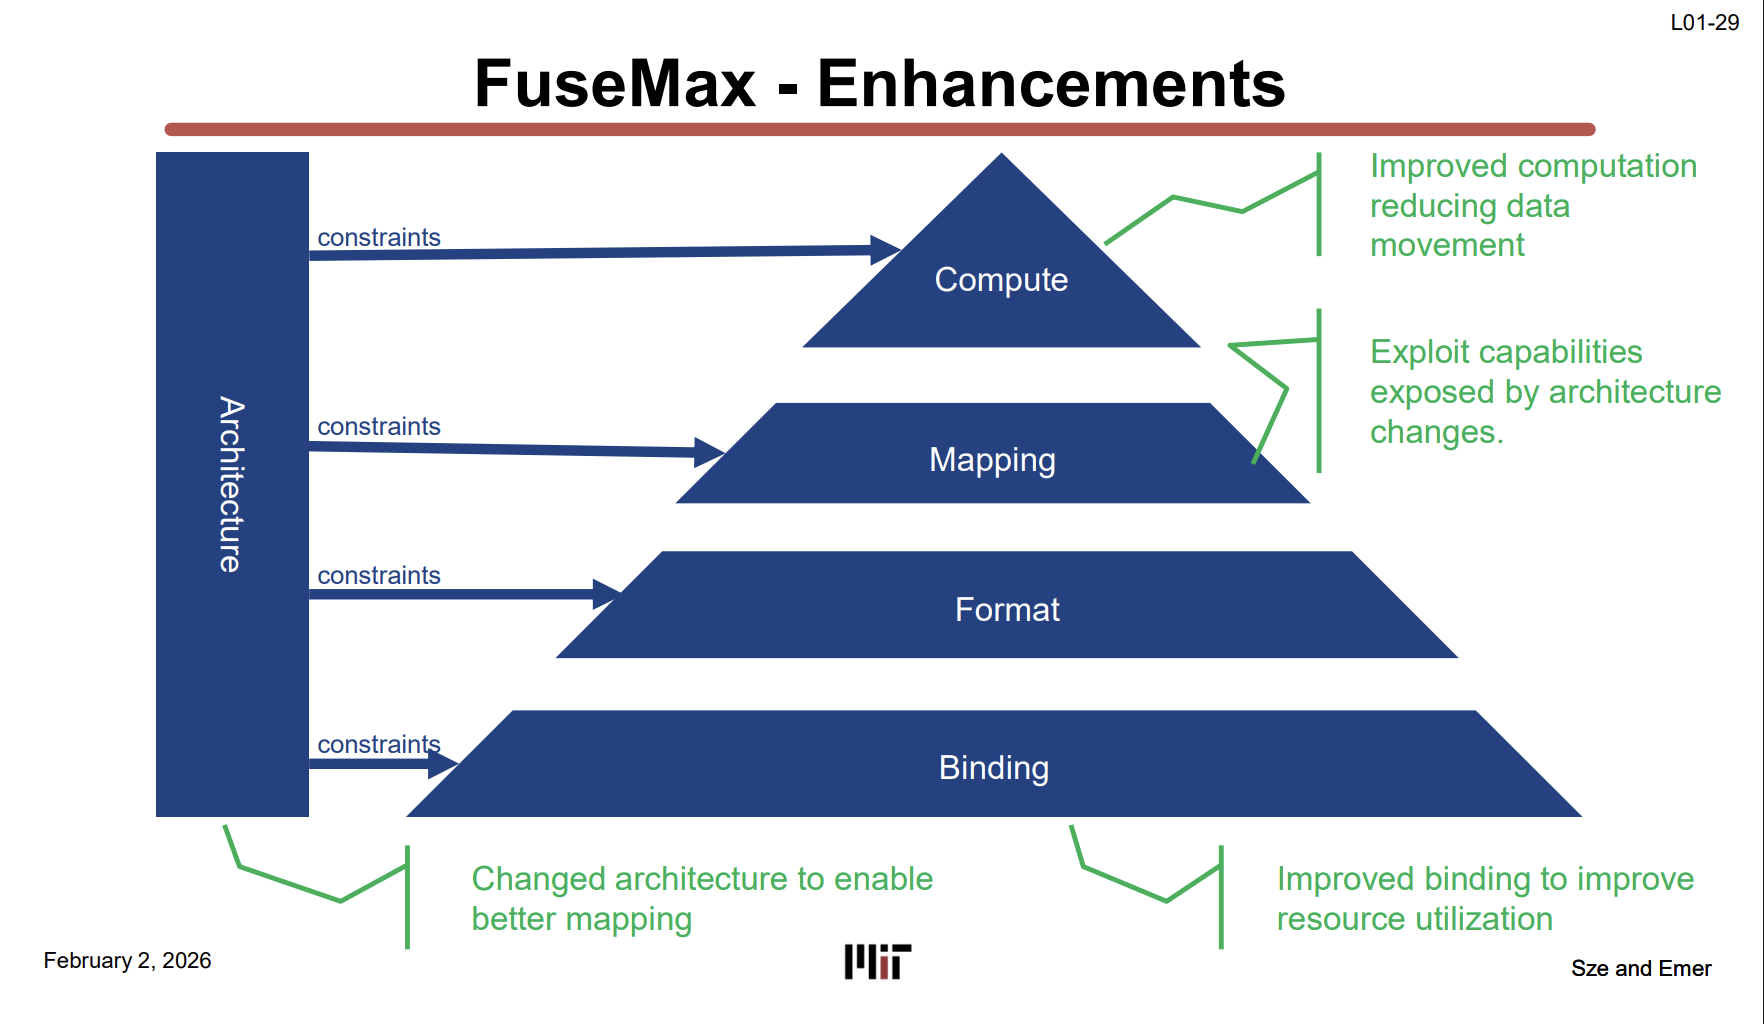
FuseMax는 Transformer attention의 낮은 PE utilization을 끌어올린 사례다. QK matmul, softmax, V matmul을 따로 실행하면 각 단계의 중간 결과를 메모리에 쓰고 다시 읽는다. Cascade는 이 연산들을 더 강하게 fuse해 중간 traffic을 줄인다. 그런데 fusion만 했다고 PE가 곧바로 꽉 차지는 않는다. 새 mapping을 받을 수 있도록 architecture를 바꾸고, 실제 자원 배치를 다듬어야 utilization이 90% 근처까지 올라간다.
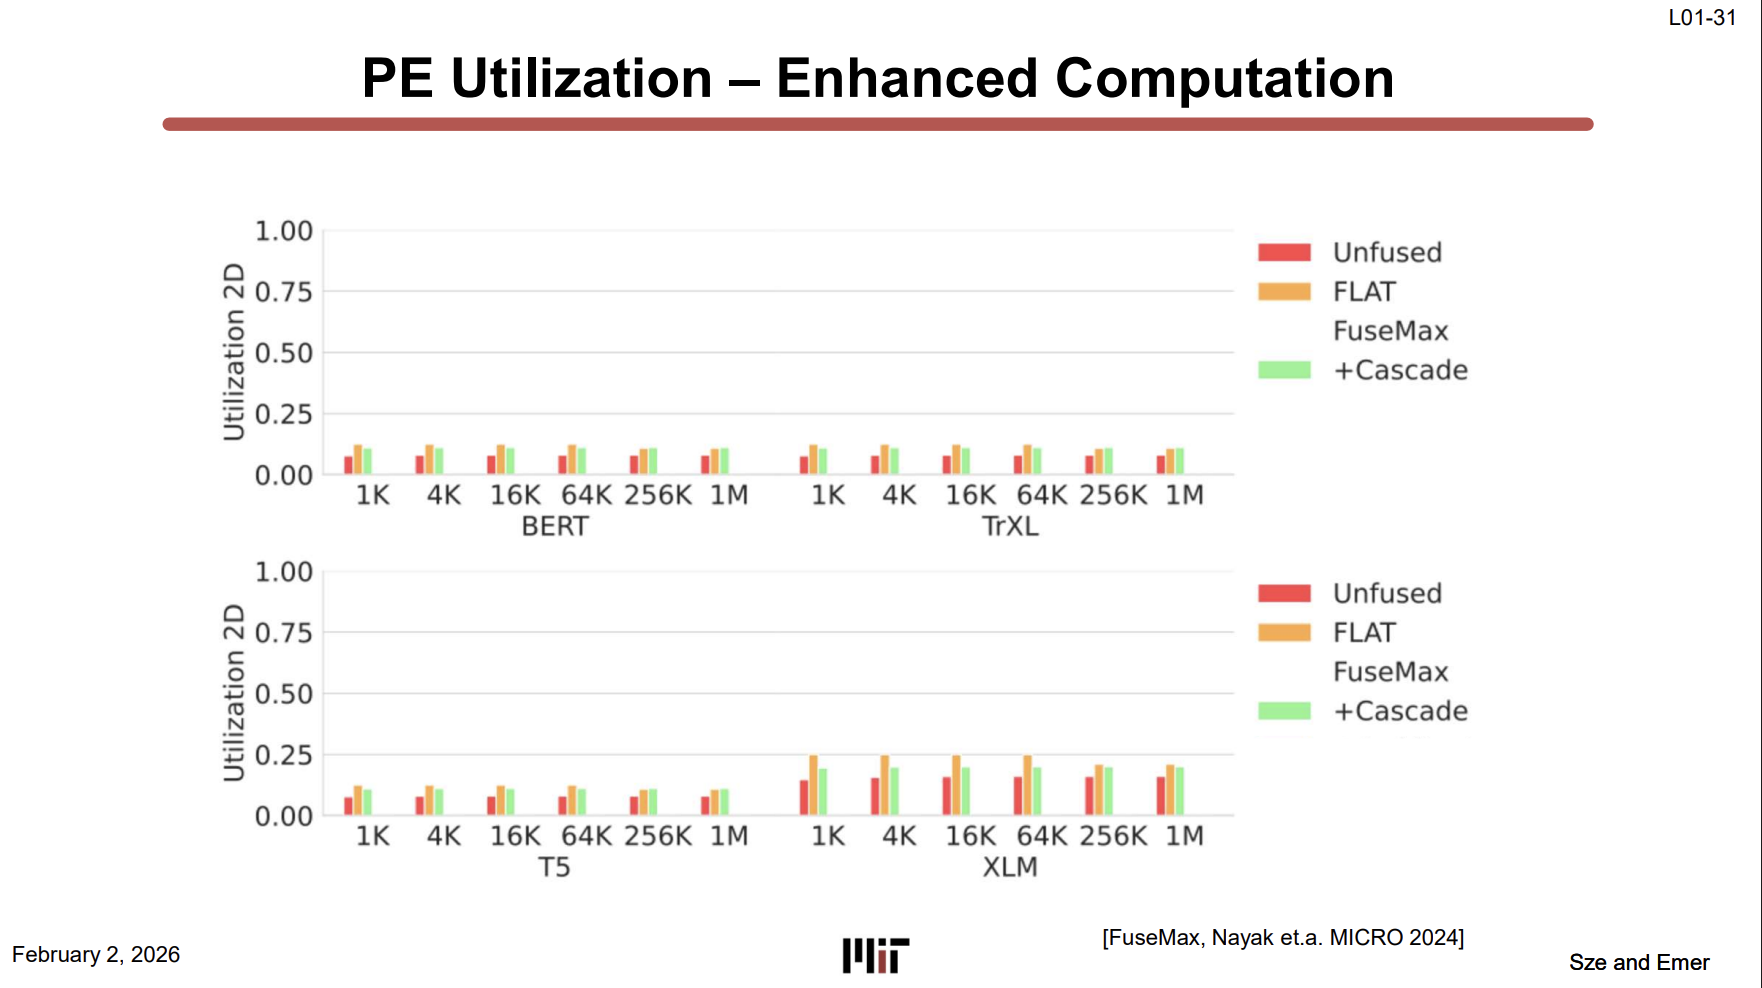
이 그래프에서 재미있는 건 baseline이 나쁜 이유가 “MAC이 느려서”가 아니라는 점이다. PE는 이미 많다. 일이 잘게 나뉘고 이동하고 배치되는 방식이 어긋나서 대부분 놀고 있었다. accelerator 성능을 peak TOPS만 보고 판단하면 놓치는 부분이다.
DNN Accelerator Architecture
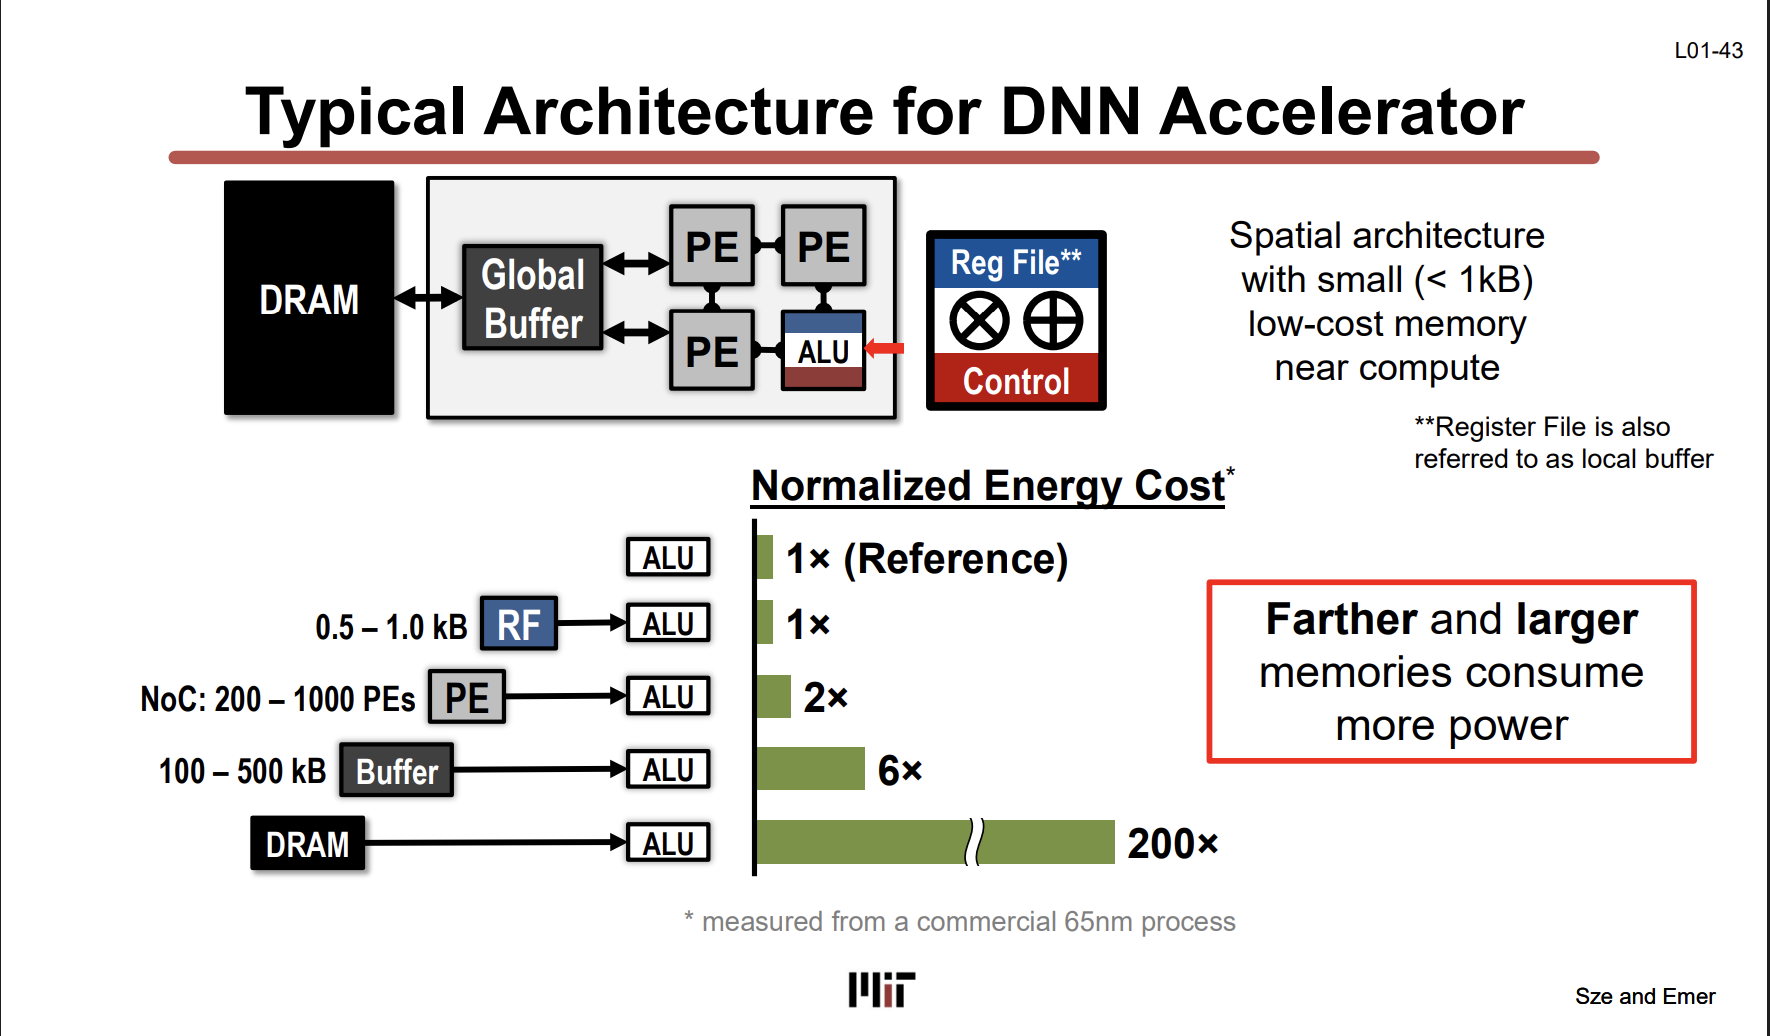
전형적인 구조는 DRAM - global buffer - NoC - PE local register file - ALU로 내려간다. PE 자체는 multiplier와 adder, 작은 register file, 간단한 control 정도다. 화려한 연산기보다 데이터를 어디에 얼마나 오래 붙잡아둘지가 더 큰 설계 문제다.
슬라이드의 65nm normalized energy 예시는 이 우선순위를 아주 세게 보여준다.
| 데이터 위치 | 상대 비용 |
|---|---|
| ALU 연산 | 1× |
| PE 내부 register file | 1× |
| PE 간 NoC | 2× |
| Global buffer | 6× |
| DRAM | 200× |
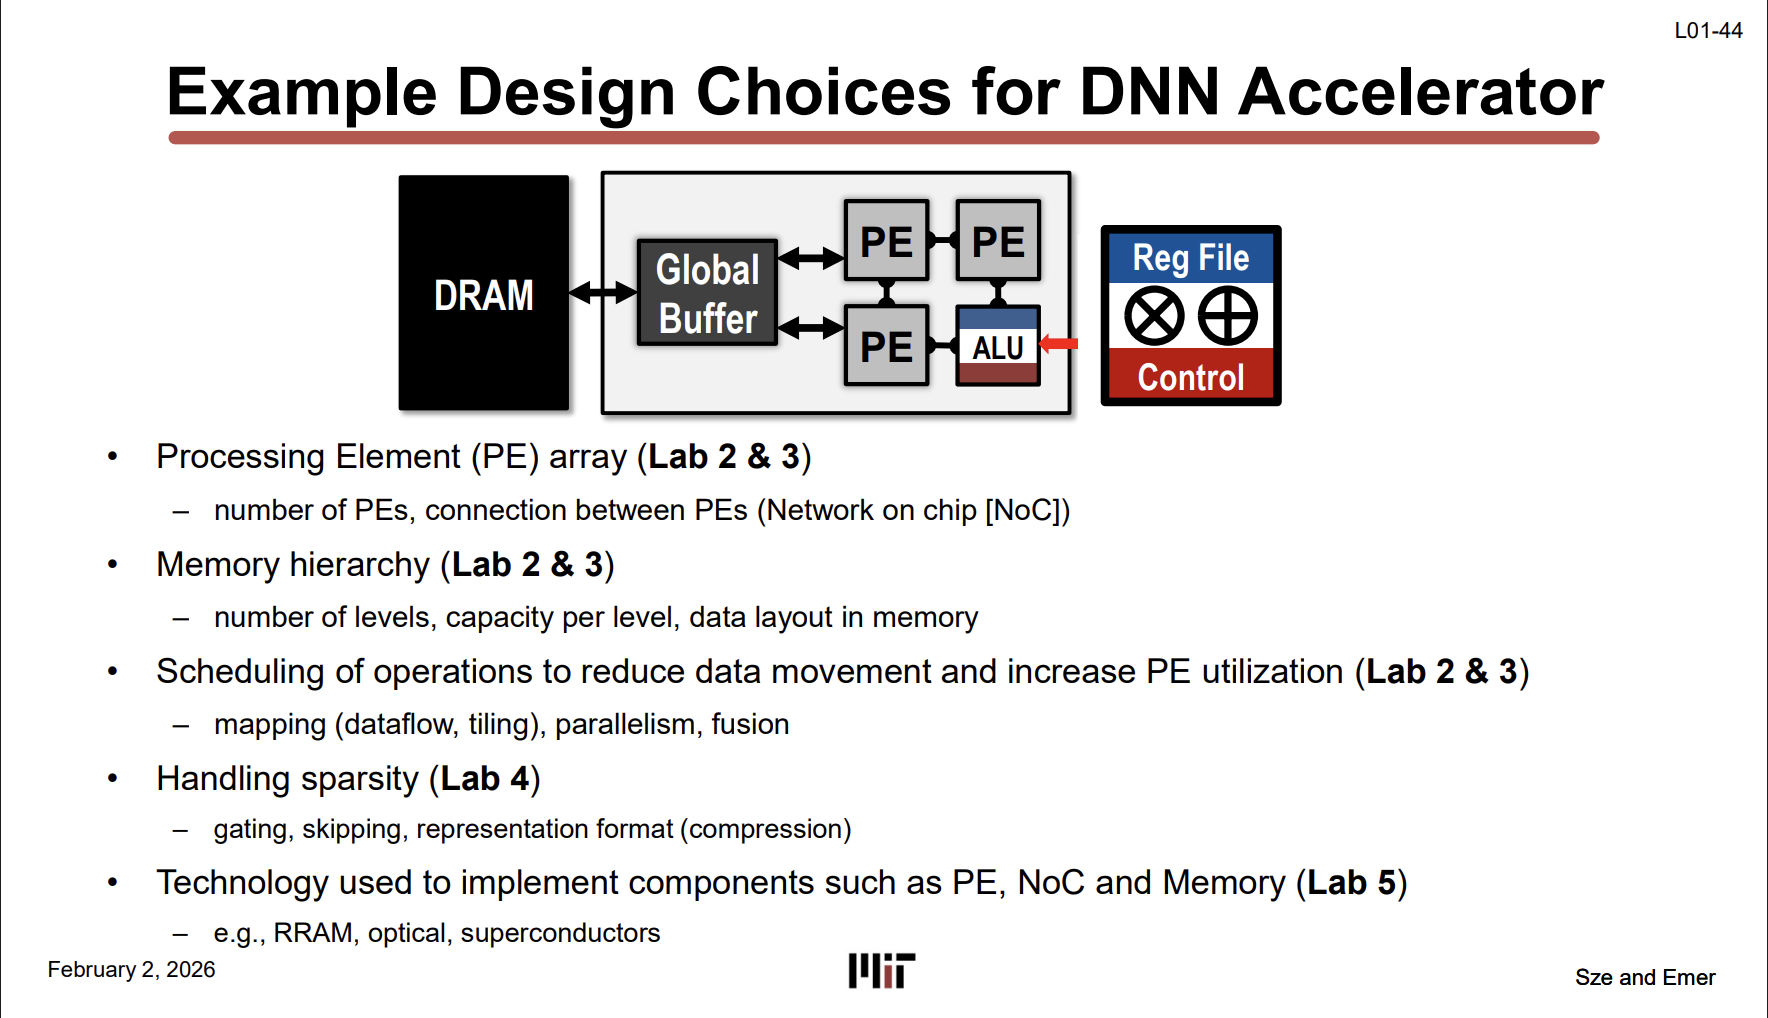
그래서 설계 변수도 PE 개수로 끝나지 않는다. memory hierarchy의 깊이와 용량, tiling, loop order, parallelism, fusion, sparse zero를 건너뛰는 방법까지 함께 골라야 한다.
Roofline Model
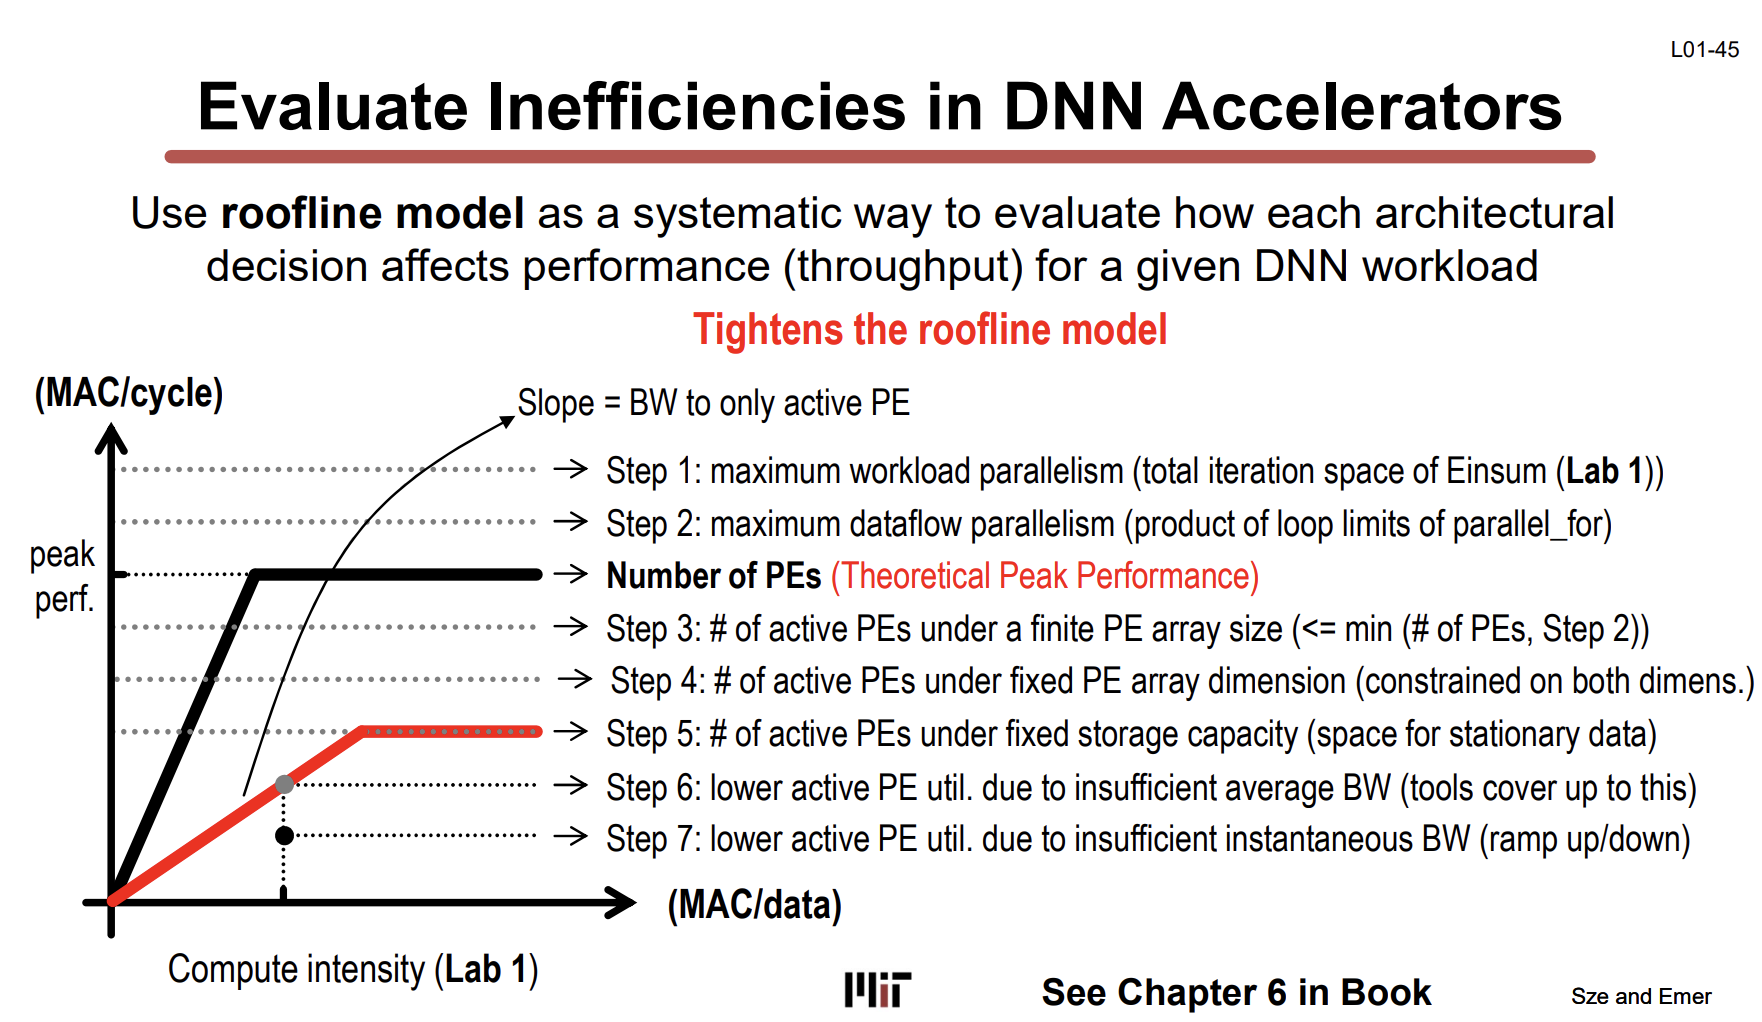
Roofline은 성능이 compute에 막혔는지 memory bandwidth에 막혔는지 보는 모델이다. x축은 compute intensity, 즉 가져온 데이터 하나로 얼마나 많은 연산을 했는가다. y축은 throughput이다.
왼쪽 사선 구간에서는 데이터를 충분히 못 가져와 memory-bound다. 여기서 PE를 더 붙여도 놀기만 한다. 오른쪽 평평한 구간에서는 연산기의 peak throughput이 한계다. 이때는 bandwidth를 더 줘도 위로 못 올라간다.
L01의 Step 1~7은 theoretical peak에서 실제 성능이 깎이는 과정을 쪼갠다. workload가 가진 병렬성, dataflow가 노출하는 병렬성, 유한한 PE array와 buffer, 평균·순간 bandwidth를 차례로 반영한다. “이 accelerator는 100 TOPS인데 왜 20 TOPS밖에 안 나오지?”라는 질문에 peak spec 대신 병목의 위치로 답하는 방식이다.
칩 이름보다 먼저 이 정의를 잡아두면 된다. DNN accelerator는 MAC을 많이 박은 칩이 아니다. 어떤 tensor 계산을, 어떤 순서로, 어떤 데이터 표현을 써서, 어느 메모리와 PE에 배치할지 정하는 기계다. 연산은 그 결정들의 마지막에 있다.
L02에서는 이걸 더 작은 단위로 내린다. tensor와 Einsum으로 workload를 쓰고, iteration space와 memory traffic을 계산한 뒤, CNN과 fully connected layer가 실제로 어떤 tensor 연산이 되는지 본다.